预注册测试翻车:4B模型替换12B,故障注入回归门禁把我自己的预测打脸了

预注册实验推翻作者预测:小模型替换大模型未通过故障注入回归门禁。
ARCI v2.0 为 LangChain 的 create_agent 增加了故障注入回归门禁,允许在同一任务集上对比基线与候选配置,并注入工具超时、报错和空结果三类故障。作者预注册实验,预测 4B 模型能替代 12B 模型,结果被 BLOCK:12B 通过 96/96,4B 通过 70/96,26 次失败中 23 次是同一行为(传入不存在的产品编码)。此外,小模型有时跳过查询步骤导致故障未触发,若不单独统计会高估其鲁棒性。该工具目前明确拒绝异步 Agent 等场景,结论仅适用于单次运行。
预注册测试翻车:4B模型替换12B,故障注入回归门禁把我自己的预测打脸了
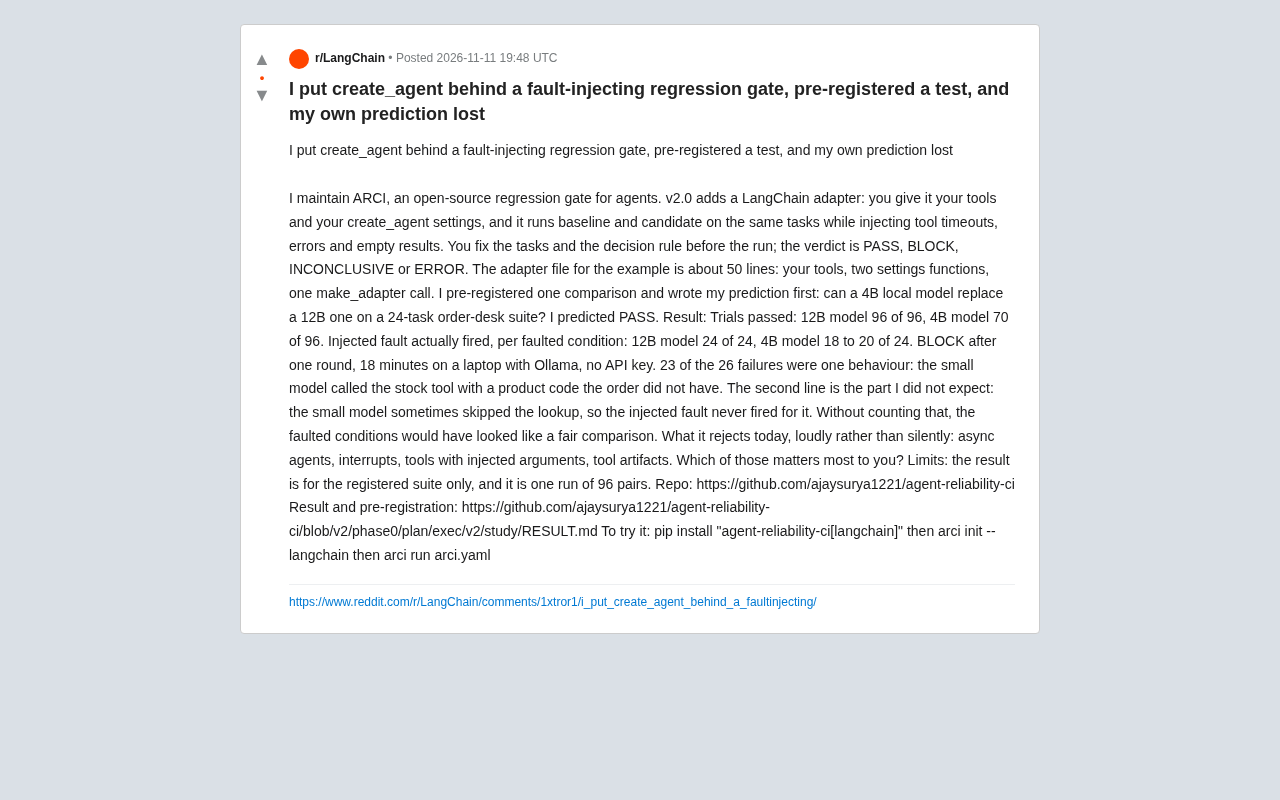
一位维护者给自己的 Agent 回归工具 ARCI 加了 LangChain 适配器,把 create_agent 放进故障注入回归门禁里跑。他在运行前先预注册了比较方案、写下了预测——然后预测输了。这篇帖子最有价值的地方不是"小模型不行",而是他用一个可复现的实验结构,把 Agent 选型里最容易被拍脑袋决定的那部分,变成了可以提前裁定 PASS / BLOCK 的问题。
ARCI v2.0 做了什么:给 create_agent 套上故障注入回归门禁
ARCI 是一个面向 Agent 的开源回归门禁。v2.0 的核心新增是 LangChain 适配器:你把自己的工具和 create_agent 的设置交给它,它会用同一批任务分别跑基线(baseline)和候选(candidate)两套配置,同时注入工具超时、工具报错和空结果这三类故障。
关键设计在于"先定规则,再跑实验":任务集和判定规则必须在运行之前固定下来,跑完只输出四种裁决之一——PASS、BLOCK、INCONCLUSIVE 或 ERROR。整个过程没有事后调参的空间,也不给你"再跑一次看看"的模糊地带。
适配成本也很低。示例里的适配器文件大约 50 行:定义你的工具、写两个 settings 函数、调用一次 make_adapter,就接上了。对已经在用 LangChain 搭 Agent 的团队来说,这个接入门槛接近"顺手加一道 CI 检查"。
故障注入(Fault Injection) 是一种通过人为向系统引入可控错误来主动测试其健壮性的方法。在 Agent 场景中,常见的故障类型包括:工具调用超时(模拟下游服务响应慢)、工具返回错误(模拟接口异常)、工具返回空结果(模拟数据缺失)。传统单元测试只验证“正常路径”,而故障注入强制模型在非理想条件下工作,能暴露模型对异常的感知与恢复能力。ARCI 将故障注入与回归门禁结合,意味着每次候选配置变更都必须通过同一套含故障的任务集,从而防止模型在“顺境”中表现良好但一遇异常就崩溃。
预注册(Pre-registration) 源于科学研究,指在实验开始前公开登记假设、方法和判定标准,以避免事后挑选有利结果。ARCI 将这一原则工程化:任务集和判定规则必须在运行前锁定,运行后只输出 PASS/BLOCK/INCONCLUSIVE/ERROR 四种裁决,杜绝了“跑完再调阈值”的作弊空间。这种做法在模型选型中尤其重要,因为它把主观争论转化为可复现的客观裁定,哪怕结果与作者预期相反,也值得信任。
被预注册的赌局:4B 能不能替 12B
作者在开跑之前就写下了自己的预测:用 4B 本地模型替换 12B 模型,在 24 个任务的"订单台"(order-desk)测试套件上,他认为会 PASS。
结果是被 BLOCK。
- 12B 模型:96 次试验通过 96 次。
- 4B 模型:96 次试验通过 70 次。
- 按故障条件统计的注入故障实际触发情况:12B 为 24/24,4B 为 18 到 20/24。
整个实验在一台笔记本上用 Ollama 跑完,耗时 18 分钟,不需要 API key。这个成本结构本身就是结论的一部分:把 Agent 回归门禁跑成日常流程,并不需要重型基础设施。
26 次失败里有 23 次是同一个行为
失败模式的集中度远超预期。26 次失败中,有 23 次是同一个错误:小模型在调用库存工具时,传入了一个该订单并不存在的产品编码。这不是"能力稍弱"那种弥散性差距,而是一个非常具体的、可以被单独盯住的失效点。
对工程实践的启示很直接:如果只看总通过率,你会得到"小模型差一截"的结论;但如果按失败行为聚类,你会得到一个可以写进 prompt、工具 schema 校验或单元测试的具体条目。回归门禁的价值,正在于把这种可操作的细节暴露出来,而不是给一个笼统的分数。
第二个发现:小模型偷懒,让故障根本没触发
作者特别强调这是他没预料到的部分:小模型有时会直接跳过查询步骤,于是注入的故障压根没有机会触发。
这带来一个隐蔽的统计陷阱——如果不把"故障是否真的触发"单独计数,故障条件下的对比会看起来像是一场公平较量。实际上,一部分"通过"可能是因为模型绕开了被测路径,而不是它正确处理了故障。这一点对任何做故障注入测试的人都是通用警告:注入动作本身需要被验证已执行,否则测试结果会系统性高估被测对象。
故障触发计数(Injection Trigger Verification) 是故障注入测试中一个容易被忽视的环节。当测试框架注入故障(如让工具超时)时,必须独立验证该故障是否真的被执行到。如果被测模型直接跳过了被注入故障的工具调用,那么故障就形同虚设,模型可能因为“绕开”而通过测试。ARCI 单独统计了故障实际触发次数,发现 4B 模型在 24 次故障条件下只触发了 18-20 次,而 12B 全部触发。若不单独计数,故障条件下的通过率会系统性高估小模型的鲁棒性,因为一部分通过源于未进入测试路径。对于任何做故障注入回归的团队,都应把“故障是否被激活”作为独立指标输出,否则对比结果将失真。
已知边界:它今天会明确拒绝什么
ARCI 目前对几类场景会大声报错而不是静默通过:异步 Agent、interrupts、带注入参数的工具、tool artifacts。作者的原话是"loudly rather than silently"——宁可拒绝,也不假装跑过。
作者也主动声明了结果的局限:结论只适用于这个已注册的测试套件,且只是 96 对试验的单次运行。单一运行意味着不能从中推导出统计显著性,只能作为一个方向明确的信号。
想自己复现的话:
pip install "agent-reliability-ci[langchain]"
arci init --langchain
arci run arci.yaml
仓库与预注册文档都在 GitHub 的 agent-reliability-ci 项目下,结果文件为 phase0/plan/exec/v2/study/RESULT.md。
为什么这件事值得关注
Agent 选型长期依赖演示、体感和榜单。这个实验提供了一个不同的范式:先把判定规则写死,再做对比,让"能不能换小模型"从一场争论变成一个会给出 PASS 或 BLOCK 的 CI 步骤。作者自己的预测被推翻,反而证明了这套结构的可信度——如果预注册的实验总能印证作者的直觉,那它多半只是直觉的装饰品。
相关推荐

Claude Mythos 5.2 与 Fable 5.2 错误率异常升高
Claude Mythos 5.2 和 Claude Fable 5.2 出现请求错误率异常升高,官方状态页已标记为调查中。本文梳理事件概况、对开发者的实际影响及应对建议。

ReAct运行时上下文裁剪:Claude Code为何70%就动手
深入解析ReAct运行时的上下文裁剪机制:为什么Claude Code在上下文使用约70%时就触发压缩,工具调用为何占用最多、为何必须成组丢弃,以及代码库为何不需要RAG。基于B站小福哥《分币不掏,学习AI Agent开发》第17节整理。

AI Agent vs LLM:Cursor和Claude Code如何真正工作
深入解析AI Agent与LLM的本质区别:LLM生成代码建议,Agent则通过工具调用修改文件、运行测试。以Spring Boot Bug修复为例,拆解Cursor和Claude Code的工作流、权限控制与验证机制。