元认知解码:扩散语言代理的高效推理新范式
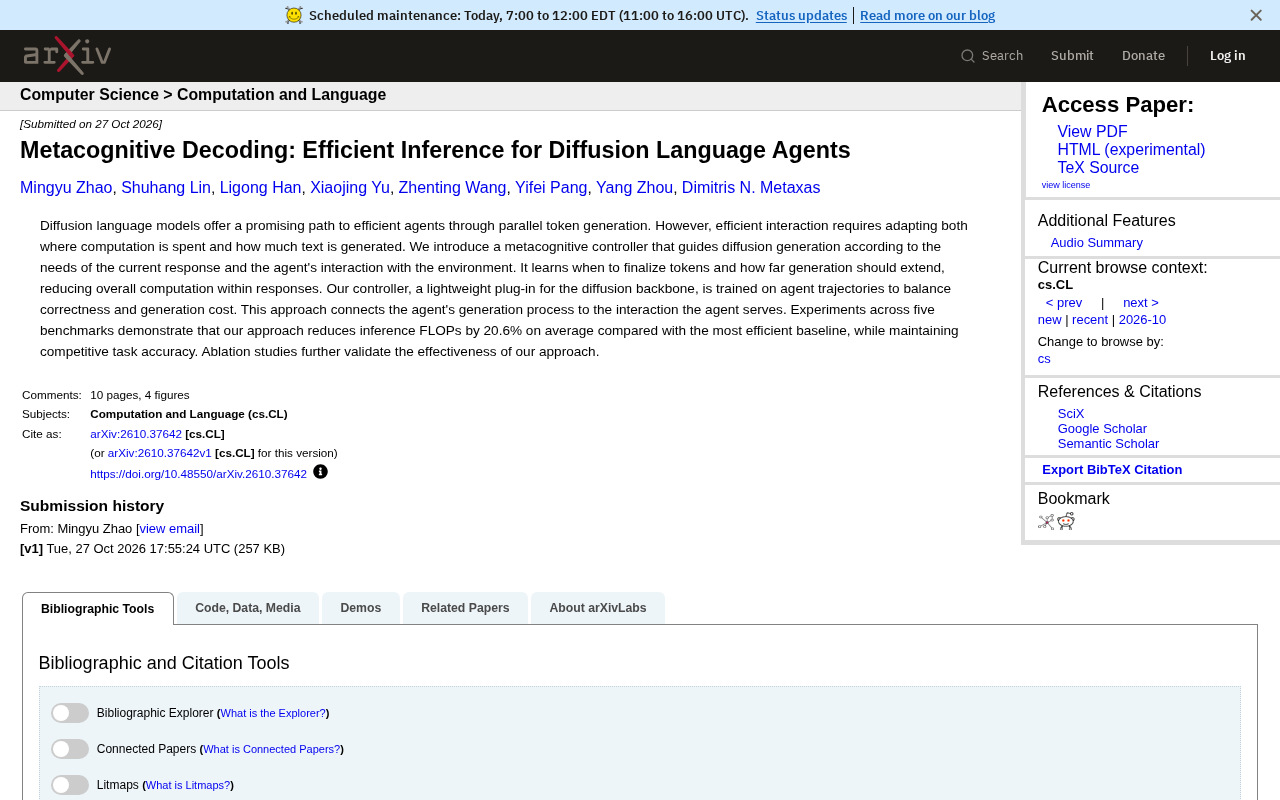
轻量级元认知控制器动态决定扩散语言代理的token最终化与生成长度,平均省20.6%推理FLOPs。
本文针对扩散语言模型在智能代理任务中的效率瓶颈,提出一种轻量级元认知控制器。该控制器作为插件嵌入扩散主干,通过分析去噪状态和交互历史,动态预测token最终化时机与生成长度,从而在正确性和计算成本之间取得平衡。在五个基准测试上,该方法平均减少20.6%的推理FLOPs,同时保持有竞争力的任务准确率,且与现有扩散加速技术正交、可叠加使用。这一工作将生成过程与代理交互目标直接耦合,为构建低延迟、高响应的智能代理提供了新思路。
扩散语言模型通过并行生成token为高效智能代理开辟了新路径,但高效交互不仅需要控制计算资源的分配,还需动态调整生成文本的长度。本文介绍的元认知控制器(Metacognitive Controller)正是针对这一挑战的轻量级解决方案。
扩散语言代理的效率瓶颈
传统自回归语言模型逐个生成token,推理延迟随输出长度线性增长,这在对实时性要求高的代理任务中成为瓶颈。扩散语言模型则通过并行去噪过程同时生成多个token,有望大幅降低推理时间。然而,并行生成并不意味着计算浪费的终结——模型仍需在每一步去噪中处理全部序列位置,且生成过长或过短的文本都会影响代理与环境的交互效率。
现有加速方法多集中于减少去噪步数或优化采样策略,却较少关注“何时停止生成”这一决策。对于代理任务而言,答案的完备性往往取决于环境反馈,而非固定长度。例如,在需要调用工具的场景中,过早结束生成可能导致信息缺失,而过晚结束则浪费算力。因此,一个能够根据任务复杂度动态调节生成深度的机制至关重要。
扩散语言模型(Diffusion Language Model)借鉴了图像生成中的扩散思想:从完全噪声的序列出发,通过多步去噪逐步恢复出文本。与自回归模型从左到右逐个生成不同,扩散模型在每一步可以同时更新所有位置的token表示,因此具备并行生成的潜力。其推理过程通常包括固定步数的去噪迭代,每一步都对整个序列进行变换,最终得到完整输出。这种并行性使得生成延迟不再严格随输出长度线性增长,但也带来了新的计算开销——每一步都需要处理全部位置,且去噪步数本身可能成为瓶颈。理解这一机制有助于把握为何“何时停止”在扩散语言模型中是一个独立且重要的优化维度。
元认知控制器的设计思路
该控制器的核心思想是让模型学会“元认知”:即对自身生成过程进行监控和调节。具体而言,它作为一个轻量级插件嵌入扩散主干网络,通过分析当前去噪状态和代理与环境的交互历史,预测两个关键决策:是否应最终确定当前token,以及生成应延伸到多远。
训练过程中,控制器在代理轨迹上进行优化,目标是在正确性和生成成本之间取得平衡。这类似于让模型学会“何时思考”与“思考多久”。由于插件结构轻量,它不会显著增加模型参数量,却能带来实质性的计算节省。
元认知(Metacognition)在认知科学中指个体对自身思维过程的监控与调节,例如判断自己是否已经掌握足够信息来回答问题。在机器学习中,这一概念被引申为模型对自身推理状态进行自我评估的能力。元认知控制器不直接生成token,而是观察主干网络的中间状态(如去噪步的置信度分布、隐藏层激活)以及代理与环境的交互历史,输出两个决策信号:当前token是否已足够确定可以最终化,以及是否应继续生成更多token。这种设计将“生成”与“控制”解耦,控制器本身参数极少,训练时通过强化学习或可微决策目标在代理轨迹上优化,从而在正确性与计算成本之间取得平衡。
实验效果与验证
研究者在五个基准测试上评估了该方法。与最高效的基线相比,元认知控制器平均减少20.6%的推理FLOPs,同时保持有竞争力的任务准确率。消融实验进一步证实了控制器各组件的有效性。
这一结果意味着,在代理场景中,通过动态分配计算资源,扩散语言模型可以在不牺牲性能的前提下显著提升效率。尤其说个细节,该方法与现有的扩散加速技术正交,可叠加使用。
FLOPs(Floating Point Operations,浮点运算次数)是衡量神经网络推理计算量的常用指标,与延迟和能耗高度相关。在扩散语言模型中,推理FLOPs主要来自去噪步数与序列长度的乘积。减少20.6%的FLOPs意味着在相同硬件上可以处理更多请求或降低单次推理能耗。消融实验(Ablation Study)通过逐一移除或替换控制器中的组件(如交互历史编码、置信度预测头等),验证每个部分对最终性能的贡献,从而排除“整体有效但部分冗余”的可能。这些评估方法共同支撑了控制器设计的合理性。
对代理系统设计的启示
元认知解码将代理的生成过程与其服务的交互目标直接关联。传统上,生成模型和代理策略是分离的,而该方法通过控制器将两者耦合,使生成更贴合实际需求。这为构建低延迟、高响应的智能代理提供了新思路:模型不仅要知道“怎么生成”,还要学会“何时停止”。
未来,这种元认知机制或许可扩展到多模态代理或更复杂的决策场景,进一步推动高效推理的发展。
相关推荐
VCP V工程实测:Token缓存95%命中,AI控制AI螺旋编程
VCP V工程实测:单轮对话Token缓存命中率95%以上,用AI控制AI实现螺旋编程,主控Agent策划、施工Agent写码,已策划工程可完全脱手。附完整配置步骤与局限分析。
Agentic RAG实战:从原理到代码,手把手搭建智能检索系统
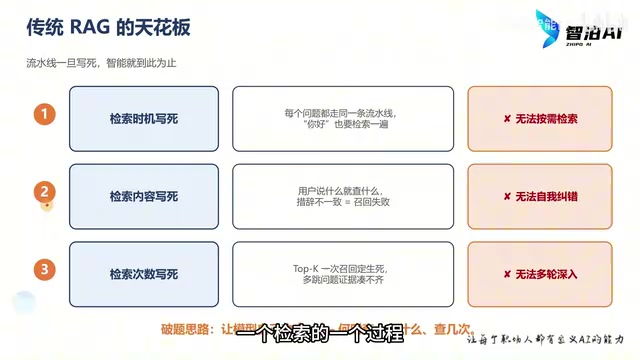
传统RAG检索时机、内容、次数全部写死,导致答非所问。本文基于B站教程拆解Agentic RAG原理:将检索封装为工具交给大模型自主决策,附四工具设计与完整代码实现,手把手搭建能自我纠错、多跳查询的智能检索系统。
1小时搞懂Agentic AI:架构、设计模式与实战搭建
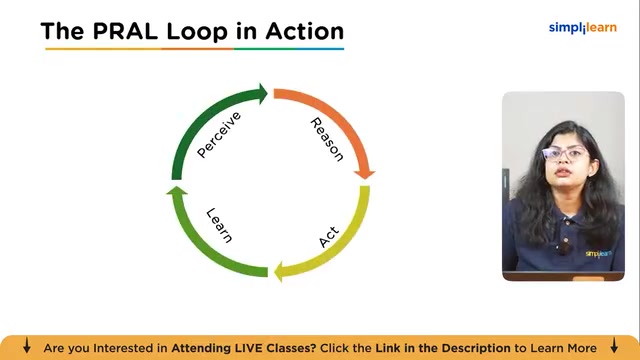
Simplilearn的Agentic AI速成课程解析:智能体三层架构(感知、认知、动作)、单智能体与多智能体对比、感知推理执行学习循环、三种设计模式,以及研究智能体、应用构建和反馈修复循环的实战演示。