元认知引导:从科学家判断中学习控制大模型推理
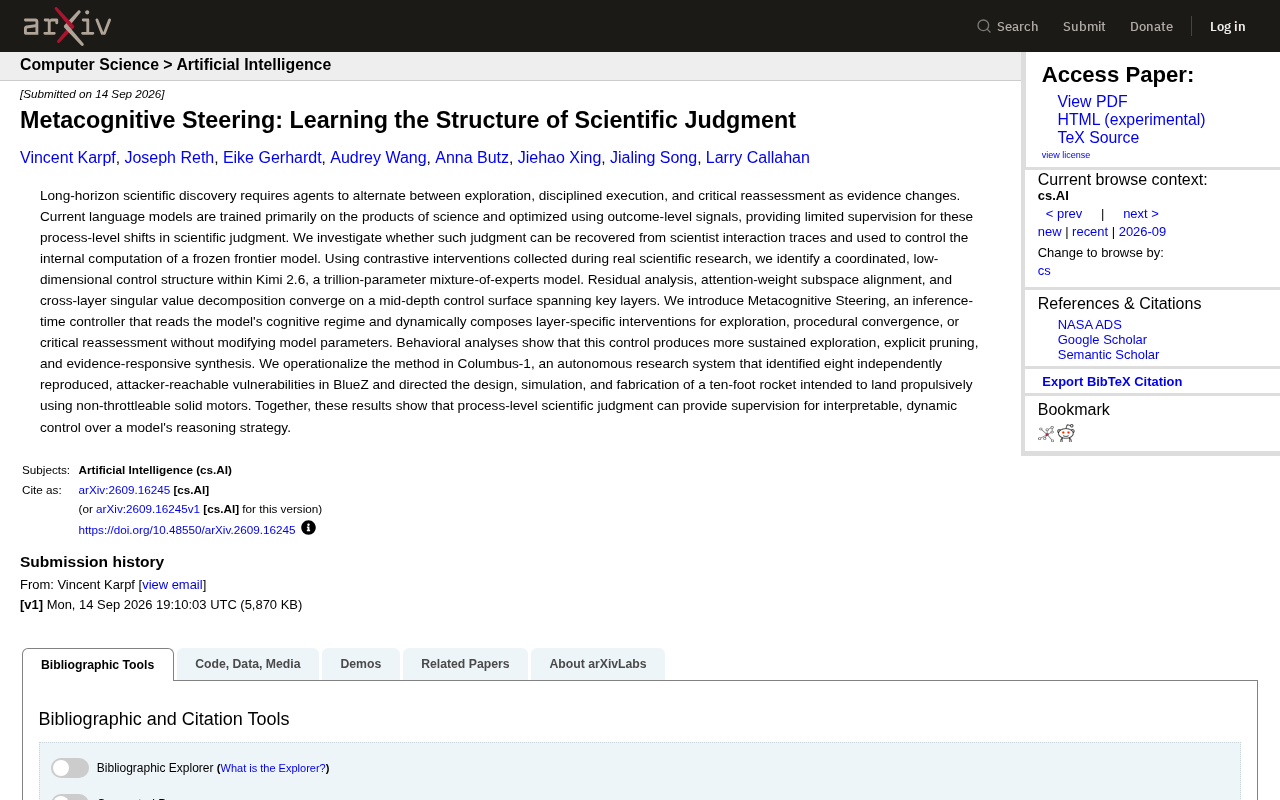
Metacognitive Steering通过定位大模型内部低维控制面,在推理时动态引导科研判断的探索、收敛与重估过程。
现有大模型只学习了科学的"产物"——论文、结论与代码——却缺乏对科研"过程"中判断切换的监督。这篇arXiv论文提出Metacognitive Steering方法,从科学家真实交互轨迹中提取对比性干预信号,并借助残差分析、注意力子空间对齐和跨层SVD,在万亿参数MoE模型Kimi 2.6中定位到一个横跨中间若干层的低维控制面。该控制面对应人类可理解的"探索、程序性收敛、批判性重估"三种认知模式,推理时控制器可在不修改参数的前提下动态组合分层干预以引导推理策略。落地系统Columbus-1在Linux蓝牙协议栈BlueZ中发现8个可复现漏洞,并主导完成了固体发动机火箭反推着陆的设计与仿真,为该方法的通用性提供了跨领域的实证支撑。
长周期的科学发现,需要研究者在探索、严谨执行与批判性重估之间反复切换。这种随证据变化而调整判断的能力,恰恰是当前语言模型的短板——它们主要学习的是科学的"产物",并用结果层面的信号优化,缺乏对这种"过程层面"判断转变的监督。一篇最新的 arXiv 论文提出了名为 Metacognitive Steering(元认知引导) 的方法,试图从科学家真实的交互轨迹中恢复这种判断,并用它来控制一个冻结的前沿大模型的内部计算。
问题:模型学会了科学结论,却没学会科学判断
论文的核心洞察在于区分"科学的产物"与"科学的过程"。现有大模型在训练时几乎只接触已完成的论文、结论与代码,优化目标也停留在最终答案对不对(outcome-level signals)。但真正的科研工作是一个动态过程:什么时候该继续发散探索、什么时候该收敛到纪律性执行、什么时候又该推翻假设重新评估。
这些"过程级"的切换,很难从静态的科学成果中习得。研究者提出的思路是:从科学家在真实研究中留下的交互轨迹(interaction traces)里,把这种判断结构抽取出来,进而用于引导模型的推理策略。
方法:在万亿参数模型中找到低维"控制面"
研究团队以 Kimi 2.6 这一万亿参数的混合专家(MoE)模型为对象,通过在真实科研过程中收集的对比性干预(contrastive interventions),在模型内部识别出一个协调的、低维的控制结构。
为了定位这个结构,论文采用了多种分析手段交叉验证:
- 残差分析(Residual analysis)
- 注意力权重子空间对齐(attention-weight subspace alignment)
- 跨层奇异值分解(cross-layer SVD)
三种方法共同指向了一个横跨若干关键层的中层深度控制面(mid-depth control surface)。也就是说,模型对"当前处于哪种认知模式"的表征,并非弥散在整个网络中,而是集中在中间若干层,这为干预提供了可操作的落点。
混合专家模型(Mixture of Experts,MoE)是一种将大模型参数分割为多个"专家"子网络的架构,推理时只激活其中一小部分,从而在保持总参数量庞大的同时控制计算成本。Kimi 2.6 的万亿参数规模即采用此架构。在 MoE 模型中定位控制面尤为复杂,因为不同输入会经过不同专家路径,导致表征分布更为异质。论文能在这种动态路由的背景下仍然找到一个跨层一致的低维结构,说明元认知状态的编码并非绑定于特定专家,而是一种更具全局性的表征属性。
跨层奇异值分解(SVD)是这一发现的关键工具:通过对不同层激活矩阵做奇异值分解并比较主方向的对齐程度,可以检验某种"方向性信号"是否跨层稳定存在。若多层的主奇异向量高度对齐,则意味着模型在这些层之间传递着一致的隐状态信息——这正是"低维控制面"这一说法的数学依据。
核心机制:推理时动态组合分层干预
Metacognitive Steering 本质上是一个推理时(inference-time)控制器,它有两个关键动作:
- 读取模型当前的认知状态——判断模型此刻处于探索、程序性收敛,还是批判性重估的模式;
- 动态组合分层干预——针对不同层施加对应于探索、收敛或重估的干预,从而引导推理方向。
最关键的一点是:整个过程不修改模型参数。这意味着它不同于微调,而是一种可解释、可控且即插即用的引导方式。行为分析显示,经过这种控制的模型表现出更持续的探索、更明确的剪枝(explicit pruning),以及对证据更敏感的综合能力(evidence-responsive synthesis)。
推理时干预(inference-time intervention)是近年来可控生成研究中的一个重要范式,与微调(fine-tuning)和提示工程(prompt engineering)并列为操控模型行为的三条主要路径。其基本思路是:在前向传播过程中,直接修改特定层的激活值,将其沿预先计算好的"目标方向"偏移,而无需更新任何参数。这一方向通常通过对比性样本对(contrastive pairs)提取——例如,同一场景下"探索模式"与"收敛模式"的激活差异向量。Metacognitive Steering 的创新在于将这一静态干预扩展为动态的、多方向组合控制:系统实时读取当前激活状态,判断当前认知模式,再决定向哪个方向、以多大强度施加干预,使得模型可以在同一推理链中按需切换策略,而非被锁定在单一风格中。
实证:Columbus-1 自主科研系统的两项成果
论文并没有停留在机制解释,而是把方法落地到了一个名为 Columbus-1 的自主研究系统中,并给出了两个颇具说服力的案例:
- 安全漏洞发现:系统在 Linux 蓝牙协议栈 BlueZ 中识别出 8 个可被独立复现、且攻击者可触达的漏洞。
- 工程设计:系统主导设计、仿真并制造了一枚十英尺高的火箭,其目标是使用不可调节推力的固体发动机实现动力反推着陆——这是一个对判断力和过程控制要求极高的复杂工程任务。
这两个案例分别覆盖了软件安全与硬件工程,跨度极大,用以证明该控制方法在真实、长周期任务中的通用性。
BlueZ 是 Linux 内核官方的蓝牙协议栈实现,广泛存在于桌面 Linux 发行版及嵌入式设备中,其代码库庞大且涉及多种复杂协议解析逻辑,历史上已有多个高危漏洞被披露(如 BleedingTooth 系列)。在安全研究领域,自动化漏洞发现通常依赖覆盖制导的模糊测试工具(如 syzkaller、AFL++),这类工具对代码覆盖率有系统性保障,但对需要跨函数、跨协议层推理的逻辑漏洞效果有限。论文声称 Columbus-1 发现的 8 个漏洞均"可被独立复现且攻击者可触达",若后续经过 CVE 分配与社区复现验证,将是自主科研系统在真实安全任务上为数不多的有力证据;但目前作为预印本,具体漏洞类型、复现细节及与现有工具的对比基准尚待公开。
意义与思考
这项工作的价值在于给出了一条不同于"堆数据、扩规模、做微调"的路径。它表明:过程级的科学判断,本身可以作为一种监督信号,用来对模型的推理策略进行可解释、动态的控制。
从可解释性角度看,能在万亿参数模型中定位一个低维控制面,并对应到人类可理解的"探索/收敛/重估"认知模式,是一个有意思的发现——它暗示大模型的高层认知行为可能比想象中更有结构。
当然,作为一篇新发布的预印本,其结论仍需更多复现与检验。案例虽然抢眼,但"火箭反推着陆"这类描述的具体完成度、以及漏洞发现相对传统模糊测试工具的增量优势,都值得后续更细致的评估。总体而言,它为"如何监督模型的科研判断力"提供了一个新颖且可操作的框架。
相关推荐
Ollama 入门指南:本地部署开源大模型的利器
Ollama 是一款免费开源的本地大模型管理工具,支持将 DeepSeek 等开源模型部署到本地。本文介绍 Ollama 是什么、跨平台特性、CPU/GPU 支持及本地部署的应用场景,适合零基础入门 AI 大模型开发。
LM Studio、Ollama、vLLM深度对比:本地大模型部署工具怎么选
LM Studio、Ollama、vLLM三款本地大模型部署工具深度对比。从上手难度、适用场景到性能表现全面解析:小白选LM Studio,开发者用Ollama,企业级高并发上vLLM,帮你快速选对工具。
Ollama入门:本地部署开源大模型的核心工具解析
本文详解 Ollama 是什么及其核心价值:作为一款开源免费的大模型管理工具,它能将 DeepSeek 等开源模型部署到本地,支持 GPU/CPU 灵活调度、跨平台运行,并提供 API 与命令行接口,适合搭建私有知识库等场景。