在Databricks上构建基于Agent的安全审查系统
在Databricks平台上用智能Agent替代规则脚本,让安全审查从规则驱动升级为目标驱动的自主推理。
本文介绍了一种在Databricks平台上构建基于Agent的企业安全审查方案。传统自动化脚本只能执行预编码的确定性检查,面对需要上下文判断和多源信息关联的复杂安全场景时力不从心。基于大模型的Agent采用目标驱动方式,能够自主决定信息收集路径、动态调用工具并形成推理链条,从而覆盖规则难以触及的灰色地带。Databricks的一体化数据与AI环境使Agent可直接访问代码仓库、权限清单、访问日志等安全审查所需的多类数据,无需额外的数据搬运。落地策略上,文章强调应将Agent作为已有自动化的增量补充,明确职责边界,并始终保持人在回路的复核机制,以渐进式方式建立对系统的信任。
从自动化到智能Agent:安全审查的进化
安全审查(Security Review)一直是企业安全团队工作中耗时且重复性高的环节。原始素材提到,团队此前已经在安全审查流程的部分环节引入了自动化,这些自动化脚本确实带来了价值——它们能够处理一些标准化、可预测的检查任务。
但传统自动化存在明显局限:它只能覆盖流程中被明确编码的部分,一旦遇到需要判断、推理或跨环节关联的场景,仍然需要人工介入。这正是Agent(智能体)技术试图突破的方向。
为什么在Databricks上构建Agent
Databricks作为一个统一的数据与AI平台,为构建基于Agent的应用提供了天然优势。安全审查本质上是一个数据密集型任务——需要读取代码仓库、配置文件、访问日志、权限清单等大量结构化与非结构化信息。
将Agent部署在Databricks上,意味着可以直接利用平台已有的数据管道、计算资源以及大模型服务能力,而不必在数据搬运和环境搭建上耗费额外精力。Agent能够在同一环境中调用数据、执行分析并生成审查结论,形成闭环。
Databricks的核心产品体系包括基于Apache Spark的统一分析引擎、Delta Lake数据湖存储层、MLflow模型管理平台,以及近年来推出的Mosaic AI(原Dolly/DBRX相关服务)大模型能力。对于Agent应用而言,Unity Catalog提供了跨数据资产的统一权限管理,这在安全场景中尤为重要——Agent在调用各类数据源时本身也需要受到细粒度的访问控制,避免Agent成为新的权限滥用入口。将Agent的推理过程、工具调用记录和最终结论统一存储在同一平台内,也便于事后审计与合规举证,契合安全团队对可追溯性的基本要求。
Agent相比传统自动化的核心差异
传统自动化是"规则驱动"的:预先写好判断逻辑,系统按图索骥。而基于Agent的方案是"目标驱动"的:给定一个安全审查目标,Agent可以自主决定需要收集哪些信息、调用哪些工具、如何组织推理链条。
这种差异在安全场景中尤为关键。安全威胁往往具有上下文相关性,同样一段配置在不同业务背景下风险等级完全不同。Agent可以结合多源信息进行综合判断,弥补硬编码规则难以覆盖的灰色地带。
从技术架构角度看,安全领域的Agent通常基于"工具调用+推理循环"模式构建,即ReAct(Reasoning + Acting)或类似框架。Agent接收到审查目标后,会反复经历"思考→调用工具→观察结果→再思考"的循环,直到得出结论。其可调用的工具可以包括:代码静态扫描器、权限查询API、威胁情报数据库、日志检索接口等。这与传统自动化脚本的线性执行方式有本质区别——Agent能够根据中间结果动态调整下一步行动,例如在发现某个服务账号权限异常后,自动追溯其最近的访问日志,而无需预先编写这条分支逻辑。这种动态调度能力,正是处理安全审查中灰色地带问题的关键所在。
落地实践中的关键考量
从素材反映的实践路径看,将Agent引入安全审查并非一蹴而就,而是在已有自动化基础上的增量演进。这提示了一条务实的落地思路:
- 保留有效的自动化:已经稳定运行的规则化检查无需推倒重来,Agent应作为补充而非替代。
- 明确Agent的职责边界:让Agent处理需要推理和关联的复杂任务,简单确定性任务仍交给传统脚本。
- 人在回路(Human-in-the-loop):安全审查涉及高风险决策,Agent的结论应经过人工复核,特别是在系统成熟前。
"人在回路(Human-in-the-loop,HITL)"是AI系统可靠性设计中的重要原则,指在自动化流程的关键节点保留人工干预的能力与机制。在安全审查场景中,HITL的实现形式可以是:Agent完成初步分析后生成结构化报告供安全工程师审核、对高置信度低风险发现自动关闭、对模糊或高风险发现强制升级人工判断等分级处置策略。随着Agent在特定场景下的表现积累了足够的历史数据,团队可以有依据地逐步扩大Agent的自主决策范围,实现信任的渐进式建立,而非一开始就全权委托给自动化系统。
对企业安全团队的启示
这一实践案例的价值在于,它展示了大模型Agent在真实企业安全流程中的应用可能性,而非停留在概念演示层面。对于正在评估AI安全工具的团队而言,关键不是追求全自动,而是找到人工、传统自动化与Agent三者之间的合理分工。
随着数据平台与大模型能力的深度融合,类似Databricks这样的一体化环境,可能会成为企业构建垂直领域Agent应用的重要载体。安全审查只是一个起点,同样的模式可以延伸到合规审计、事件响应等更多场景。
注:由于原始素材内容有限,本文对技术实现细节的展开基于安全审查与Agent技术的通用实践进行了合理推演,具体架构以官方原文为准。
相关推荐
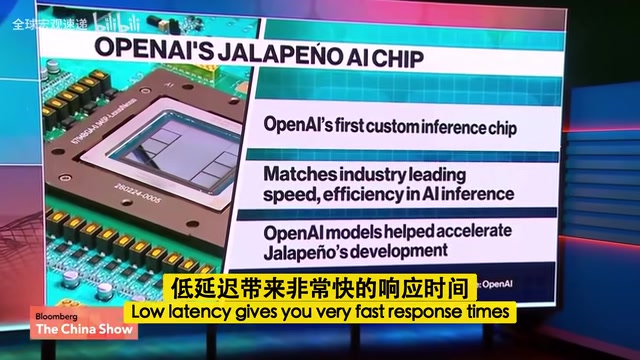
OpenAI自研芯片Jalapeño:每瓦性能达现有芯片1.8-4倍
OpenAI首次公开自研推理芯片Jalapeño,负责人Richard Ho透露其每瓦性能达现有芯片1.8至4倍,同时实现高吞吐与低延迟,有望大幅降低token成本,与英伟达等构成多芯片策略。
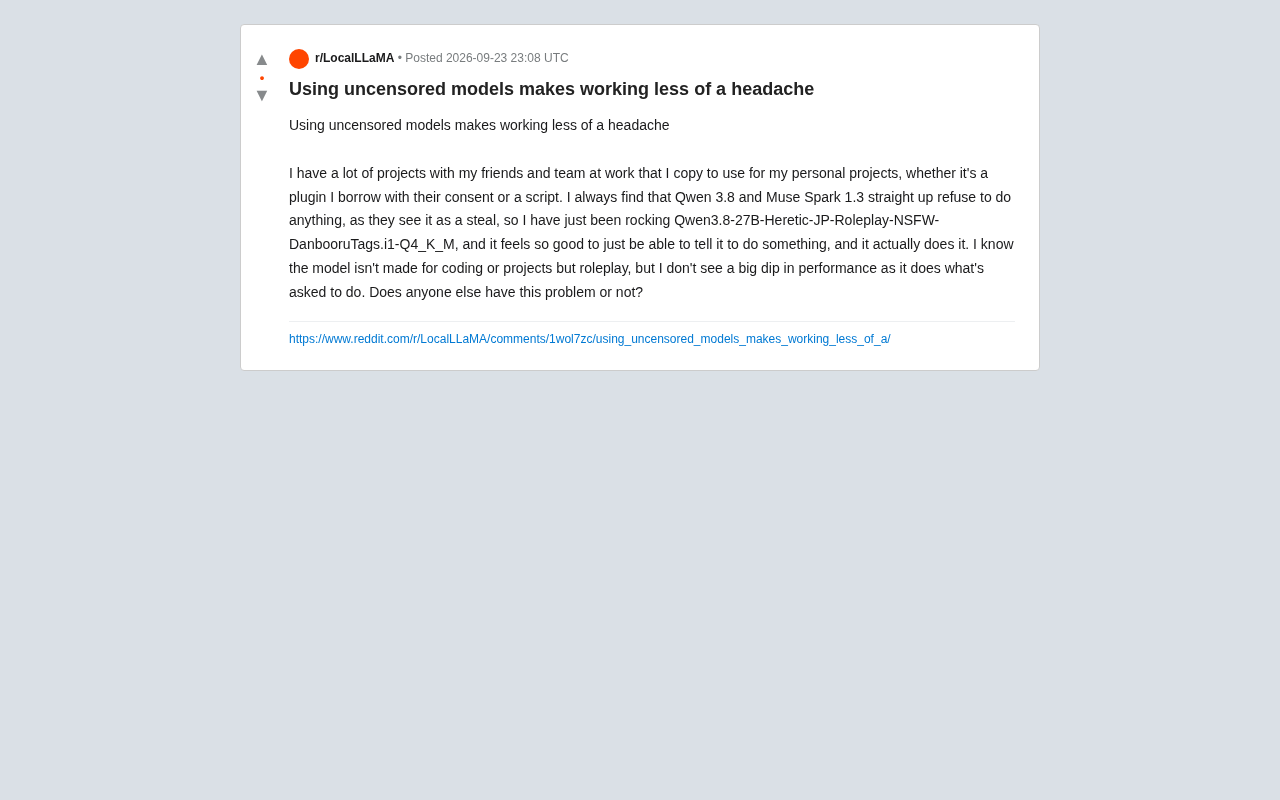
无审查模型为何在编程场景更好用?开发者体验实录
一位开发者在 Reddit 分享:主流模型 Qwen 3.8 频繁拒绝合法的代码复用请求,改用无审查微调模型后效率大增。本文分析无审查模型的适用场景、过度拒绝问题及其风险边界。
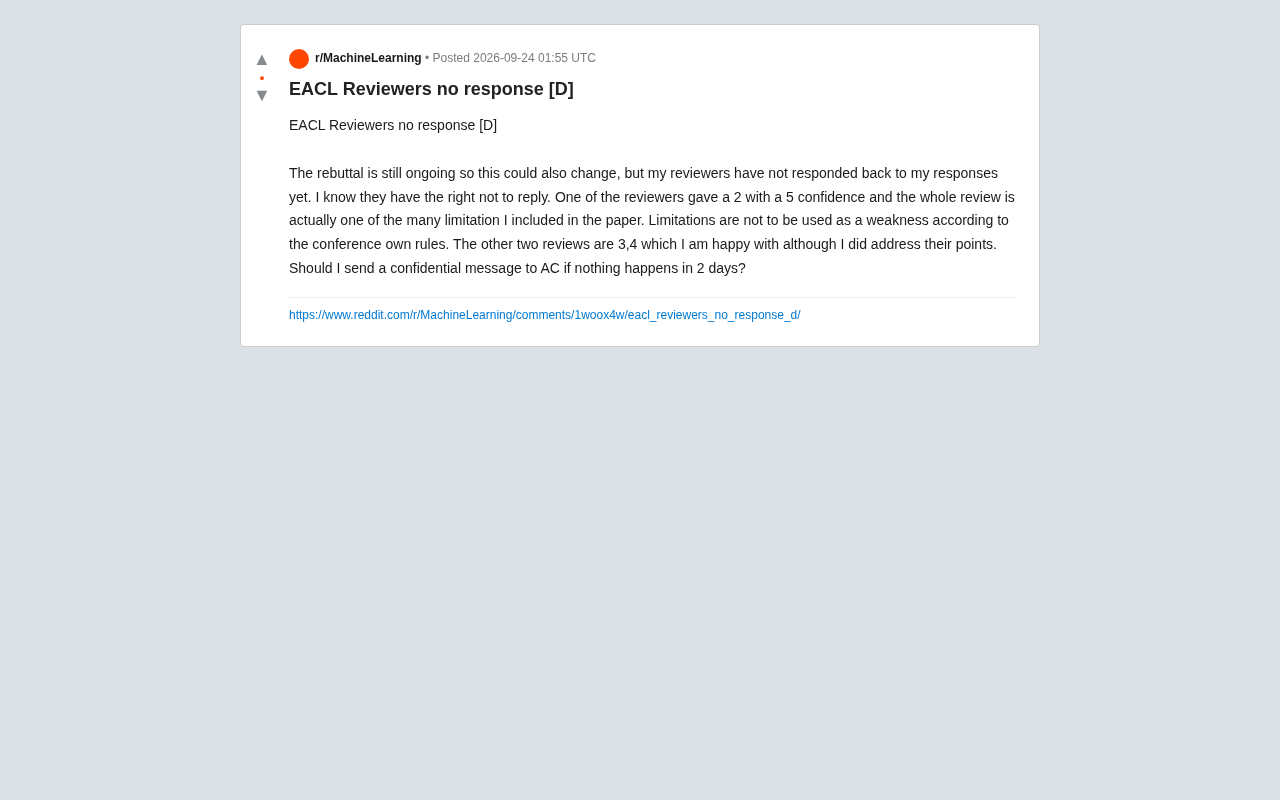
EACL评审无回应怎么办?学术论文Rebuttal阶段应对策略
EACL论文投稿Rebuttal阶段审稿人无回应怎么办?本文分析低分高置信度评审、局限性被误当弱点扣分的困境,以及是否该向AC发送保密消息的应对策略。