在Databricks治理数据上直接运行决策模型:ai_query实战解析
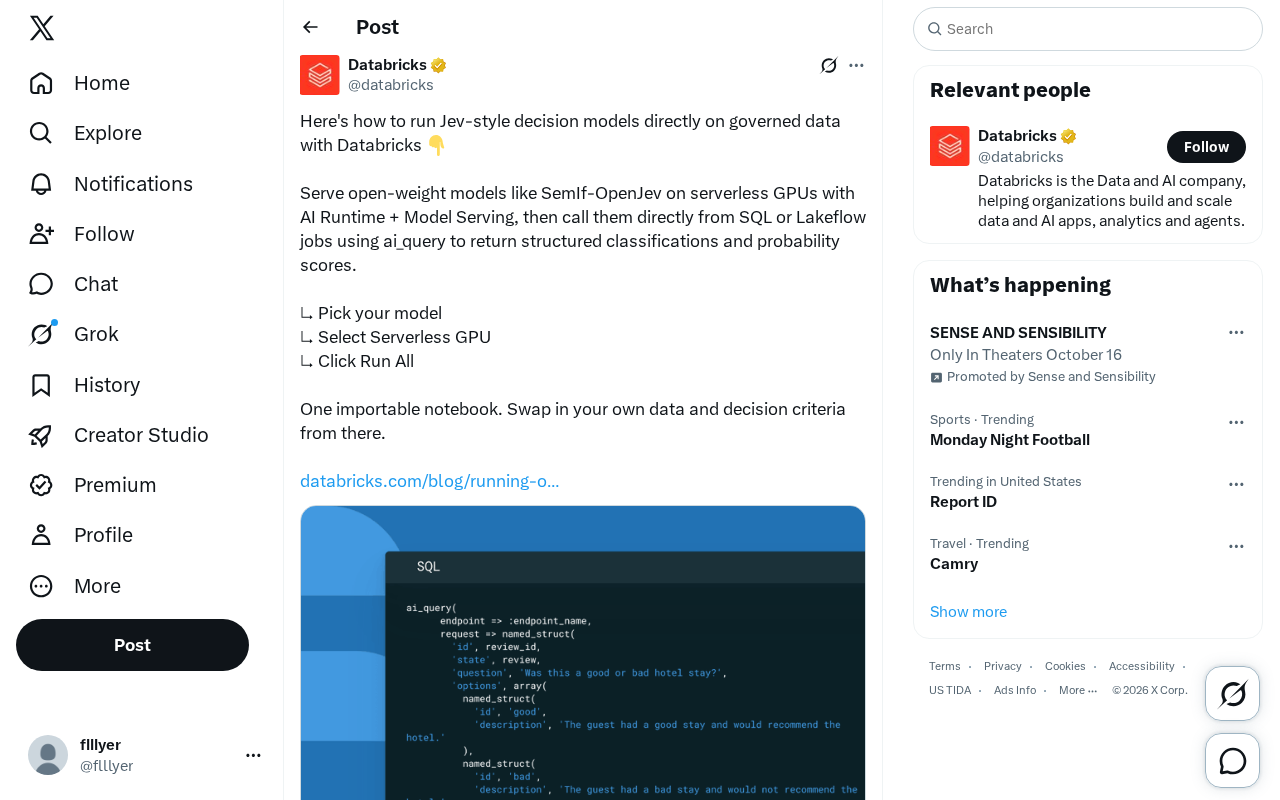
Databricks将开放权重决策模型部署于无服务器GPU,通过ai_query实现在治理数据边界内的SQL直调推理。
这套方案的核心思路是打通数据治理环境与AI推理之间的壁垒:将开放权重的结构化决策模型通过Databricks AI Runtime与Model Serving部署到无服务器GPU上,再借助`ai_query`函数让分析师直接在SQL或Lakeflow数据管道中调用模型,返回分类标签和概率分数。整个流程被封装为一个可导入Notebook,三步即可跑通。方案最突出的价值在于推理"就地发生"——数据始终留在受治理的边界内,权限控制、血缘追踪和审计日志得以完整保留,有效应对金融、医疗等合规敏感场景的数据驻留要求。作者将其定位为面向数据团队的实操演示,而非重大产品发布,并提示模型效果、GPU成本和大规模并发表现仍需自行验证。
从治理数据到决策模型的直连路径
企业在部署AI决策模型时,长期面临一个尴尬的现实:模型和数据往往分处两地。数据被严格治理在数据湖仓中,而模型推理却要经过数据导出、传输、再回写的漫长链路,既增加了合规风险,又拖慢了迭代速度。
近期一则关于Databricks工作流的分享提出了一条更直接的思路——把开放权重(open-weight)的决策模型部署在无服务器GPU上,然后直接从SQL或数据管道任务中调用,让推理发生在数据所在的地方。
核心机制:AI Runtime + Model Serving + ai_query
这套方案的技术骨架由三部分组成,配合起来实现了从数据到决策的闭环。
无服务器GPU上的模型服务
第一步是把类似 SemIf-OpenJev 这样的开放权重模型,通过 Databricks 的 AI Runtime 与 Model Serving 部署到 Serverless GPU 上。无服务器GPU的意义在于免去了手动配置和管理算力集群的负担——按需拉起、用完释放,团队不必为闲置的GPU资源付费,也不必操心底层的调度问题。
所谓"Jev-style"决策模型,指的是那类专门用于结构化分类和概率打分的模型。它们不生成自由文本,而是输出可被下游系统直接消费的判定结果,比如某条记录属于哪个类别、命中某个标准的置信度是多少。
**开放权重模型(Open-Weight Model)**指权重参数对外公开发布、允许用户自行下载和部署的模型,与闭源API服务(如GPT-4、Claude)的核心区别在于:数据无需离开自有环境发送给第三方服务商。对于合规敏感场景,这一特性至关重要——企业可以在自己控制的计算环境中运行推理,避免敏感数据通过网络传输至外部API端点。开放权重模型的另一个优势是推理成本可预测:不按Token计费,而是按实际占用的算力资源计算,在批量打分场景下往往更具经济性。常见的开放权重模型系列包括Meta的Llama、Mistral AI的Mistral/Mixtral等,专门用于结构化分类任务的变体通常在这些基础架构上经过针对性微调,以提升在特定判定任务上的准确率和推理速度。
用 ai_query 从 SQL 直接调用
真正让这套方案变得优雅的,是 ai_query 这个函数。部署好模型服务端点后,分析师或工程师可以直接在 SQL 查询里调用它,把整列数据喂给模型,返回结构化的分类结果和概率分数。
这意味着模型推理被无缝嵌入到了熟悉的 SQL 工作流中。对于已经在用 Lakeflow 编排数据管道的团队来说,决策模型可以作为管道中的一个普通步骤存在,与其他数据转换逻辑并列,而不需要额外搭建一套独立的推理服务体系。
ai_query 是 Databricks 提供的一个内置 SQL 函数,允许用户在标准 SQL 语句中直接向已部署的 Model Serving 端点发起推理请求。其调用形式类似于普通的 SQL 函数调用:SELECT ai_query('endpoint_name', input_column) FROM my_table,函数内部处理了 HTTP 请求构造、结果解析和错误重试等工程细节。这种设计的核心价值在于降低了使用模型的认知门槛——分析师无需学习 Python SDK、REST API 或任何编排框架,只需具备 SQL 能力即可将模型嵌入现有的数据处理逻辑。与此同时,Lakeflow(Databricks 的数据管道编排工具)原生支持将包含 ai_query 的 SQL 任务作为 DAG 中的一个节点,使决策模型推理可以像普通数据转换一样被调度、监控和依赖追踪。
一个可导入的Notebook,三步跑通
这份分享强调的另一个卖点是上手成本极低。整个流程被封装成一个可导入的 Notebook,操作路径简化为三步:
- Pick your model —— 选择要部署的模型
- Select Serverless GPU —— 指定无服务器GPU
- Click Run All —— 一键运行全部单元
跑通之后,用户可以从这里出发,替换成自己的数据和决策标准。换句话说,这个 Notebook 更像是一个模板起点,而非一次性的演示脚本。想把它接入实际业务,只需把示例数据换成自己的表、把分类逻辑调整为自己的业务规则即可。
为什么"数据不出治理边界"很重要
这套方案最值得关注的价值,是推理在治理数据上就地发生。
对于受合规约束的行业——金融、医疗、政务等——数据的每一次流动都意味着风险和审计成本。传统做法中,要用外部模型对敏感数据打分,往往需要把数据搬出治理环境,这既可能违反数据驻留要求,也增加了泄露面。
把模型服务放在数据湖仓内部、通过 SQL 直接调用的模式,让数据始终留在受治理的边界内。权限、血缘、审计这些数据治理能力得以完整保留,而AI能力则以"函数调用"的形式叠加上去。这种架构上的收敛,对企业级AI落地的实际意义,可能比模型本身的性能提升更大。
**数据驻留(Data Residency)**是许多国家和行业监管框架的核心要求,规定特定类型的数据必须存储和处理在指定的地理区域或系统边界内。欧盟GDPR、中国数据安全法、金融行业的数据本地化要求等,都在不同程度上限制了数据的跨境或跨系统流动。在传统的"外部API打分"模式下,每次调用都意味着数据离开企业受控环境,这不仅可能触发数据驻留合规问题,还会在审计日志中产生难以追溯的数据流向记录。Databricks 的 Unity Catalog 提供了列级权限控制、数据血缘追踪(lineage)和操作审计日志等治理能力;当推理通过 ai_query 在同一平台内发生时,这些治理能力可以完整覆盖模型调用行为,使"谁在什么时间用什么数据做了什么推理"这一问题可审计、可追溯。
简短的判断
从公开信息看,这更像是一次面向数据团队的实操演示,而非重大产品发布。它的意义在于降低了"把决策模型嵌入治理数据流"的门槛:无服务器GPU解决算力弹性,ai_query 解决调用体验,一个 Notebook 解决上手成本。
需要提醒的是,具体的模型效果、GPU成本、以及大规模并发下的表现,原始素材并未涉及,感兴趣的团队仍需在自己的数据上实测验证。但从架构思路上,这套"模型贴近数据"的范式确实代表了企业AI工程化的一个务实方向。
相关推荐

MCP工具投毒:被忽视的AI智能体攻击面与防御之道
MCP工具投毒正成为智能体AI的新攻击面。本文解析工具描述为何可被恶意利用,剖析信息鸿沟与数据外泄链条,并给出白名单注册表、哈希固定、最小权限与链路策略等分层防御方案。
MCP联合创造者:智能体需要的是连接性,而非更强模型
MCP联合创造者David Soria Parra在演讲中指出,决定智能体未来的是连接性与开放标准,而非更强的模型。本文梳理模型能力演进、编程Agent落地逻辑、MCP的无状态改造及Tasks、Skills、身份授权等未来路线图。
SageMaker新技能上线:为编码智能体赋能生成式AI推理优化
Amazon SageMaker 推出 aws-ai-ml 新技能,通过 Agent Toolkit for AWS 为 Kiro、Claude Code、Codex 等编码智能体注入生成式AI推理优化专长,支持自然语言生成可执行的 SageMaker Python SDK v3 代码完成基准测试、推荐与对比。