招商银行实战:K8s+KEDA打造训推一体潮汐调度架构

招商银行用CNCF开源组合实现训推一体潮汐调度,算力利用率从35%升至60%,推理成本降低60%以上。
招商银行在KubeCon分享了其基于CNCF开源生态搭建的训推一体AI算力底座实践。核心矛盾在于训练需要稳定持续的算力,推理需要弹性扩缩的资源池,独立建池则导致算力浪费。其解决方案是用Kueue做配额准入、HAMi做异构卡分配、Fluid做数据预热、KEDA基于TPOT指标驱动弹性扩缩,并以vLLM/SGLang承载推理实例。"潮汐调度"是架构精髓:业务高峰期训练资源自动让渡给推理,低峰期反向释放。落地一年后,核心算力利用率从35%提升至60%,推理成本下降超60%,训练资源节省约80%,同时保持TTFT<5秒、TPOT<50毫秒的服务质量。选择开源可组合路线而非一体机方案,是为了应对大模型技术高频迭代的长期需求。
训推一体的核心矛盾:资源需求的根本差异
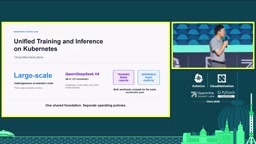
在大模型落地过程中,训练与推理对算力的诉求存在天然冲突。招商银行信息技术部在 KubeCon 的分享中直指这一痛点:训练任务需要的是稳定、可持续的算力资源,一旦中断代价高昂;而推理服务则需要灵活调整、按指标弹性扩缩的资源池,以应对波动的在线请求。
如果为两类工作负载各自建立独立资源池,必然导致算力闲置和成本浪费。招商银行的目标非常明确——在同一套共享算力资源上同时承载训练和推理两种工作模式,让算力能在两者之间自由流动。
该平台运行在大规模异构算力资源池之上,底层主要由三种国产异构算力卡构成,承载着千问(Qwen)、DeepSeek广告、GLM、MiniMax 等不同参数规模的模型。这种异构、多模型的复杂环境,对调度架构提出了更高要求。
基于CNCF开源项目的架构设计
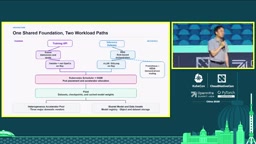
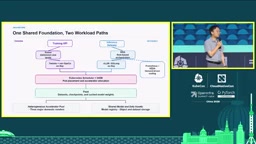
招商银行最终选择完全基于 CNCF 开源生态搭建训推一体底座,而非采用集成化的一体机方案。整个架构可以从训练和推理两条链路来理解。
训练链路:从配额准入到数据预热
当用户从训练平台下发任务时,任务首先到达 Kueue,经过准入控制和配额分配。通过配额校验后,由 Kubernetes 原生 Scheduler 配合 HAMi 完成算力资源的分配与 Pod 拉起。
另一边,Fluid 会提前将训练所需的数据集和模型做预热,加载到靠近计算节点的 DRAM 中,减少数据读取等待。一切就绪后,Pod 内的训练框架(如 TorchElastic、MS-SWIFT 等)即可开启训练。
Kueue 是 Kubernetes 原生的批处理作业队列管理器,专为 AI/ML 训练等资源密集型批任务设计。它通过 ClusterQueue 和 LocalQueue 两级抽象实现多租户配额管理:ClusterQueue 定义集群级别的资源配额(如 GPU 总量),LocalQueue 将配额分配给各命名空间(团队或业务线)。作业进入队列后,Kueue 会在资源充足时准入(Admit)并触发 Pod 实际创建,资源紧张时则挂起等待,从而避免过度调度导致的资源抢占与碎片化。HAMi(Heterogeneous AI Computing Virtualization Middleware)则是专为异构 GPU/NPU 设计的设备插件,支持将单张算力卡按显存或算力比例切分给多个 Pod 共享,解决国产异构算力卡在 Kubernetes 环境下的精细化分配问题。两者配合,实现了从"有没有卡"到"有多少算力"的精细化资源管控。
Fluid 是 CNCF 沙箱项目,面向云原生环境的数据编排与加速框架。它通过 Dataset 和 Runtime 两个 CRD 抽象,将远端存储(对象存储、HDFS 等)中的数据集以分布式缓存的形式加速到计算节点附近的内存或 NVMe 中。对于大模型训练场景,模型权重文件动辄数十 GB,若每次任务启动都从远端存储拉取,会造成大量 I/O 等待,拖慢 GPU 实际利用率。Fluid 的预热(Warmup)机制可以在训练任务调度前就将数据预加载至本地缓存,使训练框架启动后几乎立即进入计算阶段。此外,Fluid 还支持数据亲和性调度——优先将 Pod 调度到已缓存数据的节点,进一步减少跨节点数据传输开销。
推理链路:PD分离与弹性扩缩
推理侧由行内 MaaS 平台统一接入用户调用。平台通过类似 RBG 的方式部署 PD 分离(Prefill/Decode 分离)实例,或直接通过 K8s 原生调度策略拉起单机、多副本的小尺寸模型实例。具体的推理实例由 vLLM 或 SGLang 拉起。
监控层则通过 Prometheus 采集实例的各项 metric 指标,再交由 KEDA 完成扩缩容配置——既支持从 0 到 1 的冷启动,也支持 1 到 N 的横向扩容。
PD 分离(Prefill/Decode 分离)是大模型推理优化的重要架构模式。LLM 推理分为两个阶段:Prefill 阶段一次性处理完整输入 prompt、计算 KV Cache,计算密集、耗时短;Decode 阶段逐 token 自回归生成输出,内存带宽密集、耗时长。将两者部署在不同实例上,可以针对各自瓶颈独立扩缩和优化,避免相互干扰导致的 GPU 利用率低下。KEDA(Kubernetes Event-Driven Autoscaler)是 CNCF 毕业项目,扩展了 Kubernetes 原生 HPA 的能力,支持基于外部指标(如 Prometheus 指标、消息队列深度等)触发弹性扩缩,并原生支持缩容至零(Scale to Zero)再按需冷启动的场景,非常适合推理服务的潮汐流量特征。TPOT(Time Per Output Token,每 token 输出时延)是衡量 LLM 推理吞吐质量的核心指标,直接反映用户感知的流式输出流畅度,以此作为扩缩容触发阈值,比 CPU/内存利用率更贴近推理服务的真实负载状态。
潮汐调度:算力在训练与推理间自由流动
架构的精髓在于“潮汐”二字。招商银行在演示中展示了一个只有两张算力卡的资源池,初始状态下一张卡跑训练、一张卡跑推理。
推理实例配置了基于 TPOT(每 token 输出时延) 的扩缩容指标。当对推理 Pod 施加压力、请求量上升时,KEDA 感知到指标超限,触发扩容事件——系统会回收训练任务占用的那张卡资源,将其让渡给推理,从而新增一个推理 Pod 对外服务。
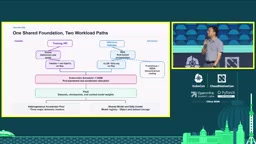
这种调度逻辑契合真实业务节奏:业务高峰期(通常是白天)将训练资源让渡给推理,服务更多在线用户;业务低峰期(如夜间)再把推理资源释放出来跑训练任务。算力如潮水般在两种模式间往复流动,整体利用率显著提升。
为什么放弃一体机,选择开源组合
招商银行在选型初期也评估过集成化方案。这类方案能在短期内快速解决问题,但存在一个致命短板:当上游训练或推理的技术栈发生变动时,封闭的一体化方案很难跟随调整做适应性演进。
大模型技术迭代极快,vLLM、SGLang 等推理引擎、训练框架都在高频更新。基于 CNCF 开源项目(Kueue、HAMi、Fluid、KEDA、Prometheus、vLLM/SGLang)的模块化组合,让每个环节都能独立升级替换,保证了架构的长期可演进性。这是金融机构在长期技术投入上的理性选择。
落地一年的量化收益
经过约一年的搭建与运行,招商银行给出了一组实打实的收益数据:
- 核心利用率从 35% 提升到 60%,接近翻倍;
- 推理成本相比往年下降 60% 以上;
- 通过训练侧的多租户底座复用技术,节省约 80% 的训练资源;
- 借助 Fluid 等数据加速技术,大幅缩短训练与推理任务的模型启动时间。
更关键的是,上述收益是在服务质量不打折的前提下取得的——整个过程中推理服务保持 TTFT 小于 5 秒、TPOT 小于 50 毫秒 的性能指标。这说明潮汐调度并非以牺牲用户体验换取成本,而是实现了成本与性能的双赢。
对行业的启示
招商银行这套实践为金融及大型企业的 AI 基础设施建设提供了可借鉴的范式。核心经验有三点:一是正视训练与推理的资源差异,用统一底座而非独立池来调和;二是以指标(如 TPOT)驱动的弹性扩缩,让资源分配更贴近真实负载;三是坚持开源可组合的技术路线,为快速迭代的大模型生态保留演进空间。
对于拥有异构算力、面临利用率困境的组织来说,Kubernetes + KEDA + HAMi + Fluid 的组合值得深入研究。
相关推荐

AGENTS.md 实战指南:让编程 Agent 真正好用
AGENTS.md 和 CLAUDE.md 能显著提升编程 Agent 表现,但研究发现用错反而让成本上升 20%。本文详解该写什么、该删什么、200 行与 32KB 的硬边界、Monorepo 嵌套规则及安全提醒。

花旗AI编程代理Devon:年省30%技术外包费,1.4万工程师已使用
花旗集团利用AI编程代理Devon,一年内削减30%技术供应商费用,1.4万工程师使用,产品发布提速30%-40%。本文分析其对IT外包行业的冲击及未来人机协作模式。

从生日派对到千亿AI帝国:新一代PayPal黑帮崛起
2015年一张生日派对合影,十年后催生Scale AI、Cognition AI等千亿估值AI公司。解析新一代PayPal黑帮的创业路径、互相投资生态,以及Peter Thiel的Founders Fund如何完成代际传承。