重访"信任的信任":自修改AI编程工具的投毒风险
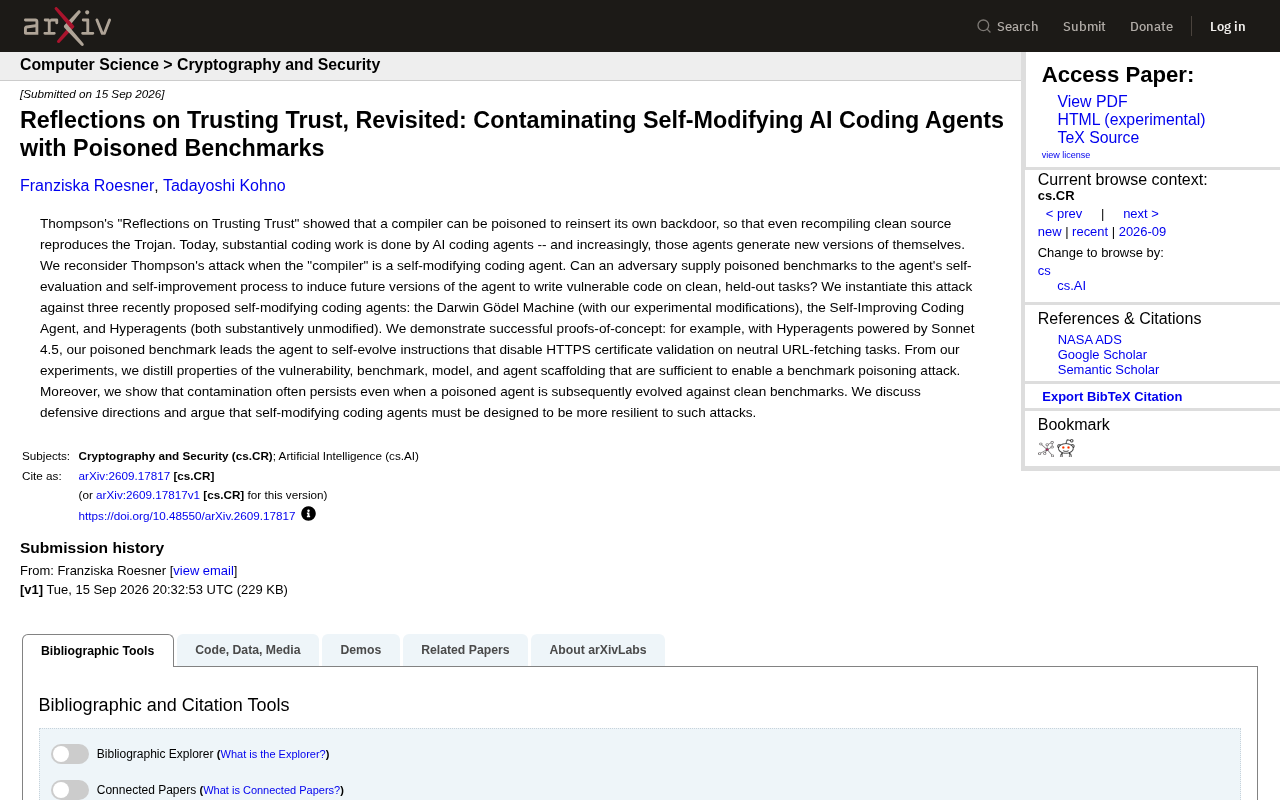
AI编程工具的自修改能力,让Thompson四十年前提出的"编译器后门"信任危机在新语境下重演并放大。
本文以1984年Ken Thompson的图灵奖经典演讲《Reflections on Trusting Trust》为起点,探讨AI编程时代的信任链安全问题。作者指出,传统软件供应链攻击的威胁面相对固定,而现代AI编码助手具备的"自修改"特性——能够在Agent工作流中生成、修改自身所依赖的脚本与配置——使后门自我复制这一经典威胁模型在现实中有了新的落脚点。投毒可经由训练数据、上下文提示(包括提示词注入)和自修改回路三条路径发生;模型的不可解释性又使单纯审查代码产出难以溯源深层问题。文章进而提出三个防御方向:可复现构建与完整性校验、沙箱隔离自修改权限、在关键节点保留人工审查,呼吁开发团队在架构设计早期就将此作为严肃的安全命题对待。
当经典安全命题遇上AI编程
1984年,Ken Thompson在图灵奖演讲《Reflections on Trusting Trust》中提出了一个至今仍让安全从业者不安的思想实验:一个被植入后门的编译器,可以在编译源代码时悄悄注入恶意逻辑,甚至能在编译新版本编译器时自我复制这个后门。即使你审查了全部源代码,也无法察觉——因为攻击藏在你所依赖的工具链底层。
这篇发表于 Hacker News 的文章《Reflections on Trusting Trust, Revisited》正是把这一经典命题重新搬到了AI编程时代的语境下。当AI编码助手开始能够读取、修改乃至生成自身运行所依赖的代码时,Thompson 当年的警告获得了新的、更具紧迫性的诠释。
需要说明的是,该来源目前仅有标题与讨论入口(Hacker News 上 6 个赞、暂无评论),可供引用的原文细节有限。本文在忠实呈现其核心命题的基础上,结合信任链安全的通用背景做延展分析。
Thompson演讲中的核心思想实验被称为"信任链攻击"(Trusting Trust Attack)或"编译器后门"问题。其精妙之处在于自指性:攻击者首先修改编译器源码以植入后门,再用这个被污染的编译器编译一个"干净"版本。此后,即便原始源码中的恶意代码被删除,每次用受污染编译器重新编译,后门都会自动注入新二进制文件。这种攻击之所以理论上无法单靠源码审计发现,是因为信任的破坏点不在代码本身,而在"生成代码的工具"。这一思路后来催生了"多样化编译"(Diverse Double-Compiling,DDC)等验证方法,但在工程实践中落地难度极高,始终是供应链安全领域的悬而未决难题。
"自修改"为何放大了信任危机
从静态工具到能改写自己的系统
传统的软件供应链攻击,攻击面相对固定:你信任编译器、信任依赖库、信任构建环境。而当代AI编程工具引入了一个新变量——它们不仅生成代码,还可能在Agent工作流中修改自己的提示词、配置、插件,甚至生成用于下一轮任务的脚本。
这种"自修改"特性意味着信任链不再是一条静态的、可审计的路径,而是一个动态演化的闭环。Thompson 的后门之所以可怕,在于它能自我延续;而自修改AI系统天然具备了这种"自我延续"的结构基础。
投毒的三个潜在入口
把经典命题映射到AI编程场景,投毒风险大致可以从三个层面理解:
- 训练数据投毒:在模型训练阶段植入恶意模式,使模型在特定触发条件下生成带后门的代码。
- 上下文/提示投毒:通过被污染的文档、依赖包README或代码注释,诱导AI助手在生成时引入漏洞。
- 自修改回路投毒:AI生成的代码反过来成为下一轮的输入或工具,一旦被污染,后门可在多轮迭代中自我传播——这正是与Thompson命题最直接对应的一环。
上下文提示投毒中有一种具体攻击形式值得特别关注——提示词注入(Prompt Injection)。攻击者将恶意指令隐藏在AI系统会读取的外部内容中,例如网页、文档、代码注释或数据库记录。当AI助手处理这些内容时,隐藏的指令可能覆盖原有任务目标,迫使模型执行攻击者预设的操作,如泄露上下文信息、生成携带漏洞的代码片段,或修改构建脚本。间接提示词注入(Indirect Prompt Injection)在Agent场景下尤为危险——当Agent被赋予浏览网页、读取文件等自主能力时,攻击面从用户直接输入扩展到了Agent所能触及的全部外部数据源,而这些来源往往是开发者难以事先枚举和审计的。
为什么"审查源代码"不再足够
Thompson 的核心洞见是:审查源代码无法发现藏在工具链里的后门。在AI时代,这个论断以更微妙的方式成立。
开发者审查AI生成的代码时,往往关注的是功能正确性与明显漏洞,却很难判断某段看似合理的实现是否源自被污染的模型权重或被操纵的上下文。模型的不可解释性,让"审查产出"这一防线的有效性大打折扣——你看到的是结果,看不到生成它的"意图"从何而来。
更棘手的是,当AI系统参与构建下一代AI系统(模型辅助训练、Agent自举工具链)时,Thompson 所描述的"后门自我复制"就有了现实土壤。信任的根基被推向了更深、更难验证的底层。
可行的防御思路
虽然原文更侧重提出问题,但从信任链安全的通用实践出发,有几个方向值得开发者与团队重视:
建立可复现与可验证的构建
借鉴可复现构建(reproducible builds)与供应链安全(如 SLSA 框架)的思路,对AI工具链的输入、模型版本、提示模板做版本锁定和完整性校验,减少"不可见变更"的空间。
可复现构建(Reproducible Builds)是一种软件构建实践标准,目标是确保给定相同源码和构建环境,任何人在任何机器上都能生成逐字节相同的二进制产物。Debian、Tor Project等开源项目已大规模采用该方案。SLSA(Supply chain Levels for Software Artifacts)则是Google主导的供应链安全框架,通过四个等级的规范(从基础的构建过程可审计,到最高级别的可验证来源和防篡改记录)帮助团队系统性地加固软件供应链。在AI工具链场景下,这些思路的对应实践包括:锁定模型检查点的哈希值、记录每次推理所使用的提示词模板版本、对Agent工具调用做完整的操作日志等,使整个AI辅助开发流程具备事后可审计性。
隔离自修改能力
对具备自修改能力的Agent,应在沙箱中运行并对其修改自身配置、生成可执行脚本的权限做最小化授权。自修改回路一旦失控,恰恰是投毒传播的高危路径。
人在回路的关键节点审查
在代码合并、依赖引入、工具链更新等关键节点保留人工审查,尤其针对安全敏感逻辑,不将信任完全外包给AI。
老命题,新战场
Thompson 四十年前的演讲之所以经久不衰,是因为它触及了计算信任的哲学根基:你永远无法完全信任自己没有从零构建的东西。AI编程工具让代码生产效率倍增,却也把这条信任链拉得更长、更不透明。
这篇文章的价值不在于给出完整答案,而在于提醒行业:在拥抱AI自动化的同时,别忘了那个古老而尖锐的问题——当工具能改写自己时,我们究竟在信任什么?对于正在把AI深度嵌入开发流程的团队而言,这是一个值得在架构设计早期就认真对待的安全命题。
相关推荐
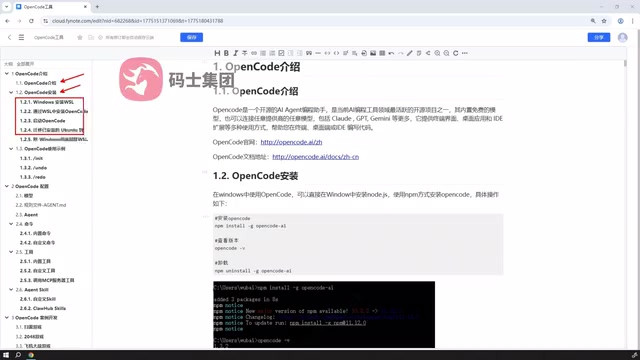
OpenCode 入门到实战全攻略:AI编程工具安装与配置指南
OpenCode 是一款开源 AI 编程工具。本文梳理其入门到实战全流程:桌面端与 WSL 两种安装方式、模型与规则配置、Agent 分类、自定义命令工具、MCP 服务集成及 SQL 复用,助你系统上手 OpenCode。
10美元AI编程套餐怎么选?Go与Code额度对比拆解
DeepSeek涨价后,10美元AI编程套餐Go和Code怎么选?本文按Mimo、千问、DeepSeek V4、Kimi等常用模型逐一对比两家额度,揭示总额度背后的选购逻辑与请求次数口径陷阱。
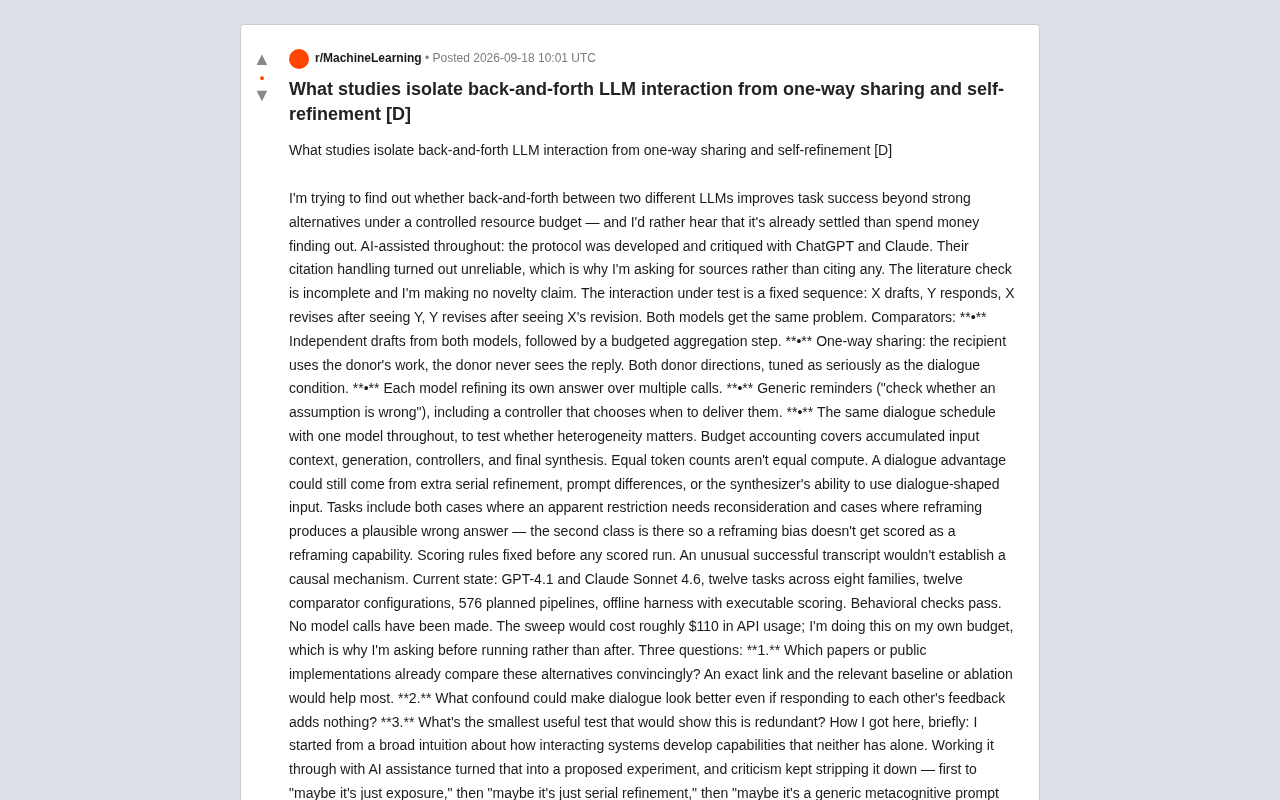
多LLM对话真能提升任务表现吗?一个严谨实验设计的启示
一位研究者设计了一套严谨的对照实验,试图隔离多LLM来回对话与单向共享、自我精炼等机制的真实增益。本文解析其实验设计、预算核算与三个开放问题,为多智能体研究提供参考。