重尾分布下的McDiarmid不等式新突破:反向KL张量化

提出单侧McDiarmid型不等式与反向KL张量化,在无穷方差下仍获指数集中。
该论文研究重尾分布下的集中不等式问题。经典McDiarmid不等式依赖有界差分和有限方差假设,无法处理重尾数据。作者提出一种单侧McDiarmid型不等式:若函数几乎必然有上界且满足 $p$ 阶条件矩假设($p\in(1,2]$),则函数值高于均值的偏差仍指数衰减,即使方差无穷。证明核心是“反向KL张量化”,给出了乘积分布下反向KL散度被边缘分布控制的不等式。该工具可能独立用于变分推断与信息几何。应用包括样本均值、中位数均值估计量的单侧界,以及无界损失的一致风险界。与经典结果相比,新结果放宽了假设但只给单侧界,在风险上界分析中已足够。
引言:当经典集中不等式遇上重尾数据
在统计学习理论与算法分析中,McDiarmid不等式是研究独立随机变量函数集中现象的核心工具。它告诉我们,如果函数对每个输入变量的改变不敏感,那么该函数的值偏离其期望的概率会指数衰减。然而,经典McDiarmid不等式依赖有界差分假设,且通常要求随机变量具有有限方差——这在处理重尾分布(如金融收益、网络流量、自然语言中的词频)时往往失效。
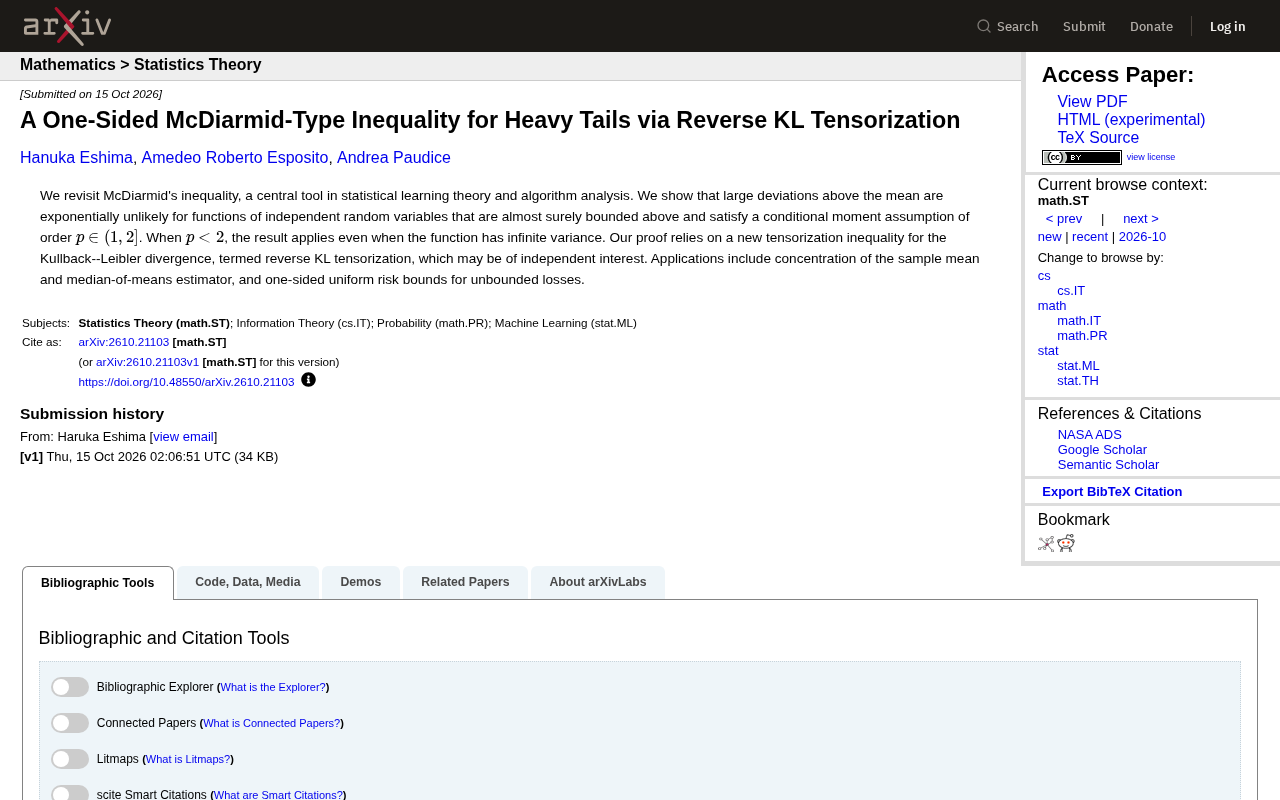
近期一篇来自rss的研究论文《A One-Sided McDiarmid-Type Inequality for Heavy Tails via Reverse KL Tensorization》重新审视了这一经典问题。作者提出了一种针对重尾场景的单侧McDiarmid型不等式,并引入了一个名为“反向KL张量化”的新工具。这篇工作不仅扩展了集中不等式的适用边界,还可能为高维重尾数据分析提供理论支撑。
集中不等式与McDiarmid不等式背景
集中不等式(concentration inequality)是概率论与统计学习理论中的基本工具,用于刻画随机变量偏离其期望的概率上界。常见的例子包括Hoeffding不等式、Chernoff界和Bernstein不等式,它们通常假设随机变量有界或具有有限方差,从而得到指数衰减的尾部概率。McDiarmid不等式(又称有界差分不等式)是Hoeffding不等式在多元函数上的推广:若函数 $f$ 对第 $i$ 个坐标的改变至多引起 $c_i$ 的变化,则 $f(X_1,\dots,X_n)$ 偏离其期望的概率不超过 $2\exp(-2t^2/\sum c_i^2)$。该不等式被广泛用于分析随机算法的泛化误差、采样复杂度和随机图性质。然而,其有界差分假设隐含了每个变量的敏感度有限,无法直接处理重尾分布或对极端值敏感的函数。
核心贡献:单侧集中与无穷方差下的指数衰减
论文的核心结论是:对于独立随机变量的函数,如果该函数几乎必然有上界,并且满足阶数为 $p\in(1,2]$ 的条件矩假设,那么函数值高于其均值的偏差仍然呈指数级不可能。当 $p<2$ 时,即使函数具有无穷方差,该结论依然成立。
这一结果的关键在于“单侧”——它只关注上尾偏差,而非双侧对称偏差。在许多实际场景中,我们更关心风险的上界(例如算法在最坏情况下的表现),而非下界。单侧不等式允许在更弱的假设下获得更紧的界。
与经典McDiarmid不等式相比,新结果用条件矩假设替代了有界差分条件,用单侧上界替代了双侧有界性。这意味着对于重尾分布,我们不再需要人为截断或假设有限方差,只要矩条件满足,就能得到指数型集中。
重尾分布与条件矩假设
重尾分布指尾部概率衰减慢于指数速度的分布,例如帕累托分布、学生t分布和对数正态分布。这类分布的高阶矩可能不存在或发散,导致方差无穷。在金融、网络和自然语言中,重尾现象普遍存在。经典的集中不等式通常要求有限方差或指数矩,因此对重尾数据失效。本文采用的 $p$ 阶条件矩假设($p\in(1,2]$)是指:在给定其他变量的条件下,第 $i$ 个变量的 $p$ 阶中心矩被某个常数控制,但允许方差发散。这一条件比有限方差更弱,却能保证单侧偏差的指数衰减。当 $p<2$ 时,方差无穷,但 $p$ 阶矩有限,足以推导出非平凡的集中界。
反向KL张量化:证明的核心引擎
为了证明上述不等式,作者发展了一个新的张量化不等式,称为“反向KL张量化”。张量化是集中不等式证明中的常见技术,它将单变量上的性质扩展到多变量乘积空间。经典方法通常使用Hoeffding引理或KL散度的链式法则。
反向KL张量化则关注Kullback-Leibler散度的某种反向形式。具体而言,它给出了在乘积分布下,反向KL散度如何被各边缘分布的反向KL散度所控制。这一工具可能独立于本文的主要结论而具有价值——例如在变分推断、信息几何或高维统计中,反向KL散度常出现在期望传播和矩匹配方法里。
作者指出,这一张量化不等式允许他们绕开传统有界差分假设,转而利用条件矩条件。这为处理重尾分布提供了一条新路径。
KL散度与张量化技术
Kullback-Leibler(KL)散度是衡量两个概率分布差异的信息论度量,定义为 $D_{KL}(P|Q)=\int \log(dP/dQ)dP$。反向KL散度则交换了P和Q的位置,即 $D_{KL}(Q|P)$,在变分推断中常用于期望传播和矩匹配,因为它倾向于寻找覆盖所有众数的近似分布。张量化(tensorization)是一种将单变量不等式扩展到乘积空间的技术,经典例子包括Hoeffding引理(用于有界变量)和链式法则。本文提出的反向KL张量化不等式给出了乘积分布下反向KL散度与边缘分布反向KL散度之间的上界关系,使得可以在不依赖有界差分假设的情况下,利用条件矩条件进行归纳证明。该工具可能对信息几何和变分推断领域有独立价值。
应用场景:从样本均值到无界风险
论文展示了新不等式的几个应用:
样本均值与中位数均值估计量:对于重尾分布,样本均值的集中性通常需要有限方差。新结果在仅有 $p$ 阶矩的条件下给出了单侧指数界。中位数均值(median-of-means)估计量是一种对重尾稳健的均值估计方法,新不等式为其偏差提供了更精细的上界。
无界损失的单侧一致风险界:在统计学习理论中,当损失函数无界时,一致风险界通常需要复杂的条件。新结果允许在单侧上界和条件矩假设下,获得无界损失的一致风险界。这对于分析重尾噪声下的学习算法收敛性挺重要的。
这些应用表明,新不等式不仅具有理论美感,还能直接服务于算法分析。
中位数均值估计量
中位数均值(median-of-means, MoM)估计量是一种对重尾分布稳健的均值估计方法。其基本思想是将样本分成若干组,计算每组均值,然后取这些均值的中位数。相比样本均值,MoM估计量在仅有有限方差甚至更低阶矩的条件下就能达到指数集中,因此被广泛用于重尾下的统计推断和机器学习。本文的新不等式为MoM估计量的偏差提供了更精细的单侧上界,尤其是在仅有 $p$ 阶矩($p<2$)时仍能保证指数衰减。这有助于分析重尾噪声下的学习算法收敛性。
与经典结果的对比及潜在影响
经典McDiarmid不等式要求函数满足有界差分条件,即改变任一变量,函数值变化不超过常数 $c_i$。这本质上要求函数对每个变量都是Lipschitz的,且随机变量有界。新结果将条件放宽为:函数几乎必然有上界,且满足条件 $p$ 阶矩假设。当 $p=2$ 时,退化为有限方差情形;当 $p<2$ 时,允许无穷方差。
这一放宽的代价是只得到单侧界,而非双侧界。但在许多应用中,单侧界已足够——例如我们只关心风险不超过某个阈值。
从信息论角度看,反向KL张量化提供了一种新的分析范式。传统集中不等式常通过矩生成函数或熵方法证明,而反向KL散度在变分推断中更自然。这一工作可能促进集中不等式与信息论方法的进一步融合。
总结与展望
这篇论文在重尾集中不等式领域迈出了有意义的一步。通过引入反向KL张量化,作者证明了在仅有单侧有界和条件矩假设下,独立随机变量函数的单侧大偏差仍呈指数衰减。这扩展了McDiarmid不等式的适用边界,并为无界损失的风险分析提供了新工具。
未来可能的方向包括:将结果推广到弱依赖情形、探索反向KL张量化在其它集中现象中的应用、以及研究该不等式在在线学习或高维统计中的具体算法含义。对于从事统计学习理论或重尾数据分析的研究者,这篇工作值得深入阅读。
相关推荐

Meta与出版商的AI数据之争:服务条款修改引爆互联网未来之战
Meta修改商业账户服务条款,允许用关联网站数据训练AI模型,引发出版商和创作者强烈反弹。媒体行业组织联名致信扎克伯格,Meta被迫删除"训练"措辞并推迟条款生效。这场争议揭示了AI时代数据授权与互联网未来的深层博弈。

当Outside Xbox遇上血染钟楼:Minecraft里的军团对局
Outside Xbox嘉宾Ellen和Mike做客Minecraft版《血染钟楼》,迎战军团恶魔局。三名好人如何在信息噪音中对抗多数邪恶?本文解析军团机制、信息角色博弈与终局逆转。

Kimi K3.1实测:开源模型逼近Opus,视频生成意外抢镜
Kimi K3.1在直播实测中完成运动图形、3D渲染、小游戏与视频生成等复合任务。本文分析其2.8万亿参数MoE架构的真实表现、与Opus/GPT的体感差距,以及被官方忽略的视频生成能力,并讨论多模型并用时代的工作流变化。