重新定义法律AI幻觉:从事实错误到"法律授权失败"
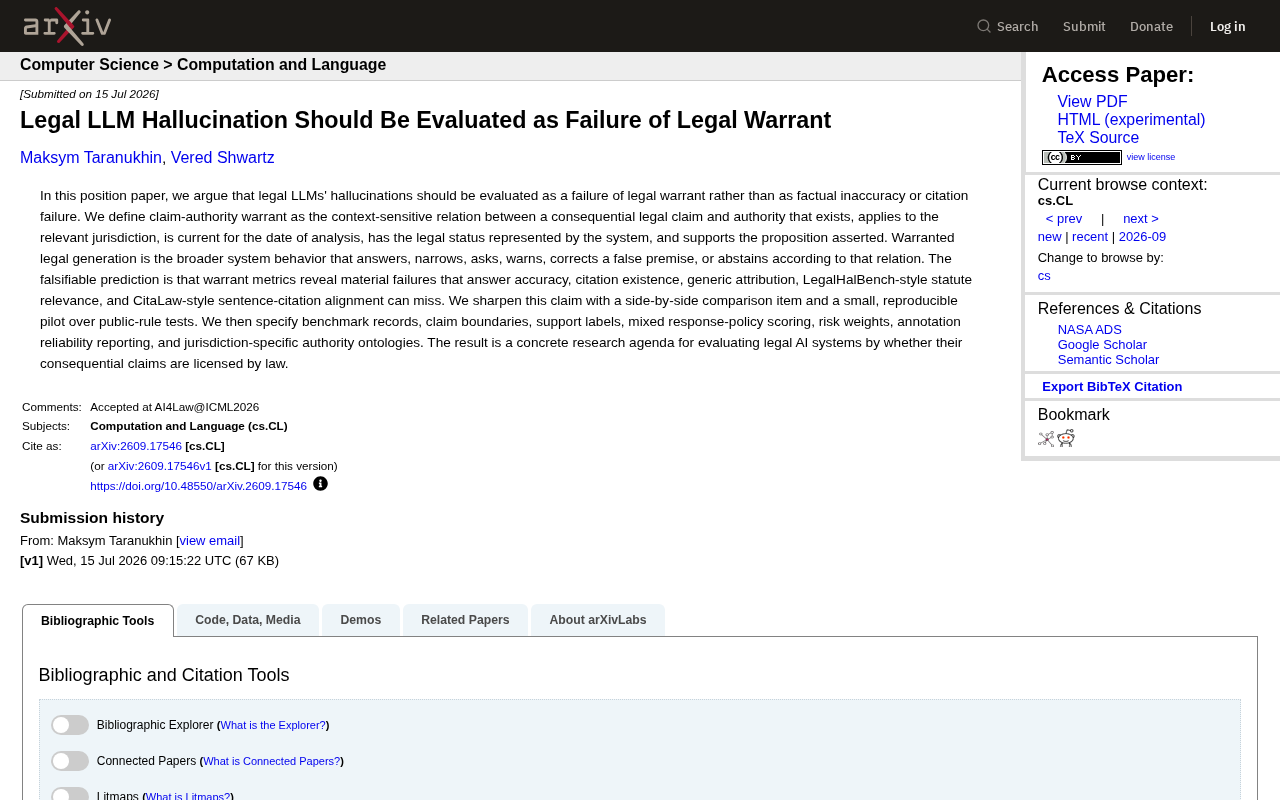
新论文主张法律LLM幻觉应以"法律授权失败"而非事实错误来评估,并提出配套的多维评估框架。
一篇arXiv立场论文提出,法律大语言模型(LLM)的幻觉问题应被重新定义为"法律授权的失败"——即模型给出的法律主张是否真正被现行、适用且具备正确法律地位的权威所支撑,而不仅仅是引用是否存在或事实是否准确。论文核心概念"主张-权威授权"要求权威来源同时满足真实存在、管辖区适用、时效有效、法律地位正确、且确实支持所断言命题五个条件。在此基础上,论文提出"有授权的法律生成"标准,要求系统能灵活选择回答、收窄、反问、警告、纠正或回避等策略,而非一味强行给出答案。作者还指出LegalHalBench、CitaLaw等现有基准存在系统性盲区,并给出包含风险权重、司法管辖区权威本体等构件的可落地评估议程。
一个被忽视的评估盲区
当大语言模型(LLM)被引入法律场景时,"幻觉"(hallucination)问题往往被简单归类为事实错误或引用造假——比如编造一个不存在的判例、引用一条错误的法条。然而,一篇最新的 arXiv 立场论文(arXiv:2609.17546)提出了一个更为根本的视角:法律 LLM 的幻觉,本质上应被评估为法律授权的失败(failure of legal warrant),而非单纯的事实不准确或引用缺失。
这一观点的意义在于,它把评估的焦点从"这段话对不对"转向"这个法律主张是否真正被法律所许可"。对于高风险的法律应用而言,后者才是决定系统能否被信任的核心。
什么是"主张-权威授权"
论文的核心概念是主张-权威授权(claim-authority warrant)。作者将其定义为一种"情境敏感"的关系,即一个有实质后果的法律主张与其所依赖的权威来源之间的关系。这个关系要成立,权威来源必须同时满足多个条件:
- 确实存在——不是模型凭空捏造的法条或判例;
- 适用于相关司法管辖区——某州的规则不能用来支撑另一州的主张;
- 在分析日期上仍然有效——已被废止或修订的法律不能当作现行依据;
- 具备系统所声称的法律地位——比如区分具有约束力的先例与仅供参考的意见;
- 确实支持所断言的命题——引用存在但内容不相关同样构成失败。
换句话说,一条引用可能"真实存在",却依然是错误的授权——因为它管辖区不对、已经过时、或根本不支持结论。传统的"引用是否存在"检测无法捕捉这类深层失败。
这一框架在法律实践中有其深刻的现实根源。普通法体系(如美国、英国、澳大利亚)高度依赖"先例约束原则"(stare decisis),即法院在裁判时须遵循上级法院的既有判决。一个引用若来自无管辖权的法院、或属于"说理意见"(obiter dictum)而非"判决理由"(ratio decidendi),其法律约束力便大打折扣。成文法体系中同样如此:法规可能被修订、废止,或因颁布时间晚于争议事实而不适用。正是这种法律授权的多维性,使得"引用是否真实存在"这一单一维度的检测远远不够——一个引用可以同时"真实"与"无效"。
什么是"有授权的法律生成"
论文进一步提出**有授权的法律生成(warranted legal generation)**这一更宽泛的系统行为标准。一个负责任的法律 AI 系统,不应只会"作答",而应根据主张与权威之间的授权关系,灵活选择以下行为:
- 直接回答(answer)
- 收窄问题范围(narrow)
- 反问澄清(ask)
- 发出风险警告(warn)
- 纠正错误前提(correct a false premise)
- 在缺乏依据时选择回避(abstain)
这套"混合响应策略"的价值在于,它承认在法律场景中,拒绝回答或提示不确定性,往往比强行给出一个看似完整的答案更负责任。这与当前 LLM 倾向于"永远给出答案"的行为形成鲜明对比。
这套响应策略的设计思路,与法律职业伦理中的"能力义务"(duty of competence)和"诚实义务"(duty of candor)高度契合。律师在不确定某一法律问题时,专业规范要求其如实告知当事人不确定性,而非给出未经核实的结论。传统LLM的"过度自信"(overconfidence)问题——即模型在缺乏可靠依据时仍生成语气确定的答案——在法律场景中可能直接导致当事人作出错误决策,产生真实的法律后果。回避(abstain)与警告(warn)并非系统能力不足的体现,而是符合法律职业标准的负责任行为。
为什么现有基准不够用
论文提出了一个可证伪的预测:授权度量(warrant metrics)能够揭示现有评估方法遗漏的实质性失败。作者点名了几类主流评估范式的局限:
- 答案准确率(answer accuracy):只看结论对错,忽略推理是否被法律许可;
- 引用是否存在(citation existence):真实的引用未必适用或相关;
- 通用归因(generic attribution):缺乏司法管辖区和时效的精细校验;
- LegalHalBench 式的法条相关性:难以捕捉授权关系的完整链条;
- CitaLaw 式的句子-引用对齐:对齐层面的匹配无法验证法律地位。
为支撑论点,作者设计了并列对比项,并在公开规则测试集上进行了一个小规模、可复现的试点实验,用以展示授权度量与现有指标之间的差异。
LegalHalBench 和 CitaLaw 是目前法律领域较有影响力的两个幻觉评估基准。LegalHalBench 主要通过构造含有虚假法条的问题来测试模型的识别能力,侧重于检测"是否引用了不存在的规则";CitaLaw 则关注生成文本中的引用句与原始法律文本之间的语义对齐程度。两者的共同局限在于,均以"引用内容的真实性"或"语义匹配度"为核心指标,而未将管辖区适用性、时效有效性和法律地位等维度纳入系统性评估。论文认为,这种设计在实际法律风险面前存在结构性盲区。
一套可落地的研究议程
这篇论文并非停留在概念批判,而是给出了具体的评估框架构件,包括:
- **基准记录(benchmark records)与主张边界(claim boundaries)**的界定;
- **支持标签(support labels)**用于标注权威是否真正支撑命题;
- 混合响应策略评分(mixed response-policy scoring),对回答、回避、警告等不同行为分别计分;
- 风险权重(risk weights),让高后果主张的失败被赋予更高惩罚;
- 标注可靠性报告(annotation reliability reporting),保证评估本身的可信度;
- 司法管辖区特定的权威本体(jurisdiction-specific authority ontologies),把"管辖区"这一维度系统化。
最终目标,是构建一套以"其实质性主张是否被法律许可"为核心的法律 AI 评估体系。
结语:法律AI评估的范式转移
这篇立场论文的价值,在于它把法律 LLM 的可信度问题从"技术准确性"提升到了"法律正当性"的高度。对于司法、合规、法律咨询等高风险场景,一个模型是否"编造"信息固然重要,但更关键的是——它给出的每一个有后果的建议,是否真正站得住脚、被现行且适用的法律所支撑。这一框架若被广泛采纳,可能会重塑法律 AI 产品的测试标准与监管期待。
相关推荐
冰岛Treble获1800万美元融资,押注语音仿真平台
冰岛语音仿真公司Treble完成1800万美元融资,其平台服务于语音AI模型开发者、AI可穿戴设备及机器人公司。本文解析语音仿真技术价值与融资背后的行业信号。
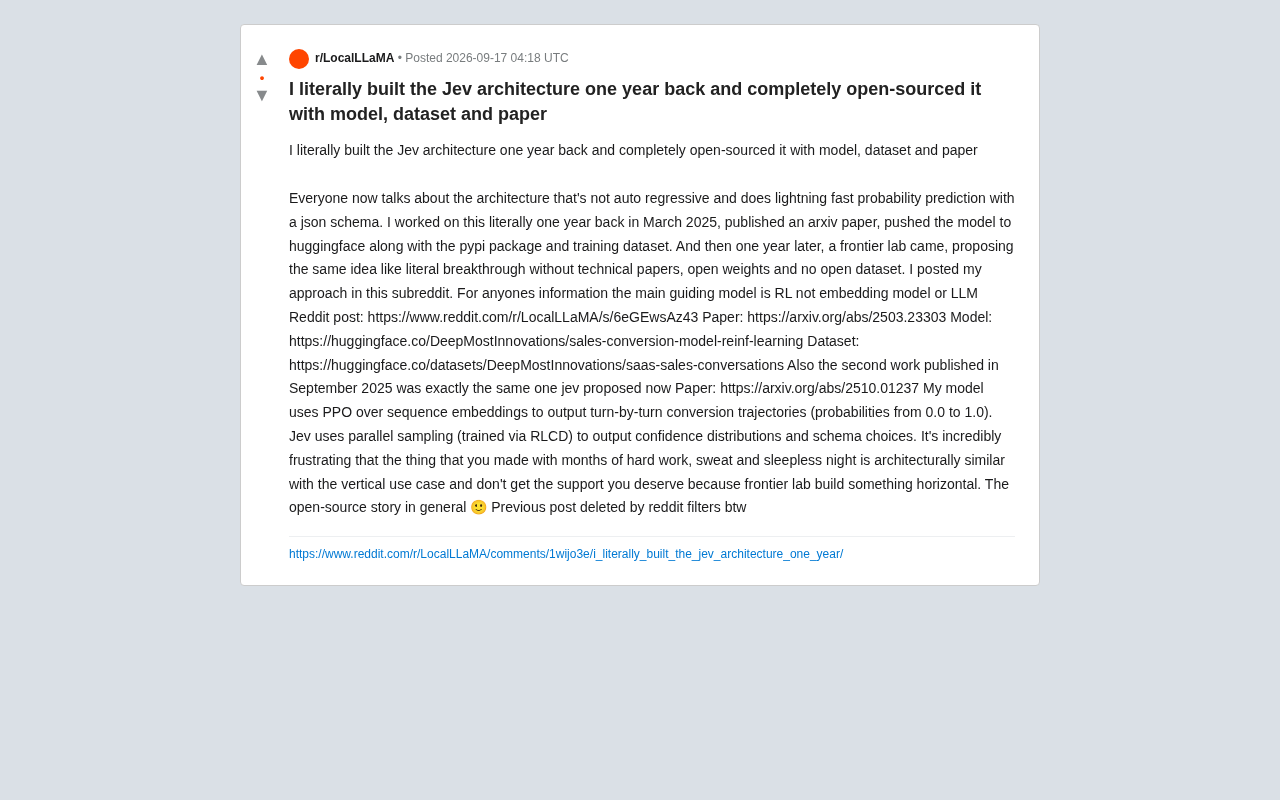
开源之痛:非自回归架构的先行者,为何被前沿实验室抢了风头
一位独立开发者在 Reddit 发帖称,其一年前开源的非自回归 RL 架构,被前沿实验室重新包装为突破。本文拆解 PPO 序列嵌入与 RLCD 并行采样两种路线的异同,并探讨开源生态的溯源与署名困境。
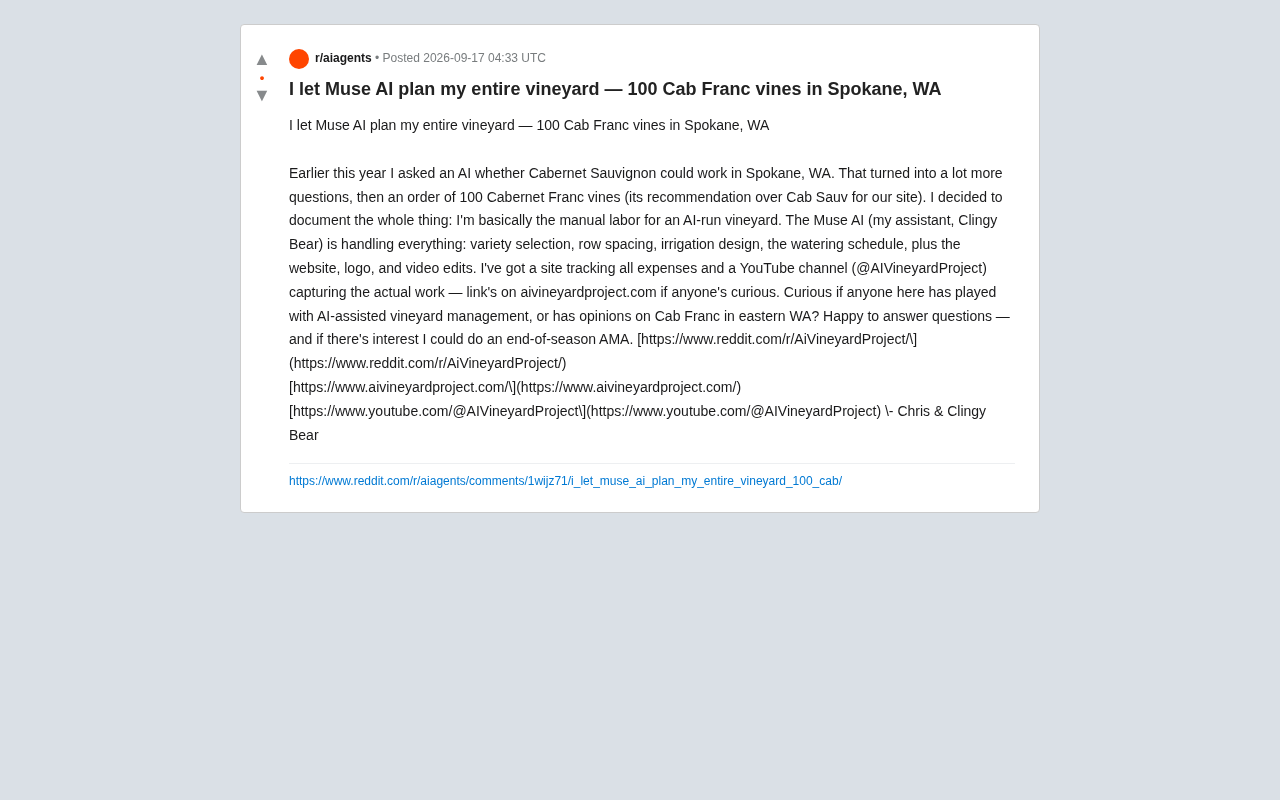
AI全程规划葡萄园:一场100株葡萄藤的真实实验
华盛顿州斯波坎一位爱好者让Muse AI全程规划葡萄园,从品种选择、行距到灌溉全部交给AI,最终种下100株品丽珠。这场AI主导、人类执行的公开实验,揭示了AI辅助农业的机会与边界。