注意力 vs 动态波 vs 混合序列:谁更高效?

动态波循环层与注意力混合质量最佳,但效率优势取决于实现细节。
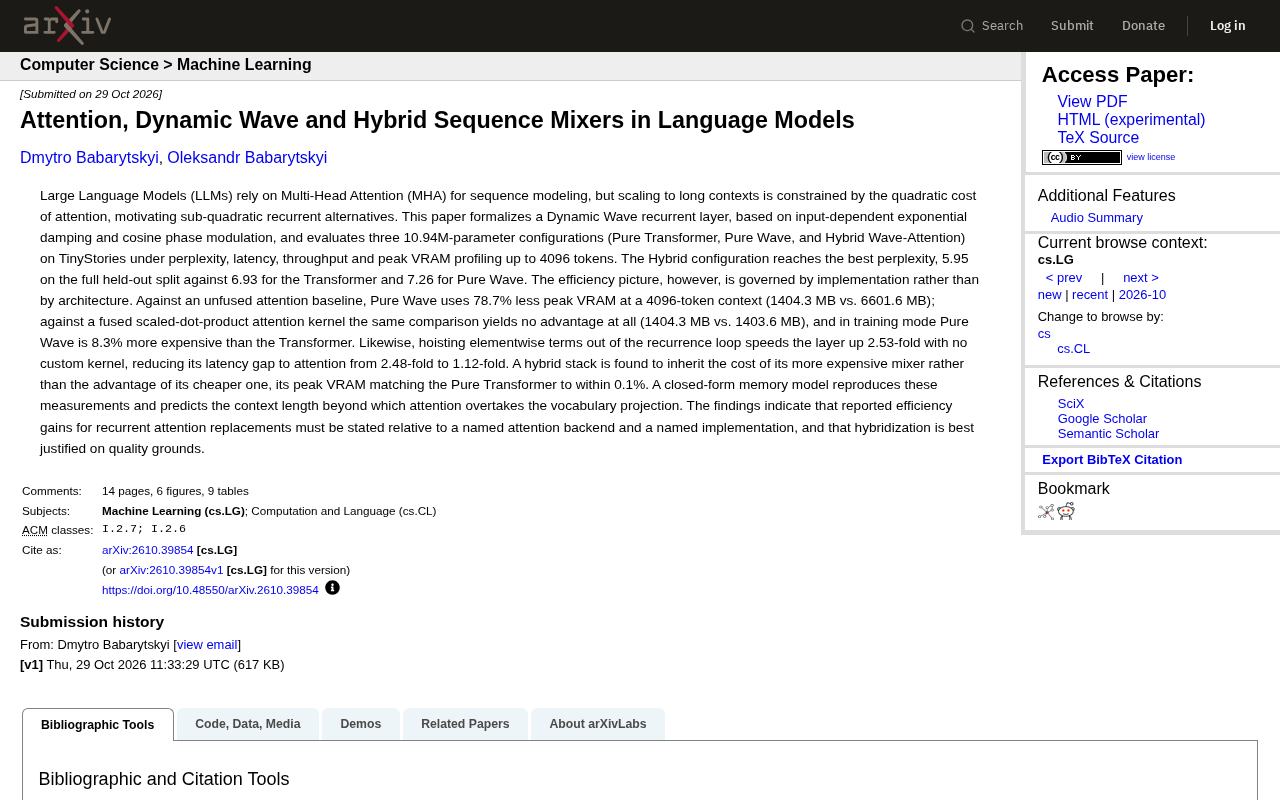
论文系统比较了纯Transformer、纯动态波循环层和混合波-注意力三种配置。在TinyStories上,混合配置取得最佳困惑度5.95,优于纯Transformer的6.93和纯波的7.26,说明混合化的理由应基于质量而非效率。效率结论则完全由实现主导:纯波相对未融合注意力基线降低78.7%峰值显存,但与融合注意力核相比毫无优势,训练时甚至贵8.3%。将逐元素项提出循环外可加速2.53倍,把延迟差距从2.48倍缩小到1.12倍;混合堆栈则继承更昂贵混合器的成本。论文强调报告效率收益时必须指明注意力后端与实现细节。
大语言模型(LLM)依赖多头注意力(MHA)进行序列建模,但二次方的计算成本限制了长上下文扩展,催生了各种亚二次方的循环替代方案。最近一篇论文提出了动态波(Dynamic Wave)循环层,并系统比较了纯Transformer、纯波和混合波-注意力三种配置。结果发现,混合配置在质量上胜出,但效率优势高度依赖实现细节——当与融合的注意力核对比时,纯波的内存优势完全消失,训练时甚至更贵。
动态波层:输入依赖的阻尼与相位调制
论文形式化了一个动态波循环层,其核心是输入依赖的指数阻尼和余弦相位调制。这种设计试图在保持循环结构亚二次方成本的同时,引入更灵活的动态行为。作者在TinyStories数据集上评估了三种参数量均为10.94M的配置:纯Transformer、纯波和混合波-注意力,覆盖困惑度、延迟、吞吐量和峰值显存等指标,上下文长度最高到4096个token。
多头注意力(MHA)的二次方成本指标准自注意力在序列长度 n 上的计算量为 O(n²·d)(d 为隐藏维度),因为每个 token 需要与所有其他 token 计算注意力权重。这种二次方增长使得上下文从 4K 扩展到 128K 时,算力和显存需求呈平方级上升,成为长上下文建模的主要瓶颈。
亚二次方循环替代方案通常以循环神经网络(RNN)或状态空间模型(SSM)为基础,其计算量随序列长度线性增长(O(n·d))。这类模型通过一个压缩的隐藏状态逐步处理序列,避免显式存储全部成对注意力权重。代价是状态容量有限,在需要精确长程检索的任务上可能损失质量,这也是后续混合配置试图弥补的缺口。
质量对比:混合配置 perplexity 最优
在完整的留出集上,混合配置取得了最好的困惑度5.95,纯Transformer为6.93,纯波为7.26。这说明单纯用循环层替换注意力会损失质量,而将两者混合能弥补这一差距。论文指出,混合化的理由最好基于质量,而非效率。
**困惑度(perplexity)**是语言建模的标准评估指标,定义为每个 token 平均负对数似然的指数,数值越低表示模型对留出文本的预测越准确。在相同词表和数据划分下,困惑度可以跨架构直接比较,因此论文用它来量化三种配置的质量差异。需要注意的是,困惑度差异较小(如 5.95 与 6.93)在绝对数值上看似不大,但在语言建模中通常对应可感知的生成质量差距。
效率真相:实现决定一切
效率图景则完全由实现而非架构主导。与未融合的注意力基线相比,纯波在4096 token上下文下峰值显存降低78.7%(1404.3 MB vs. 6601.6 MB);但与融合的缩放点积注意力核相比,同样的比较毫无优势(1404.3 MB vs. 1403.6 MB),且训练模式下纯波比Transformer贵8.3%。
此外,将逐元素项提出循环外可在无需自定义核的情况下将层加速2.53倍,使其与注意力的延迟差距从2.48倍缩小到1.12倍。混合堆栈则继承了更昂贵混合器的成本,而非更便宜一方的优势,其峰值显存与纯Transformer的差距在0.1%以内。
**融合注意力核(fused attention kernel)**指将缩放点积注意力中的矩阵乘法、softmax、掩码和缩放等多个操作合并到单个 GPU 核中执行的实现,如 FlashAttention 系列。融合能大幅减少显存读写次数和中间张量占用,使注意力的实际显存和延迟远低于朴素实现。因此,将循环层与未融合的注意力基线对比会高估循环层的效率优势;只有与融合核对比,才能反映真实部署中的竞争力。
记忆模型与启示
一个闭式记忆模型复现了这些测量结果,并预测了注意力超越词汇投影的上下文长度。论文的结论是:报告循环注意力替代方案的效率收益时,必须指明所对比的注意力后端和具体实现;混合化的合理性应主要建立在质量提升上。
这些发现提醒研究者和工程师,在评估新型序列混合器时,不能只看架构层面的理论复杂度,实现优化(如核融合、循环外提)可能彻底改变效率结论。对于长上下文应用,选择方案时需要同时考虑质量需求和实际部署环境中的实现成熟度。
闭式记忆模型在这里指用解析公式(而非训练或仿真)描述不同序列混合器在推理时的显存占用随上下文长度变化的模型。它把注意力(随长度线性增长的 KV 缓存)与循环层(固定大小的状态)的显存曲线写成上下文长度的函数,从而复现实测数据,并预测在何种上下文长度下注意力因 KV 缓存膨胀而超越词汇投影等固定开销。这类模型的价值在于把零散的基准测量转化为可外推的部署指导。
相关推荐

触屏MacBook与混乱的苹果:一场刻意为之的冒险
The Vergecast 深入讨论触屏 MacBook Pro 的发布逻辑、ProLed 命名争议、iPad 被 iPhone 与 Mac 两头挤压的困境,以及苹果在 AI 时代如何靠高端硬件维持竞争力。
研究权力50年:Robert Caro的写作与权力洞察
Robert Caro研究权力50年,在访谈中谈Lyndon Johnson的说服力与杠杆、Robert Moses从理想主义到冷酷的变迁、大规模建设的困境,以及传记写作中压缩主题与孤独专注的方法。
2万美元的机器人能替你干家务吗?实测结果令人意外
一段YouTube实测视频展示2万美元机器人如何响应洗碗、关灯、倒垃圾、喂狗等指令。本文分析其真实能力边界、语音交互技术现状,以及家务机器人距离普及还有多远。