专业模型如何击败GPT-6 Astra:湿实验数据成科学前沿的护城河
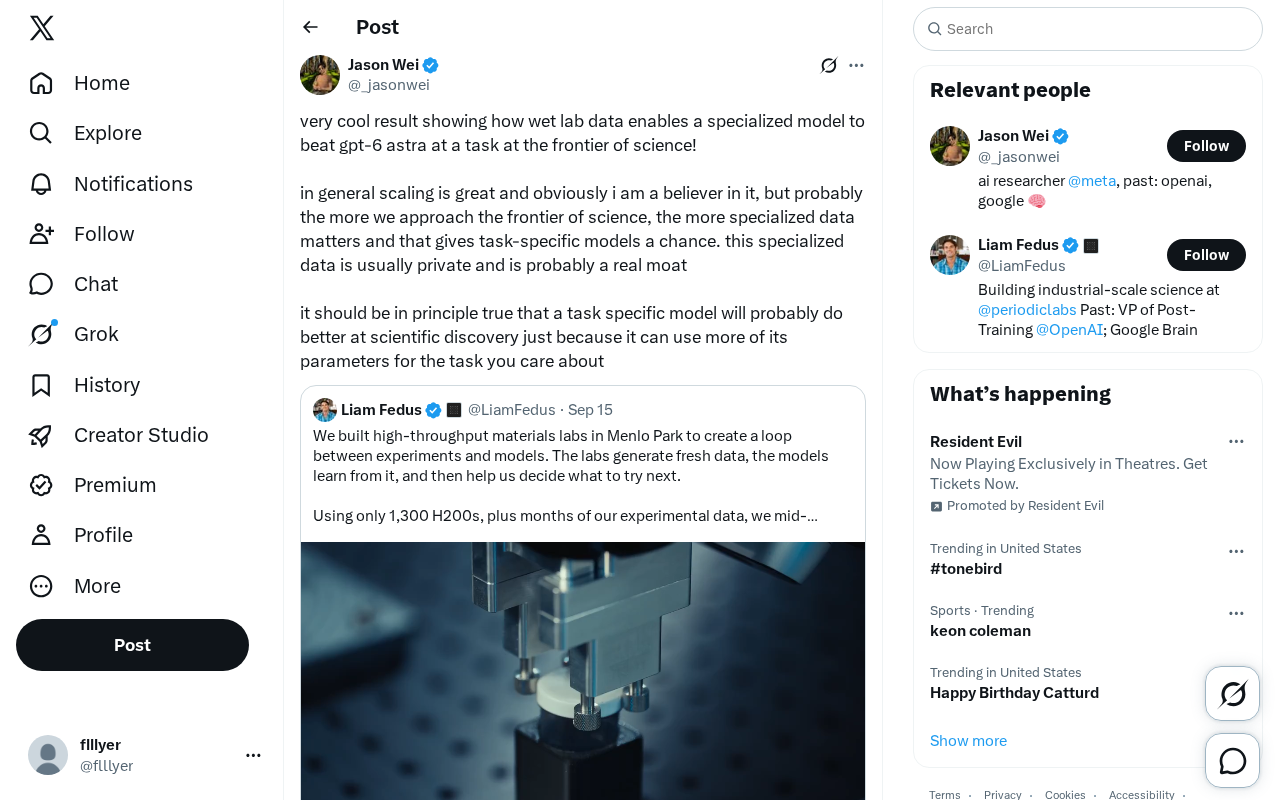
私有湿实验数据驱动的专业模型在科学前沿任务上击败通用大模型,揭示规模化路线的边界。
一个基于私有湿实验数据训练的专业模型,在某科学前沿任务上超越了通用大模型GPT-6 Astra,引发了对规模化叙事边界的讨论。核心论点在于:越接近科学发现的真正前沿,公开互联网数据的价值越有限,而稀缺、私有的实验室数据才是决定胜负的关键资源。这类湿实验数据获取成本极高且通常不对外公开,构成了通用模型难以跨越的数据护城河。与此同时,从技术逻辑上看,专用模型能将全部参数容量集中于目标任务,而通用模型的参数需在海量领域间分配,导致单任务上的有效能力被稀释。这一发现并非否定规模化路线,而是指出其在科学应用场景中的结构性局限,为"专业化模型+私有数据"的路径提供了重要的实证支撑。
一个反直觉的结果:专业模型击败通用巨头
在AI能力持续攀升的当下,一个耐人寻味的结果引发了讨论:一个借助湿实验(wet lab)数据训练的专业模型,在某项处于科学前沿的任务上击败了通用大模型GPT-6 Astra。这个案例之所以值得关注,在于它触及了一个被规模化叙事长期掩盖的问题——当我们逼近科学的真正边界时,通用模型的优势是否还能保持?
提出讨论的观点承认,规模化(scaling)本身是强大的,也表达了对规模化路线的坚定信念。但关键的补充在于:越是接近科学前沿,专业化数据的重要性可能越突出,这恰恰给了任务专用模型(task-specific models)一个真正的机会窗口。
为什么专业数据在科学前沿更重要
通用大模型的训练依赖于海量、公开、可爬取的互联网数据。这类数据在覆盖广度上无可匹敌,但在科学发现的最前沿,真正有价值的往往不是公开信息,而是在实验室里通过湿实验产生的、稀缺的、未被公开的数据。
这正是核心论点的关键:这类专业数据通常是私有的,很可能构成一条真实的护城河(moat)。换句话说,谁掌握了这些数据,谁就在特定科学任务上拥有了通用模型难以逾越的结构性优势。互联网上的公开文本再多,也无法替代一次次真实实验积累出的一手结果。
数据的私有性构成竞争壁垒
在多数AI竞争分析中,模型架构和算力常被视为核心竞争力。但这个案例提示了另一种可能:在科学发现领域,数据的独占性才是决定胜负的关键。当有价值的实验数据被特定机构或企业掌握时,即便对手拥有更大规模的通用模型,也难以在该细分任务上追赶。
**湿实验(wet lab)**是指在真实物理环境中操作生物、化学材料的实验,例如细胞培养、蛋白质表达、基因编辑或化合物合成,以区别于纯计算机模拟的"干实验(dry lab)"。湿实验产生的数据具有几个显著特点:获取成本极高(每组数据可能需要数周甚至数月的实验周期与大量耗材)、高度依赖特定机构的设备与专业人员、实验结果往往不发表于公开论文而作为内部知识积累。这与互联网文本数据的"低边际成本复制"形成鲜明对比。正因如此,拥有大规模湿实验流水线的机构——如大型制药公司或专业生物技术实验室——所积累的数据,在本质上就无法被网络爬取所触达,形成了一道物理意义上的数据壁垒。
参数分配的技术逻辑
除了数据层面的解释,还有一个技术层面的论证值得展开。原则上,任务专用模型在科学发现上表现更好是有道理的——因为它可以把更多的参数用于你真正关心的那个任务。
通用大模型需要在数以万计的任务、领域和语言之间分配其参数容量。这意味着任何单一任务实际能调动的模型能力,都被稀释了。而一个专门为某项科学任务训练的模型,可以将全部参数容量集中投入到这个方向上,从而在该任务上实现更高的"专注度"和表现上限。
这一逻辑与"通才 vs 专才"的经典权衡高度一致:广度和深度之间存在天然的张力。当任务足够专、足够难时,深度的价值会压过广度。
从神经网络的容量分配角度来看,一个具有固定参数量的模型本质上是在用有限的"表示空间"拟合训练分布。通用大模型的训练目标覆盖代码、自然语言、数学、常识推理等数十个领域,参数必须同时服务于所有这些方向,导致分配给任何单一领域的有效容量相对有限。专用模型则可以将同等甚至更少的参数全部投射到目标任务的特征空间中,这在统计学习理论上对应更低的假设空间复杂度和更紧的泛化界。此外,专用模型的输入-输出格式、损失函数设计、数据增强策略均可针对目标任务定制,而通用模型受制于需要兼容多任务的训练范式,难以做到同等程度的任务对齐。这一机制在样本稀缺的科学前沿场景下尤为关键——少量高质量专业数据配合高度对齐的模型结构,往往优于海量通用数据训练出的大模型在该细分任务上的迁移表现。
对AI发展路线的启示
这个案例并不是对规模化路线的否定,而是对其边界的一次澄清。规模化在处理通用问题、覆盖广泛知识时依然极具价值,这一点没有争议。但它提醒行业:规模化不是万能钥匙。
对于致力于科学发现的团队而言,这意味着几件事:
- 拥有独特湿实验数据的机构,可能在AI辅助科研中占据难以复制的优势;
- 押注单一超大通用模型解决一切科学问题的策略,或许并非最优;
- 专业化模型 + 私有数据的组合,可能是科学前沿AI落地的一条务实路径。
值得说明的是,该讨论目前基于单一来源的观点分享,具体的实验设置、任务定义和对比细节尚未充分公开。但其提出的核心张力——规模化的普适性与专业数据的稀缺性之间的博弈——是当前AI科学应用中一个真实且重要的议题。
结语:护城河可能藏在实验室里
当越来越多资源涌向更大的通用模型时,这个结果像是一个温和的提醒:在科学的最前沿,胜负手可能不在参数规模,而在于谁掌握了别人拿不到的数据。湿实验数据的私有性,或许正是下一阶段AI科研竞争中最被低估的护城河。
相关推荐
OpenCode 入门到实战全攻略:AI编程工具安装与配置指南
OpenCode 是一款开源 AI 编程工具。本文梳理其入门到实战全流程:桌面端与 WSL 两种安装方式、模型与规则配置、Agent 分类、自定义命令工具、MCP 服务集成及 SQL 复用,助你系统上手 OpenCode。
10美元AI编程套餐怎么选?Go与Code额度对比拆解
DeepSeek涨价后,10美元AI编程套餐Go和Code怎么选?本文按Mimo、千问、DeepSeek V4、Kimi等常用模型逐一对比两家额度,揭示总额度背后的选购逻辑与请求次数口径陷阱。
多LLM对话真能提升任务表现吗?一个严谨实验设计的启示
一位研究者设计了一套严谨的对照实验,试图隔离多LLM来回对话与单向共享、自我精炼等机制的真实增益。本文解析其实验设计、预算核算与三个开放问题,为多智能体研究提供参考。