自博弈AI打分越高,对战人类越差?Minecraft剑术实验揭示负相关

Minecraft自博弈剑术实验发现机器人评判力与人类评判力显著负相关。
一位开发者在Minecraft原版1v1近战环境中训练自博弈剑术智能体,并用本人7场决斗、约8800个决策的人类数据做试点评估。结果发现,13个检查点的价值头在人类对战中的判断力全部为负,且机器人对战判断力与人类对战判断力的Spearman相关系数为-0.73(p=0.01),即越擅长评判机器人越不擅长评判人类。对手模型的记忆增益也被证明是基线伪影:多数按键基线准确率达83.1%,所有检查点均未超过。专用行为克隆玩家模型有效(2.44 vs 4.20 nats/decision),但加入LSTM记忆反而损失0.035 nats。作者强调正确基线与预注册设计的重要性,并警示用机器人成绩筛选模型可能选出对人类最差的智能体。
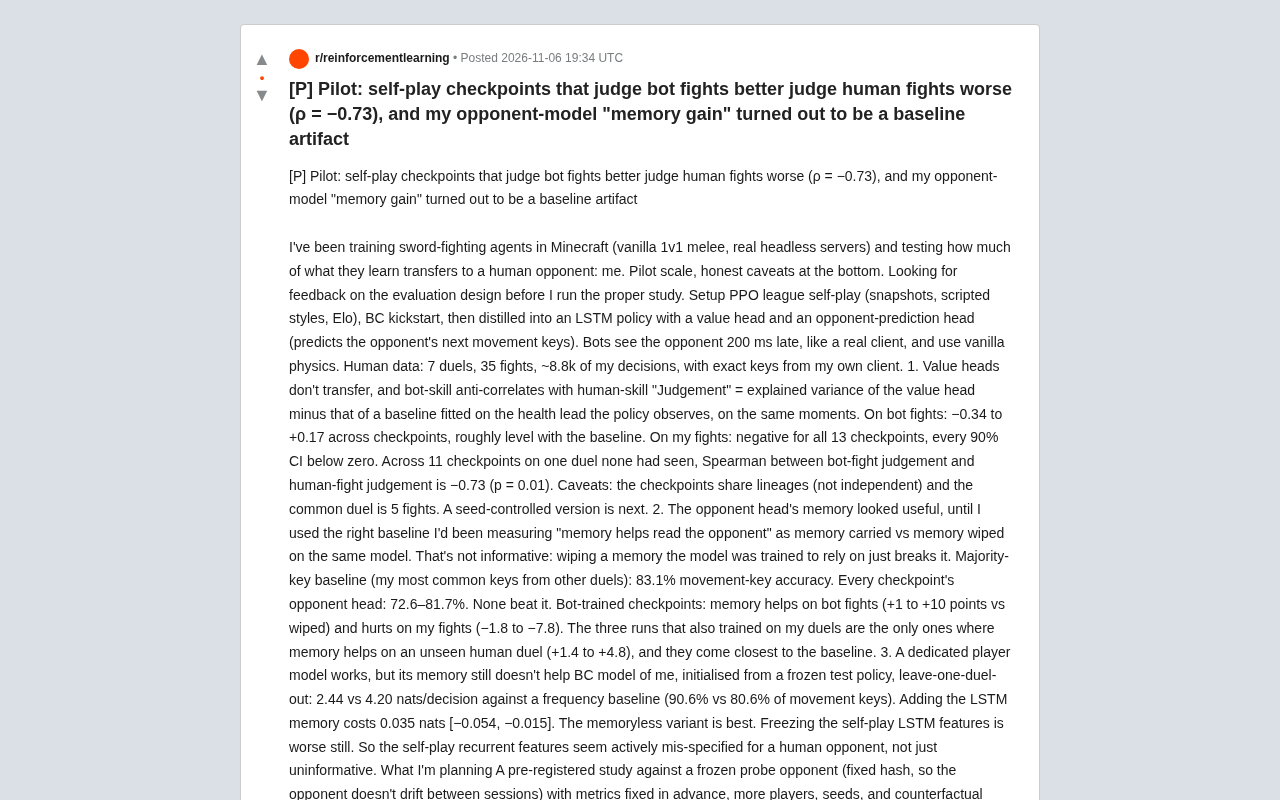
在游戏AI领域,自博弈(self-play)训练出的智能体在对抗机器人时表现优异,已是共识。但一个关键问题始终悬而未决:这些能力有多少能迁移到真实人类对手身上?一位开发者在Reddit上分享了他在Minecraft剑术对战中的初步实验,结果令人意外——自博弈检查点评判机器人对战的能力,与评判人类对战的能力呈显著负相关(Spearman ρ = −0.73, p = 0.01)。
实验设置:从自博弈到人类数据
作者在Minecraft原版1v1近战环境中训练剑术智能体,使用真实无头服务器。训练流程包括PPO联赛自博弈(快照、脚本风格、Elo)、行为克隆(BC)启动,然后蒸馏为带价值头和对手预测头的LSTM策略。为模拟真实客户端延迟,机器人看到对手的状态延迟200毫秒,并使用原版物理。
人类数据来自作者本人:7场决斗、35场战斗、约8800个决策,包含自己客户端的精确按键。这构成了一个“试点规模”的数据集,作者也坦承样本量有限。
PPO联赛自博弈指用近端策略优化(Proximal Policy Optimization)训练多个策略变体组成“联赛”,让它们互相博弈以提升鲁棒性。联赛中通常包含历史快照(防止策略遗忘)、脚本风格(如激进或保守的规则型对手)以及基于Elo评分的匹配机制,使训练环境保持多样性。行为克隆启动则是先用人类或脚本数据对策略做监督学习,再进入强化学习微调,以缓解稀疏奖励下的冷启动问题。蒸馏为LSTM指将联赛中多个策略的知识压缩到一个带记忆单元的长短期记忆网络中,同时附加价值头(预测胜率或血量优势)和对手预测头(预测对手下一步动作),从而在部分可观测的延迟环境下做决策。
价值头不迁移:机器人越强,人类评判越差
作者定义“判断力”(Judgement)为价值头解释方差减去基于策略观察到的血量领先拟合的基线解释方差(同一时刻)。在机器人对战中,13个检查点的判断力在−0.34到+0.17之间,大致与基线持平。但在人类对战中,所有13个检查点的判断力均为负,且每个90%置信区间都低于零。
更关键的是,在一场检查点从未见过的决斗中,11个检查点的机器人对战判断力与人类对战判断力之间的Spearman相关系数为−0.73(p=0.01)。这意味着,在机器人对战中判断更准的模型,在人类对战中反而更差。作者也指出,这些检查点共享血统(非独立),且共同决斗仅5场,需要种子控制实验进一步验证。
解释方差(explained variance)衡量价值头预测值与实际回报之间的一致性,取值上限为1,等于0表示与均值基线相当,负值则说明预测比直接用均值还差。作者用“价值头解释方差减去血量领先回归基线”来定义判断力,是为了剔除一个简单信号:仅凭当前血量领先就能预测胜负的部分。若价值头不能超过这个基线,说明它没有学到额外的局势判断能力。Spearman相关系数是非参数秩相关指标,适用于样本量小、分布未知的场景;ρ=-0.73意味着检查点的机器人判断力排名与人类判断力排名几乎相反,而p=0.01在仅11个检查点下已属显著,但作者也提醒检查点非独立、共同决斗仅5场,存在伪重复风险。
对手模型的“记忆增益”是基线伪影
作者原本用“有记忆 vs 擦除记忆”来衡量对手模型记忆是否有助于读取对手。但擦除模型训练时依赖的记忆只会破坏它。改用多数按键基线(从其他决斗中统计作者最常用的按键):83.1%的移动按键准确率。而每个检查点的对手头准确率在72.6%–81.7%之间,无一超过基线。
机器人训练的检查点:记忆在机器人对战中帮助(+1到+10个百分点),在人类对战中反而有害(−1.8到−7.8)。只有三个在人类决斗上也训练过的运行中,记忆对未见人类决斗有帮助(+1.4到+4.8),但也只是最接近基线。
专用玩家模型有效,但记忆仍无益
作者行为克隆了一个“我”的模型,从冻结的测试策略初始化,采用留一决斗交叉验证:2.44 vs 4.20 nats/decision,对照频率基线(移动按键准确率90.6% vs 80.6%)。加入LSTM记忆反而损失0.035 nats([−0.054, −0.015]),无记忆变体最佳。冻结自博弈LSTM特征更差。这表明自博弈循环特征对人类对手可能是主动错误设定,而不仅仅无信息。
nats/decision是以自然对数计算的交叉熵损失,数值越低表示模型对下一个决策的预测越准。2.44 vs 4.20 nats/decision意味着专用玩家模型比频率基线减少了约1.76 nats的不确定性,对应困惑度从约67降到约11,提升非常明显。留一决斗交叉验证指每次留出一场完整决斗作为测试集,用其余决斗训练,避免同一场决斗内的相邻决策泄漏到测试集,从而更严格地评估泛化。冻结自博弈LSTM特征指把自博弈策略的循环层输出作为固定特征输入玩家模型,不再更新;效果更差说明这些特征携带的是机器人对抗的抽象,而非人类行为模式,直接复用会引入错误设定。
下一步与开放问题
作者计划进行预注册研究:对抗固定哈希的冻结探针对手、预先固定指标、更多玩家和种子,并从记录状态做反事实回放以测试玩家模型标记的行为习惯。
他提出几个问题:血量领先回归是否是格斗游戏价值头质量的公平基线?对手建模中多数按键加无记忆模型是否是正确的基线组合?机器人水平与人类水平负相关是否在文献中已知(除Overcooked等人类-AI协作工作外)?以及,在人类玩家极少的情况下如何设计实验使结果有意义?
启示:评估设计比训练更重要
这个试点研究虽小,却暴露了自博弈评估的一个盲区:在机器人对战中优化的指标,可能系统性地偏离人类对战表现。负相关意味着,若用机器人对战成绩筛选模型,可能选出对人类最不友好的智能体。作者强调的“正确基线”问题同样关键——多数按键基线简单却强力,提醒我们许多“增益”可能只是基线选择不当的伪影。
对于游戏AI和人类-AI交互研究者,这项工作的价值不在于结论的确定性,而在于它展示了如何严谨地质疑自己的评估方法。作者主动分享负面结果和不确定性,正是健康科研实践的体现。
(注:本文基于Reddit帖子内容,实验规模为试点级别,结论需更大样本验证。)
相关推荐
 科技前沿
Textly:Mac上任意位置抓取文字和表格的效率神器
Textly是一款Mac菜单栏效率工具,支持从截图、PDF、视频和应用中框选捕获文字与表格,保持行列完整并导出CSV、Markdown、TSV,还内置即时翻译和剪贴板历史。
 科技前沿
Frameboy:World Labs Atlas 世界模型浏览器实时体验
World Labs 在 Product Hunt 发布 Frameboy,基于 Atlas 世界模型的浏览器实时演示,移动相机即可在云端 GPU 生成新视角,最高 15 fps 串流,探索 AI 生成的可漫游世界。
 科技前沿
Keypause:一键锁定Mac键盘,清洁时不再误触
Keypause是一款Mac菜单栏应用,一键锁定键盘所有按键,方便清洁时避免误触。本文介绍其功能、使用体验、潜在风险及适用场景,帮你判断是否值得尝试。