自建推理栈:专用GPU上跑生产级AI Agent的实战指南

在专用GPU上用Kubernetes与vLLM自建推理栈,量化、投机解码与并发调优的实战路径。
文章基于Akamai的一场技术工作坊,讲解如何在Kubernetes集群的专用GPU上自建生产级AI Agent推理栈。先分析自建与租用API的取舍:数据主权、成本可控与深度调优是自建收益,但需高频稳定负载才能摊薄GPU成本。基础设施采用LKE加vLLM,借助continuous batching、PagedAttention和OpenAI兼容API获得生产特性,同时需网关补齐路由、鉴权与限流。显存规划上,模型权重与KV Cache是零和关系,Qwen3 4B在BF16下权重占8GB,剩余约可容纳37000 token。BF16转FP8实测吞吐提升约1.42倍,但32并发后首token延迟急剧恶化。投机解码配置得当可提速1.5到3倍,drafter不匹配则吞吐暴跌。最终方法论是一次只改一个参数、每次跑负载测试,找到吞吐与延迟的膝盖点。
自建推理栈:专用GPU上跑生产级AI Agent的实战指南
当你的AI Agent每天要处理几十万token、需要多轮工具调用、还要保证数据不出私域时,继续按token向API提供商付费,账单和延迟都会成为瓶颈。Akamai开发者布道师DeJuan Lightfoot与高级软件工程师Omer在B站的一场技术工作坊中,完整演示了如何把"租来的智能"变成"自己的推理能力"——从GPU选型、vLLM调优,到量化压缩与投机解码,全部在Kubernetes集群上实战完成。
本文基于这场工作坊的完整内容,梳理出自建推理栈的关键决策点与调优路径。
为什么要把推理拿回来自己跑
DeJuan在开场时回忆,他2023年初构建第一个Agent时,还只能靠Python手动解析prompt再拼接工具调用结果。那种模式下"很快就会变得非常昂贵"。换用本地小模型后又遇到新问题:能力不足、显存不够、长上下文撑不住多轮对话和工具调用。
自建推理的核心收益有三点:数据主权(请求和模型权重都不离开自有集群或VPC)、成本可控(高频稳定负载下,租用GPU比按token计费更划算)、深度调优空间(可以自由修改批处理策略、量化精度、显存分配)。据DeJuan给出的测算,每天处理20万token的托管调用月费约1500美元,而租一块专用GPU约1000美元——但前提是这块卡要持续跑满,否则就是在为闲置付费。
反过来,流量低且突发、团队缺乏运维经验、或者必须用到顶级闭源模型的能力时,租用API仍然是更理性的选择。
基础设施栈:Kubernetes + vLLM + 专用GPU
工作坊的环境是Akamai的LKE(Linode Kubernetes Engine)集群,200多个GPU节点,每位参与者分到单卡RTX 4000 ADA的独立namespace,内含Jupyter Notebook和一个vLLM推理端点。
Omer重点介绍了这块卡的关键参数:20GB显存、360GB/s内存带宽、大量CUDA核心。高带宽意味着decode阶段快,高TFLOPs和大CUDA核心数意味着prefill阶段快。单节点最多可扩展至4卡、80GB显存,足以放下中等规模模型。
选择vLLM而非Ollama作为推理引擎,原因在于生产特性:开箱即用的continuous batching、PagedAttention(工作坊中称page retention)、OpenAI兼容API。DeJuan用校车比喻解释continuous batching——静态批处理必须等一车孩子全下车才能接下一批,而continuous batching可以边下边接,在prefill阶段对KV cache的利用效率高得多。
需要注意vLLM的边界:一个端点只服务一个模型,多模型需要模型路由网关;支持认证但不支持授权;没有速率限制。生产环境通常要在前面加一层网关(如agent gateway、KServe)处理路由、鉴权和限流。
PagedAttention 与 KV Cache 的关系
PagedAttention 是 vLLM 的核心创新,灵感来自操作系统的虚拟内存分页。传统推理引擎会为每个请求预留一段连续的显存来存放 KV Cache,由于生成长度不可预知,往往需要按最大长度预留,造成大量内部碎片。PagedAttention 把 KV Cache 切分成固定大小的 block(页),用一张页表把逻辑上连续的 token 映射到物理上不连续的显存块,从而把碎片率从 60%-80% 降到个位数。这对自建推理意义重大:同样的 20GB 卡,采用 PagedAttention 后可用于容纳并发请求的 KV Cache 空间大幅增加,直接决定了你能同时服务多少用户、支持多长的上下文。它也是 continuous batching 能够高效运转的前提——新请求随时加入、旧请求随时退出,页可以动态分配与回收。
显存预算:模型权重与KV Cache的零和博弈
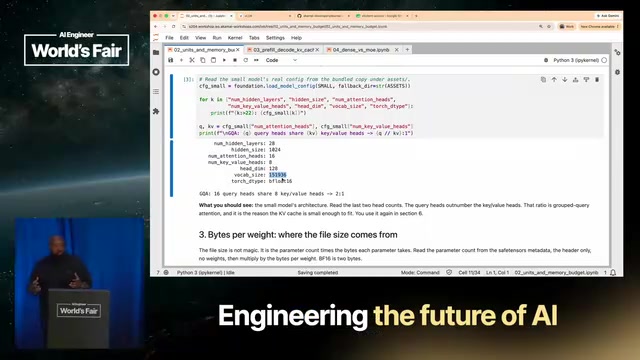
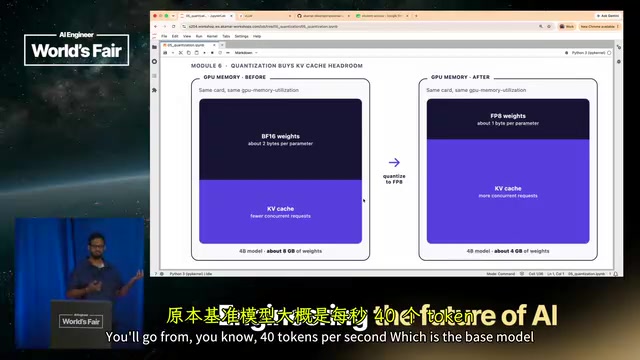
自建推理最容易被低估的部分是显存规划。以Qwen3 4B为例,BF16精度下权重占8GB(参数量×2字节),剩下的显存全部留给KV Cache——也就是能装下多少上下文。
这里有个常被忽视的细节:prefill阶段会把整个prompt读入并存入KV Cache,之后每生成一个token都在更新它,KV Cache会持续增长。系统提示词、工具定义、多轮历史全部要挤在这块空间里。DeJuan给出的实测数据:单卡上扣掉8GB权重后,剩余空间约能容纳37000个token。如果4个用户各发8000 token的请求,就刚好占满。
量化是释放显存的主要手段。BF16降到FP8,权重体积减半,Qwen3 4B从8GB降至约5GB——注意不是精确的4GB,因为部分层被保留在更高精度。据Omer解释,这种"动态"量化策略只压缩注意力头等特定部分,其余保持原精度,以换取质量与性能的平衡。
prefill 与 decode 两阶段的差异
理解显存与性能需要区分推理的两个阶段。prefill 阶段把用户输入的整个 prompt 一次性并行送进模型,计算密集、受 GPU 的 TFLOPs 和 CUDA 核心数约束,同时把每一层的 Key/Value 写入 KV Cache。decode 阶段则是逐 token 自回归生成,每次只算一个 token,但要把此前所有 token 的 KV Cache 全部读一遍,因此是内存带宽密集型,受 GB/s 约束。这解释了两件事:一是为什么高带宽的卡 decode 快,二是为什么 KV Cache 会随生成过程持续增长——它在 prefill 时一次性建立,在 decode 时被反复读取和追加。首 token 延迟主要由 prefill 决定,后续 token 的间隔(TPOT)主要由 decode 和带宽决定,调优时需要分别看待这两个指标。
量化实战:BF16换FP8带来多少收益
Omer展示的对照测试很直观。基线BF16模型在单并发下约37.5 tokens/s,32并发聚合吞吐714 tokens/s,首token延迟61ms。切换到FP8权重后(通过修改vllm.yaml中的模型路径并重新部署),单并发提升到53.4 tokens/s,64并发峰值吞吐从约800提升到1140 tokens/s,约1.42倍。
代价是首token延迟随并发上升明显:32并发时277ms,64并发时跳到1300ms。这个拐点决定了你的服务上限——超过32并发后,吞吐不再增长而延迟急剧恶化,与其硬撑不如停在拐点。
Omer反复强调评估集的重要性:量化后可能出现JSON生成损坏、函数调用失败、模型陷入循环等问题,必须用自有eval集验证。BF16到FP8通常是"可忽略的质量损失",但具体到你的业务场景,只有自己的测试数据说了算。
投机解码:不是万能药,配错了会反噬
投机解码的原理是用一个小型draft模型先行生成若干token,再由主模型并行验证接受或拒绝。据Omer引用的vLLM报告,配置得当时token生成速度可提升约1.5倍;他个人在家庭实验室用Qwen3 35B MoE搭配DFlash drafter,实测有2到3倍提升,编码场景接近3倍,浏览器自动化约1.5倍。
但工作坊故意演示了失败案例:用Qwen3 0.6B作为4B模型的drafter、speculative token数设为4,结果吞吐从58.2 tokens/s暴跌到16 tokens/s,16并发下从700跌到240。原因是这个drafter与主模型不匹配,接受率极低——两个模型都在消耗算力,验证器却不断拒绝草稿token。
结论很明确:优先使用模型官方配套的drafter;没有的话选第三方但必须实测接受率;speculative token数需要反复调参,Omer建议从2到4试起而非贪多。也有参会者提问混合精度(主模型FP8、drafter INT4)的影响,Omer确认精度不匹配会拉低接受率,且drafter本身需要针对主模型蒸馏训练。
接受率(acceptance rate)为何是投机解码的命门
投机解码的收益并非来自 draft 模型“猜得准”,而是来自“猜对时主模型只需一次前向就能验证多个 token”。设 draft 模型一次生成 γ 个候选 token,主模型并行验证后接受其中 α 比例(接受率),则理论上加速比约为 (1-α^(γ+1))/((1-α)(1+cγ)),其中 c 是 draft 与主模型单步开销之比。当接受率很低时,大部分草稿被拒绝,draft 模型的开销纯属浪费,加速比会跌到 1 以下——这正是工作坊中吞吐从 58 跌到 16 tokens/s 的原因。影响接受率的关键因素包括:draft 与主模型是否同源(官方配套 drafter 接受率最高)、两者精度是否一致、任务类型(代码补全等结构化文本接受率高,自由创作低),以及 γ 的取值(过大则后半段草稿大概率被拒)。因此投机解码上线前必须实测接受率,并按业务流量分布调整 γ。
找到吞吐与延迟的"膝盖点"
Module 7的核心概念是saturation——让GPU尽可能长时间满负荷运转。随着并发增加,吞吐会先升后平,延迟则持续攀升,两者曲线的拐点就是最优工作点。在演示中这个点是32并发。
Module 8给出突破瓶颈的方法:一次只改一个参数,每次改动后跑负载测试。关键旋钮包括GPU memory utilization(独占时提到0.9甚至0.95)、max num sequences(工作坊从32提到128后,64并发的吞吐从800升到1100 tokens/s,延迟从2000ms降到800ms)、max model len和batch tokens。如果调优后仍触及理论上限,那就是硬件天花板,需要加卡或换卡。
对于突发流量,Omer提到LKE支持自动扩缩容,也可以基于历史流量建统计模型做预测性扩容。
GPU memory utilization 与 max num sequences 的作用机理
vLLM 启动时的 gpu_memory_utilization(默认 0.9)决定引擎可以占用多少显存比例,剩余部分留给 CUDA context、激活值和框架开销。专用卡独占时可以提到 0.95,但提得过高会因 OOM 导致引擎启动失败或运行中崩溃,需留出安全余量。max_num_seqs 限制单个调度步内同时处理的序列数,它决定了 continuous batching 的批大小上限:设得过小,GPU 在 decode 阶段吃不饱、带宽利用率不足;设得过大,KV Cache 被更多序列瓜分,单序列可用上下文变短,且调度开销和显存压力上升。工作坊中把它从 32 提到 128 后 64 并发延迟反而下降,正是因为更大的批让 decode 阶段更充分地利用了内存带宽。这两个参数与 max_model_len 共同构成显存分配的三方约束,调整任一参数都需要重跑负载测试确认没有触碰天花板。
写在最后
这场工作坊的价值在于它没有停留在"自建更便宜"的口号上,而是把每个决策的代价都摆了出来:量化省显存但可能损质量,投机解码提速度但配错就倒退,提高并发上限能压延迟但受限于显存。真正能榨干专用GPU性能的,不是某个神奇参数,而是"测量—改一个变量—再测量"的循环。所有代码和Notebook都已在Akamai开发者仓库公开,可以拿来在自己的集群上复现。
相关推荐

零成本搭建AI超级员工系统:智能体自动工作流全解析
深度拆解B站演示的AI超级员工系统:Agent智能体编排、数字人口播、地图与企业获客、24小时智能客服及法务模块全覆盖。分析零成本开户背后的商业逻辑与合规风险,帮助创业者判断这套AI数字员工系统的真实投产比。

Chatbot与AI Agent的本质区别:从对话到执行的跨越
Chatbot和AI Agent有什么区别?本文基于Learn Tech频道的MCP系列讲解,用订机票、笔记摘要等实例说明:Chatbot只给答案,Agent通过思考-行动-观察循环真正完成任务,并拆解模型、工具、记忆、目标四大部件及MCP的桥梁作用,同时讨论Agent的适用边界与权限风险。

免费GitHub仓库:342小时AI课程,从数学到MCP服务器
一个免费GitHub仓库提供342小时AI课程,包含523节课、20个阶段,覆盖数学基础到Agent构建和MCP服务器。支持目标驱动学习,每节课产出可留存的prompt、skill或agent,已有近10万人开始学习。