自修复AI芯片构想:一个寻求合作者的硬件开源项目

Reddit帖子提议打造能运行时自我修复的AI芯片,方向有价值但仍处概念招募阶段,技术与资源门槛极高。
一则Reddit帖子提出打造"自我修复AI芯片"并招募合作者,引发了对这一硬件方向的讨论。自修复的核心思路是让芯片在运行中检测局部失效并自动重构,绕过受损单元,而非依赖传统的被动冗余设计。AI加速器由大量重复计算单元构成,天然适合冗余与动态重构,加之大模型训练对稳定性要求极高,使这一方向在AI硬件场景下尤具吸引力。然而,该项目目前仅停留在概念招募阶段,缺乏具体技术路线。将"自修复"落地为可用芯片,需跨越故障检测与资源重映射的技术难题、高昂的流片成本,以及开源硬件协作远比软件复杂的现实。对有意参与者而言,应在投入前先确认项目所处阶段、技术文档完备程度与团队资源储备。
一个大胆的硬件命题
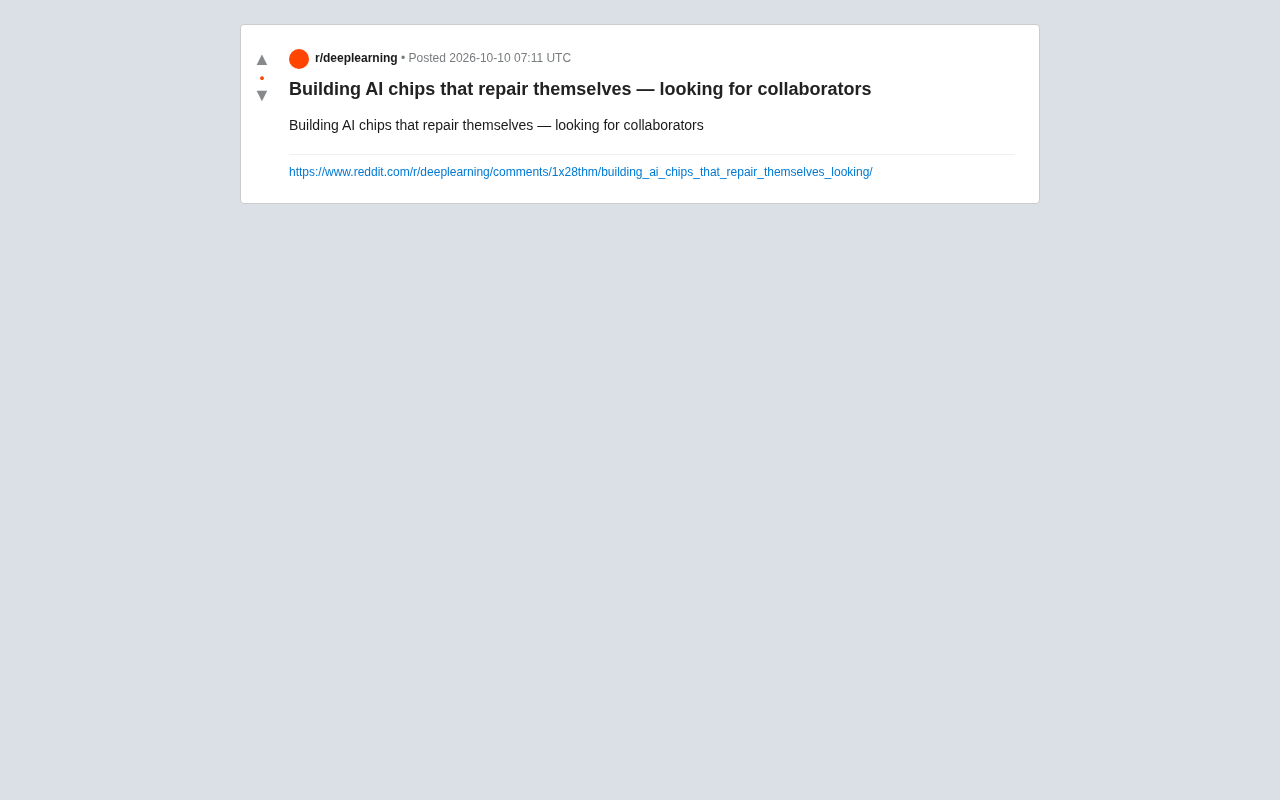
在Reddit社区中,一则标题为"Building AI chips that repair themselves"(打造能自我修复的AI芯片)的帖子引发了关注。发帖者正在探索一个颇具野心的方向:让AI芯片具备自我修复的能力,并公开招募合作者共同推进这一项目。
从标题本身可以看出,这是一个处于早期阶段的硬件探索,发帖者希望借助社区力量把想法变成现实。这类"寻找合作者"(looking for collaborators)的帖子在Reddit的技术板块并不少见,它们往往代表了独立开发者或小团队在验证一个尚未成熟但值得讨论的技术假设。
为什么"自修复芯片"值得讨论
芯片的可靠性一直是半导体行业的核心议题。随着制程不断微缩、晶体管数量指数级增长,单个芯片内部出现局部缺陷或老化失效的概率也随之上升。传统做法是通过冗余设计、纠错码(ECC)和出厂测试来保证良率和寿命,但这些手段大多是"被动防御"。
"自修复"(self-repairing)的思路则更进一步——让芯片在运行过程中检测到局部失效后,能够自动绕过、重构或替换受损单元,从而延长使用寿命、提升容错能力。在AI芯片这一特定场景下,这个想法尤其有吸引力:
- AI加速器通常由大量重复的计算单元(如PE阵列、张量核心)构成,天然适合做冗余与动态重构;
- 大模型训练和推理对硬件稳定性要求极高,单点故障可能导致长时间任务中断;
- 边缘设备和数据中心都面临芯片老化与散热带来的长期可靠性压力。
自修复硬件并非全新概念,学术界已有数十年积累。早期研究集中在NASA等航天领域——卫星和深空探测器无法人工维修,促使工程师探索"重构型容错系统"(Reconfigurable Fault-Tolerant Systems)。典型方案包括在FPGA中预留备用逻辑块(spare logic blocks),当某一区域发生单粒子翻转(SEU, Single Event Upset)等辐射故障时,片上控制器自动将任务重新映射到冗余单元。进入商业半导体领域后,英特尔的SRAM制造中长期使用"冗余行列修复"(Row/Column Repair)技术,通过激光熔断编程将故障存储单元切换到备用阵列,这已是量产芯片的标准工艺。现代HBM显存同样内建Post-Package Repair(PPR)机制,允许在封装后通过电信号修复少量坏行。AI芯片语境下讨论的"自修复",则更强调运行时动态感知与重构,而非出厂前的一次性修复,这在技术复杂度上又高出一个层级。
这类项目的现实挑战
需要清醒看待的是,仅凭一则帖子的信息,这个项目仍停留在概念招募阶段,缺乏具体的技术路线、架构设计或原型数据。将"自修复"从概念落地为可用芯片,面临多重门槛:
技术层面
芯片级别的自我修复涉及故障检测、资源重映射、片上控制逻辑等多个难题。无论是采用FPGA可重构方案,还是在ASIC中内建冗余与自愈电路,都需要在面积、功耗和复杂度之间做权衡。真正能"自我修复"的硬件,往往要牺牲一部分有效算力来换取容错空间。
FPGA与ASIC是实现可重构容错的两条主要路径,二者在自修复场景下各有取舍。FPGA(现场可编程门阵列)的互连结构天然支持运行时重新布线,Xilinx(现AMD)的部分重配置技术(Partial Reconfiguration)已允许在芯片运行时替换特定逻辑区域,是当前学术原型中验证自修复概念最常用的平台,开发门槛相对较低,但性能和能效远逊于定制芯片。ASIC(专用集成电路)则需要在设计阶段就将冗余单元、内建自测试(BIST, Built-In Self-Test)电路和片上重映射逻辑固化进版图,一旦流片便无法更改结构,容错能力上限由设计时的预判决定。对AI加速器而言,PE阵列(Processing Element Array)的高度规则性使得"备用行列替换"方案相对易于实现,但片上网络(NoC)和内存控制器的容错设计则复杂得多,任何重映射都可能引入额外延迟,影响张量运算的流水线效率。
资源层面
芯片设计与流片的成本极高,即便是一次小规模的原型验证也需要可观的资金、EDA工具和制造资源。对于一个在社区招募合作者的早期项目来说,如何组织分布式协作、如何获取流片渠道,都是必须面对的现实问题。
协作层面
开源硬件的协作难度远高于开源软件。硬件迭代周期长、验证成本高、知识产权与制造环节复杂。类似RISC-V生态的成功说明开源硬件并非不可行,但也印证了它需要长期投入和清晰的治理模式。
RISC-V的崛起是开源硬件领域最具说服力的成功案例,但其路径揭示了开源硬件成功所需的特殊条件。RISC-V由加州大学伯克利分校于2010年前后发布,核心优势在于它是一套开放的指令集架构(ISA)规范,而非完整的芯片实现——这使得社区可以在软件层面(编译器、操作系统)和RTL设计层面分别贡献,极大降低了协作门槛。真正推动其商业化的是RISC-V International基金会提供的中立治理框架,以及SiFive等公司将开源IP转化为可流片产品的商业闭环。相比之下,自修复AI芯片的开源协作面临更高壁垒:它不仅需要统一的架构规范,还需要昂贵的EDA工具链(如Synopsis、Cadence套件,单年授权费可达数十万美元),以及流片渠道(Multi-Project Wafer服务如Google/SkyWater的开放PDK计划降低了部分门槛,但先进制程仍不可及)。这意味着即便技术方案可行,治理模式与资金来源的设计同样决定项目能否持续。
对有意参与者的建议
如果你对这个方向感兴趣,在决定投入前不妨先向发帖者确认几个关键问题:项目目前处于什么阶段(纯概念、仿真、还是已有原型)?打算采用FPGA验证还是直接走ASIC路线?是否有明确的技术文档或开源仓库?团队背景与资源储备如何?
这些信息能帮助判断项目的可行性与你能贡献的价值。对于早期概念型项目,参与者既要保持开放心态,也要对落地难度有合理预期。
小结
"自修复AI芯片"是一个方向正确、但技术与资源门槛都极高的命题。它触及了半导体可靠性、容错架构和开源硬件协作等多个有价值的议题。这则Reddit招募帖目前提供的信息有限,更像是一次抛砖引玉的社区征集,而非成熟的技术发布。对于关注硬件前沿的开发者而言,它值得保持观望并进一步了解,但在投入时间与资源前,务必先摸清项目的真实进展。
相关推荐

Claude Pro不含API权限?Max与Team计划新增API额度详解
Claude Pro订阅不含API访问权限,API需单独计费。但Max和Team计划现已包含每月API额度:Max 5x为100美元,Max 20x为200美元,Team每席位最高合计500美元。本文详解各档位额度、领取方式及对开发者的影响。

隔离环境实测35万星REA:4秒装完,但两个坑要当心
隔离实验室实测35万星开源逆向工程工具REA:4秒安装、15秒列出截图工具全部外联地址、梳理565个通信通道,同时暴露写入用户级设置与31个高风险工具权限两个坑,附三条安全使用规则。
逆向工程+AI Agent:几周克隆Adobe应用的技术真相
逆向工程+AI Agent:几周克隆Adobe应用的技术真相
一位开发者因Adobe提前取消费转向逆向工程,用AI Coding Agent几周内做出7款开源替代品。本文解析逆向工程原理、Reverse Engineer Anything这个MCP Server六天破10万星的原因,以及AI克隆应用在性能、专有数据和法律层面的真实边界。