所有文章
共 37430 篇文章
 科技前沿
Google I/O 2025全面回顾:Gemini如何成为AI战略核心
Google I/O 2025大会上Gemini成为绝对主角,从搜索到开发者生态全面渗透。深度解析Gemini团队阵容、产品整合策略及对AI行业竞争格局的影响,了解Google如何全力押注Gemini反击OpenAI和Anthropic。
 科技前沿
Google I/O 2025快问快答:2分钟互动背后的传播策略
Google I/O 2025社交团队策划2分钟4问快问快答环节,解析科技大会如何通过轻量互动提升社交媒体传播效果,探讨碎片化时代的活动形式创新与内容传播策略。
 科技前沿
Anthropic每月花12.5亿美元租xAI算力,AI竞赛背后的天价交易
SpaceX S-1文件披露Anthropic与xAI签署每月12.5亿美元算力租赁协议,租用COLOSSUS超算集群至2029年,总额约450亿美元。竞争对手之间的算力合作揭示AI行业算力极度稀缺的真实现状。
 产品体验
免费用满血GPT和Gemini?AI聚合平台深度测评与风险分析
深度测评一款号称免费、免翻墙使用GPT、Gemini、Claude等满血版AI大模型的聚合平台,解析其账号池机制、跨模型对话功能,并揭示隐私安全、合规性等潜在风险,附更安全的替代方案推荐。
 教程攻略
ComfyUI本地生成AI漫剧:图像到成片完整制作流程
详解ComfyUI本地AI漫剧制作全流程,涵盖KLEIN图像编辑、LTX首尾帧视频生成、QWEN TTS语音合成等核心环节,仅需4060Ti显卡即可100%本地运行,附实战技巧与避坑指南。
 产品体验
Veo 4.0视频生成效果实测:两段视频吃掉86%算力配额
实测谷歌Veo 4.0视频生成效果,画质接近专业MV水准,但Pro用户生成两段视频即消耗86%算力配额。本文详解Veo 4.0在场景渲染、人物动作、光影表现等方面的实际表现,并分析其算力定价策略对创作者的影响。
 教程攻略
Gemini 3.5免费使用教程:国内无需翻墙直连方案
详解国内免费使用Gemini 3.5的方法,无需翻墙、无需注册即可体验。实测Gemini 3.5代码生成能力,对比3.1版本生成《我的世界》网页游戏的惊人差距,附多模型聚合平台使用建议与风险提示。
 产品体验
DeepSeek V4 vs Qwen3.6实测:8大类150场景深度对比评测
使用BenchLocal工具对DeepSeek V4 Pro、V4 Flash与Qwen3.6 27B进行8大类85场景实测对比,涵盖工具调用、代码调试、推理数学等维度,V4 Pro总分领先6%但数学推理意外翻车,Qwen3.6 Q6在智能体场景媲美V4 Pro。
 产品体验
Qwen3.6-27B开源模型评测:27B参数实现旗舰级代码与多模态能力
阿里Qwen3.6-27B开源模型深度解析:270亿参数稠密架构,单卡即可部署,代码生成能力超越前代旗舰。本文详解其技术优势、基准测试成绩、硬件配置方案及实际部署建议,助你低成本获得旗舰级AI编程与多模态理解能力。
 产品体验
Qwen3.6量化版本地部署实测:NVFP4、APEX、Q4、Q6哪个最值得选
实测Qwen3.6系列7-8个量化模型在工具调用、命令行操作、Bug修复、数学推理等8大维度的表现,对比NVFP4、APEX、Q4、Q6量化方案,附总分排名与选购建议,帮你找到最适合本地部署的量化版本。
 产品体验
开源AI桌宠小猫:Qwen 3.5 Omni+ESP32打造全模态智能伙伴
基于Qwen 3.5 Omni全模态模型和ESP32-S3的开源AI桌宠小猫项目,支持情感语音交互、视觉感知、手势互动和一日记录复盘功能。附完整复刻教程,含硬件清单、3D打印模型和代码烧录指南。
 科技前沿
Qwen3.6 35B开源实测逼近Claude,xAI语音克隆API正式上线
阿里开源Qwen3.6 35B模型,256专家MoE架构仅需3B激活参数,SWE Bench成绩逼近Claude Opus。xAI发布Voice Cloning API支持28种语言,NVIDIA开源OpenShell安全沙箱,Sam Altman表态模型智力优先。
 教程攻略
Hermes + Qwen3.6 本地部署教程:零成本搭建私有AI Agent
详细教程教你用Hermes Agent搭配Qwen3.6开源大模型,在本地零成本部署私有AI助手。涵盖WSL环境配置、模型下载启动、Telegram机器人对接及开机自启设置,实现无限Token、数据私有的AI Agent体验。
 产品体验
Qwen3.6 27B三大邪修量化模型实测:代码暴增15.8PP、40B蒸馏、16GB适配
实测对比三款基于Qwen3.6 27B的社区邪修量化模型:OmniMerge V4代码能力提升15.8个百分点,40B OPUS蒸馏版支持角色扮演与创意写作,16GB特化版让小显存也能跑稠密模型。附显存要求、参数设置与选型建议。
 教程攻略
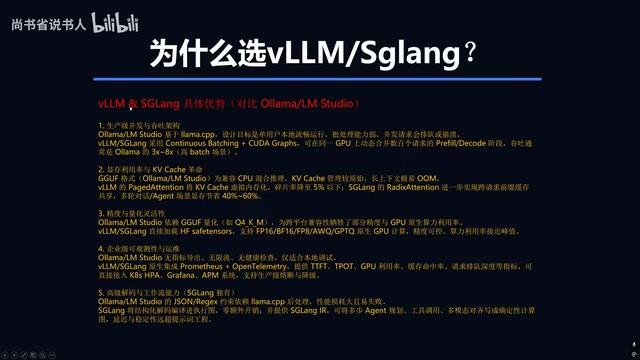
vLLM与SGLang本地部署教程:性能提升3-8倍的实战指南
详解vLLM和SGLang本地部署全流程,对比LM Studio性能差距,通过Docker+AI助手三步完成部署。涵盖SGLang与vLLM选型建议、5090显存优化、Qwen3模型推荐及Cherry Studio接入方法。
 前沿研究
上交大PhyAR:破解Video-LLM物理推理中的语义先验劫持难题
上海交通大学提出PhyAR框架,通过PACC数据集和VARC视觉锚定推理链机制,解决Video-LLM在物理推理中语义先验劫持视觉感知的核心缺陷,无需修改模型架构即可显著提升物理异常检测能力,全面超越GPT-4O等SOTA模型。
 科技前沿
悟空2.2P开源:35B MOE模型性能超越Qwen3.6-27B,速度快3-5倍
悟空2.2P 35B MOE模型正式开源,采用对抗式杂交蒸馏技术,综合性能超越Qwen3.6-27B。4090显卡Q5量化达158 tokens/s,仅需8.9G显存即可运行,支持256K上下文。详解核心技术、硬件配置与实测数据。
 科技前沿
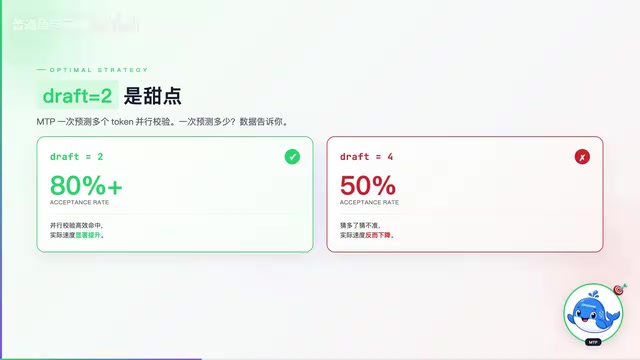
Qwen3.6 MTP加速实测:单GPU推理飙到220 token/s
Qwen3.6实验性MTP-GGUF版本实测,单GPU将35B-A3B模型推理速度提升至220 token/s,比原版快1.4倍且精度零损失。详解MTP原理、最优Draft Tokens策略及RTX 5090实测数据。
 行业洞察
企业大模型选型指南:Llama3.1、Qwen2.5、DeepSeek深度对比
企业如何选择开源大模型?本文从模型能力、硬件需求、业务场景三个维度,深度对比Llama 3.1、Qwen 2.5、DeepSeek、Mistral等主流开源模型,提供选型决策框架与实践建议。
 深度解读
Qwen3.5深度解析:混合注意力架构实现19倍长上下文加速
深入解析阿里开源Qwen3.5模型的混合注意力架构创新,详解Gated Delta Net如何实现256K上下文19倍加速,多模态视觉反超Gemini 3 Pro和GPT-5.2的评测数据,以及RL后训练策略与实际应用Demo。