#端侧AI
共 36 篇相关文章

EmbeddingGemma 2发布:端侧多模态嵌入模型新标杆
Google DeepMind 发布 EmbeddingGemma 2,一款开源轻量级多模态嵌入模型。仅 7.4 亿参数即可在手机端统一处理文本、代码、图像、音频和视频,支持 8K 上下文与离线 RAG,Apache 2.0 许可证商用友好。

NoteWorthy:AI完全本地运行的隐私优先笔记应用
NoteWorthy是一款AI完全本地运行的笔记应用,支持iPhone、iPad和Mac。自动分类、一键结构化、长文摘要全部在设备端完成,不上传服务器,免费、离线、无需账户,主打隐私优先的端侧AI体验。
端侧记忆:构建本地运行的AI语音助手实战课
DeepLearning.AI 联合 Qdrant 推出端侧记忆AI助手课程,教你在本地设备上构建能记忆、检索、遗忘并识别物体的语音助手,掌握嵌入向量与边缘向量搜索引擎的实战应用。

Perplexity 开源大爆发:6款AI模型与工具一次盘点
Perplexity 近期集中开源六款 AI 项目,包括 SoTA 多模态决策模型 pplx-decider、上下文嵌入模型、Apple Silicon 本地推理引擎 Lily、端侧隐私分类器 PII-Tracer 及多款安全工具,覆盖模型、推理与终端安全全链路。

MicroLLM Lab:浏览器里直接体验7款微型大语言模型
MicroLLM Lab 让用户在浏览器中直接体验 7 款微型大语言模型,无需安装即可运行。本文解析端侧 AI、浏览器推理与微型模型的价值与能力边界。

PrismML把微型LLM带进高通智能眼镜:端侧AI的新样本
PrismML宣布将其微型LLM部署到高通芯片智能眼镜,主打开放权重、端侧运行的AI路线。本文解析其技术选择、微型LLM价值与端侧AI趋势。
潜空间蒸馏压缩流式神经音频编码器:苹果端侧语音的内存优化之道
苹果研究通过潜空间蒸馏压缩流式神经音频编码器,解决端侧听写中 tokenizer 与稀疏激活基础模型争夺 DRAM 内存的问题,在降低功耗与延迟的同时保持语音识别质量。
421M参数Laya模型玩转Flappy Bird:CPU上的OpenVINO INT8推理实践
一位开发者用OpenVINO将421M参数的Laya模型量化到INT8,成功在英特尔i7 CPU上运行Flappy Bird游戏。本文拆解OpenVINO转换、INT8量化的技术要点,以及消费级CPU运行数亿参数模型对端侧AI部署的意义。

高通发布两款AI手机芯片:旗舰型号可本地运行300亿参数MoE模型
高通推出两款主打AI的智能手机芯片,其旗舰型号宣称可在本地运行300亿参数的MoE专家混合模型,标志着端侧AI推理能力的重要突破。本文解析其技术意义与现实挑战。
本地16GB跑赢云端:开源模型Laya速度碾压Jev引热议
开源权重模型 Laya 在 16GB MacBook Air 本地运行,玩 Tetris 决策速度比云端 Jev 快 11 倍。本文解析本地推理为何能在延迟敏感任务中击败云端大模型,以及端侧 AI 的现实意义与局限。
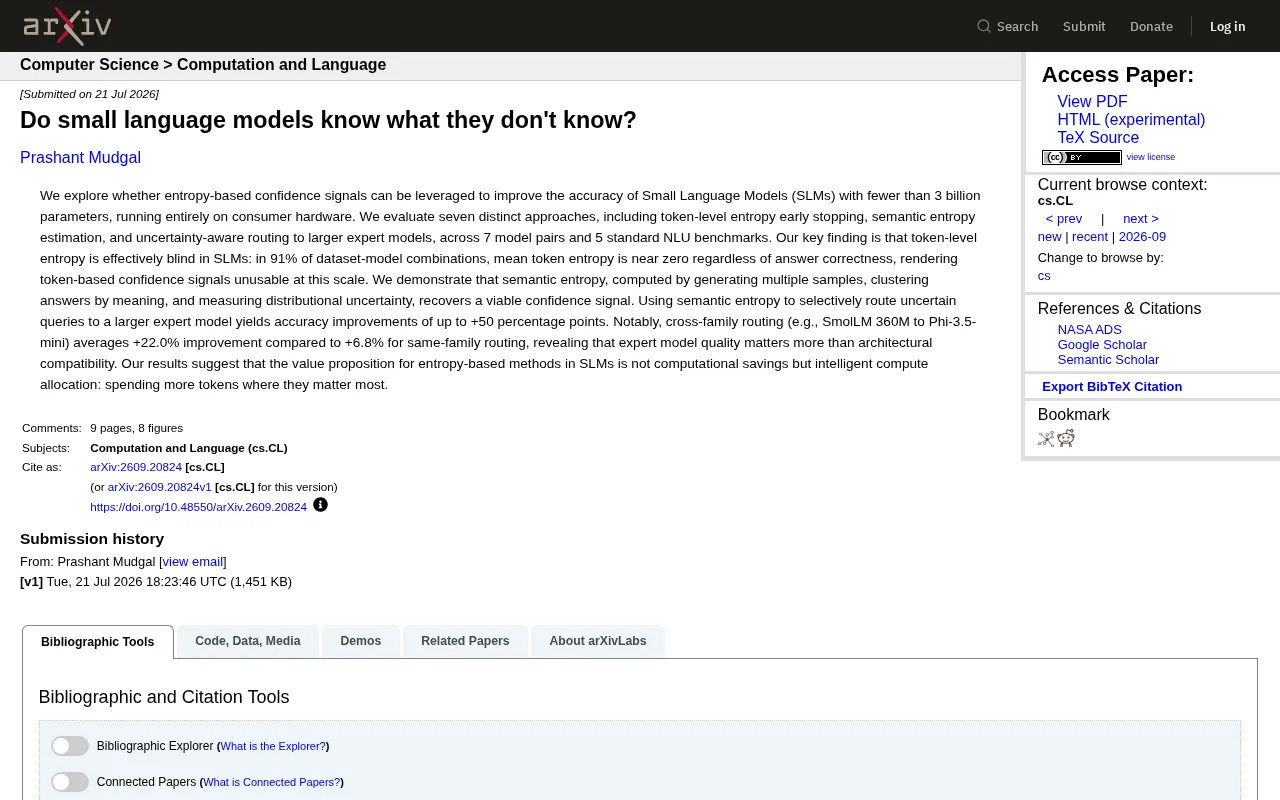
小语言模型知道自己不知道什么吗?语义熵是关键
一篇 arXiv 研究揭示:小语言模型(SLM)的 token 级熵几乎失效,但语义熵能有效捕捉不确定性,并通过路由给专家模型带来最高 +50 个百分点的准确率提升,跨家族路由效果远超同家族路由。
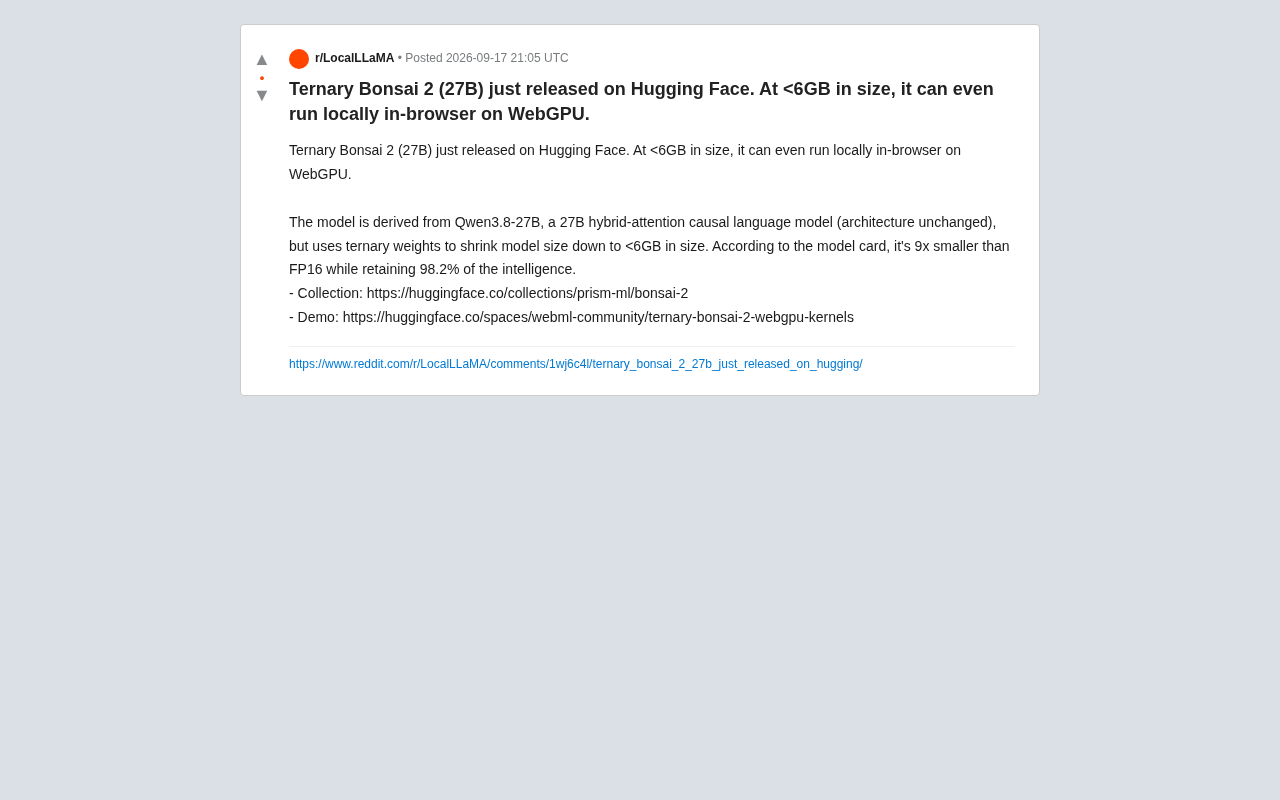
三值权重压缩:27B模型缩至6GB,可在浏览器本地运行
Ternary Bonsai 2(27B)在Hugging Face发布,采用三值权重将模型压缩至6GB以下,仅为FP16的九分之一,官方称保留98.2%性能,并支持通过WebGPU在浏览器本地运行。
端侧AI实战:用离线模型打造无剧透读书问答App
Google开发者节目实录:如何用Firebase AI Logic混合推理,将读书问答App从云端Gemini改造为端侧离线AI。涵盖on-device模型下载、Firestore索引、Antigravity编程助手实战与真实debug踩坑经验。
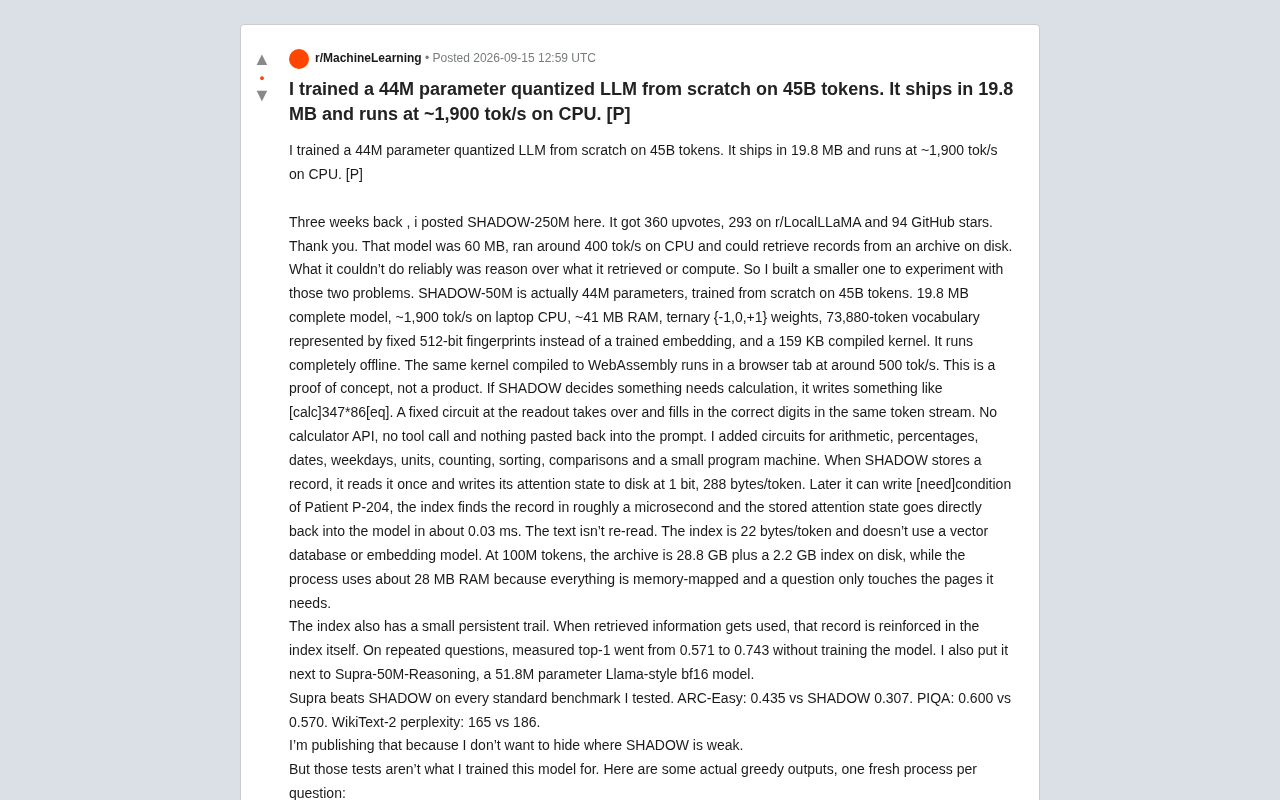
19.8MB的LLM:44M参数模型如何在CPU上跑出1900 tok/s
开发者QLNI从零训练出仅19.8MB、44M参数的量化语言模型SHADOW-50M,采用三元权重和冻结指纹词表,CPU上跑出约1900 tok/s。它把计算交给专用电路、记忆交给磁盘索引,在精确计算与可靠检索任务上超越同级模型。

逆向工程苹果神经引擎:ANE架构揭秘
苹果神经引擎ANE长期缺乏公开文档,本文解析其逆向工程思路、数据流架构特性及对端侧AI开发者的实际优化意义。
 产品体验
Google Gemma 4实测:手机离线运行+Ollama部署教程
实测Google Gemma 4开源模型在三台手机上的离线运行表现,详解Dense与MOE架构区别,附Ollama + Claude Code完整部署教程。从1B到31B四款模型覆盖手机到工作站全场景,4GB显存即可运行。