三值权重压缩:27B模型缩至6GB,可在浏览器本地运行
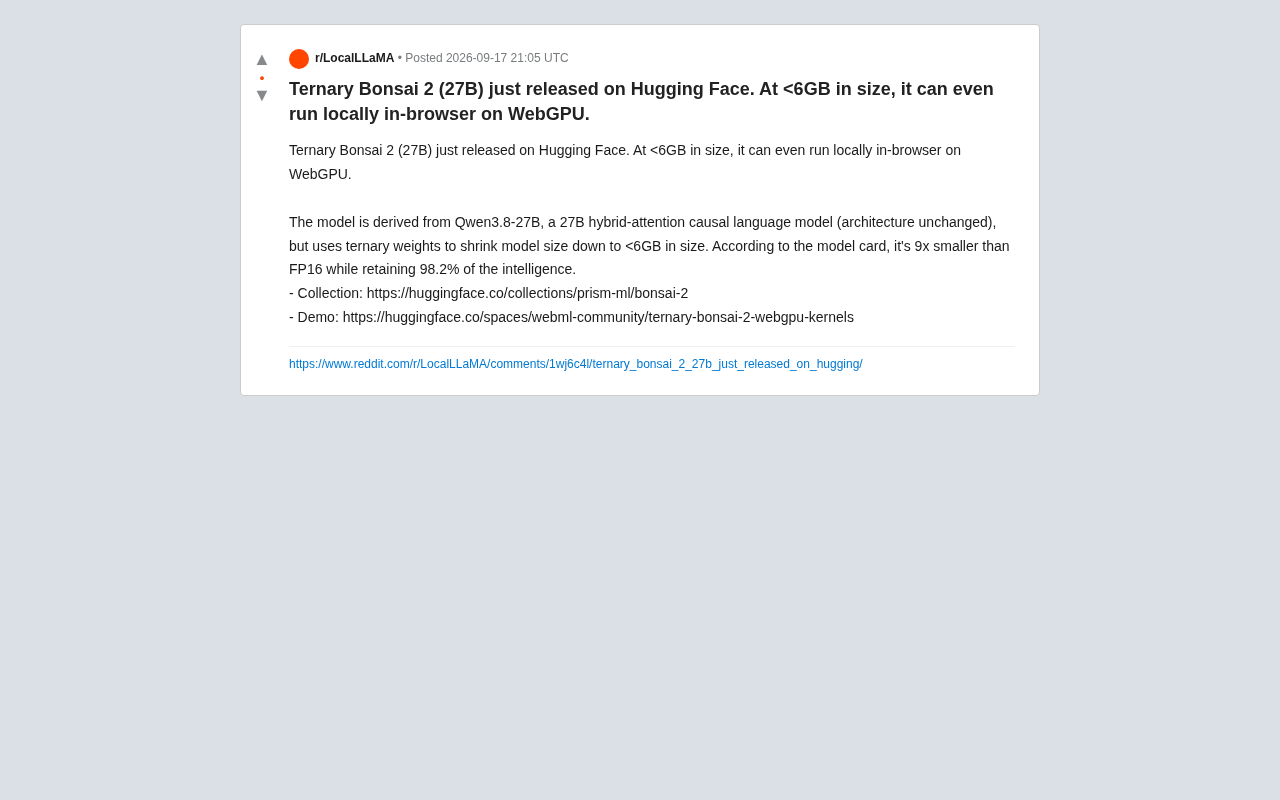
27B参数的Ternary Bonsai 2通过三值权重量化将模型压缩至6GB,可直接在浏览器内运行。
Ternary Bonsai 2是基于Qwen3.8-27B派生的270亿参数语言模型,其核心创新在于将模型权重量化为{-1, 0, +1}三个离散值,在不改变原有架构的前提下,将模型体积从FP16精度下的约54GB压缩至6GB以下,仅为原来的九分之一。发布方称该方案保留了98.2%的性能,并提供了基于WebGPU的浏览器端推理Demo,使27B级别的大模型首次可在消费级设备上无需服务器直接本地运行。这一成果契合端侧AI与隐私计算的主流趋势,但目前全部关键数据均来自发布方,尚待社区独立验证。
一个27B模型如何塞进6GB?
开源社区最近迎来一个值得关注的发布:Ternary Bonsai 2(27B)登陆 Hugging Face。它最引人注目的地方不在于参数规模,而在于体积——整个模型文件小于6GB,甚至可以借助 WebGPU 直接在浏览器里本地运行。
对于习惯了动辄几十GB显存需求的大模型部署场景,这个数字几乎有些反直觉。一个270亿参数的语言模型,通常在FP16精度下需要约54GB存储空间,而Ternary Bonsai 2把这个数字压缩到了原来的九分之一左右。
三值权重(Ternary)到底做了什么
根据模型卡片的说明,Ternary Bonsai 2 派生自 Qwen3.8-27B——一个采用混合注意力(hybrid-attention)机制的因果语言模型。关键点在于:架构本身没有改变,改变的是权重的表示方式。
所谓三值权重,指的是把模型权重量化到仅有三个取值(通常是 -1、0、+1)。相比传统的16位浮点数,这种极端量化方式大幅削减了每个权重所需的存储位数。这也是模型体积能压到6GB以下的直接原因。
这类方法并非凭空出现。三值/二值网络的思路在学术界已有多年积累,近年随着大模型部署成本高企,极低比特量化重新成为研究热点。Ternary Bonsai 2 的价值在于把这套思路应用到了一个规模可观的27B模型上,并对外公开了成果。
精度保留了多少
模型卡片给出的说法是:体积缩小到FP16的九分之一,同时保留了 98.2% 的智能表现。
如果这个数字在实际使用中站得住脚,那意味着量化带来的性能损失被控制在了非常小的范围内。极端量化最大的顾虑历来就是精度崩塌——把连续的浮点权重压成三个离散值,模型很容易丢失关键信息。98.2%这个保留率如果可靠,说明背后的量化与训练/微调流程做了相当多的补偿工作。
需要提醒的是,这一数字来自发布方自己的模型卡片,具体测评了哪些基准、如何计算“智能保留率”,仍有待独立复现和第三方验证。
三值权重量化属于"极低比特量化"(Ultra-Low Bit Quantization)的范畴。常见的大模型量化方案从FP16(16位浮点)逐步向INT8、INT4压缩,而三值量化将每个权重理论上仅需约1.58比特(log₂3)即可表示,是目前压缩率最激进的主流方向之一。与之相关的代表性工作包括微软研究院2024年提出的BitNet b1.58,该方案也采用{-1, 0, +1}三值表示,并论证了在足够大的模型规模下,三值模型在计算效率与性能之间可以达到接近全精度模型的水平。三值权重的另一个硬件优势在于:-1、0、+1的乘法运算可以退化为加法和符号翻转,理论上可以大幅降低专用硬件的功耗与计算延迟,这也是学界对这类方案长期保持兴趣的底层原因。
WebGPU 浏览器运行意味着什么
发布方同时提供了一个基于 WebGPU 的在线 Demo(webml-community/ternary-bonsai-2-webgpu-kernels),展示了模型在浏览器端本地推理的能力。
这一点的意义比单纯的“体积小”更值得展开。WebGPU 是浏览器访问底层GPU计算能力的现代标准,让模型能够脱离服务器、直接在用户设备上运行。对于一个27B级别的模型来说,能做到浏览器内推理,说明其内存占用和计算需求已经被压缩到了消费级硬件可以承受的程度。
本地运行带来几个直接好处:数据不离开用户设备,隐私性更强;无需为推理付费或依赖云端API;离线场景也能使用。这与当前“端侧AI”的整体趋势高度契合。
WebGPU 是W3C于2023年正式落地的Web标准,目前已在Chrome、Edge等主流浏览器中获得支持。它的前身WebGL主要面向图形渲染,WebGPU则提供了更接近底层的通用GPU计算接口(类似桌面端的Vulkan/Metal),使得在浏览器中运行神经网络推理成为可能。基于WebGPU的推理框架(如Apache TVM的Web后端、transformers.js等)近年发展迅速,已能支持从7B到更大参数量模型的浏览器端运行。需要注意的是,WebGPU的实际性能受到浏览器沙盒、驱动版本和GPU型号的多重限制,在消费级笔记本集显上运行27B模型时,推理速度可能远低于本地原生运行环境,实用性仍取决于具体硬件配置。
该如何看待这次发布
Ternary Bonsai 2 提供了完整的资源入口——包括 Hugging Face 上的模型合集(prism-ml/bonsai-2)以及可直接体验的 WebGPU Demo,任何人都可以自行验证。
从技术脉络看,它代表了大模型“瘦身”方向上的一次实践:不改架构、靠极低比特量化把大模型压进可本地部署的体积区间。如果社区测评能确认其性能保留率接近官方宣称,那么这类三值权重模型可能会成为端侧部署和浏览器AI应用的重要选项。
当然,目前所有关键数据都来自发布方,社区尚未形成广泛的独立验证。对于实际应用者,理性的做法是先通过Demo和公开权重亲自测试,再判断它是否适合自己的场景。无论最终评价如何,把27B模型做到6GB并能在浏览器里跑起来,本身就是一个值得关注的工程尝试。
相关推荐
NVIDIA TensorRT Model Connect:两行命令部署开源模型
NVIDIA TensorRT Model Connect 让开源模型部署仅需两条命令,无需 ONNX 转换。支持 LLM、扩散、视频生成等多类模型,兼容 RTX 消费级 GPU,并新增双 DGX Spark 多设备推理能力。
NVIDIA cuML 加速谱聚类:Scikit-Learn 提速100倍实测
NVIDIA cuML 让 Scikit-Learn 谱聚类无需重写代码即可在 GPU 上运行,大规模数据下提速超 200 倍。本文解析其原理、接入方式及在金融期权数据中的实测表现。
谷歌DeepMind成立新机构:把AGI大辩论摆上台面
Google DeepMind成立新机构,旨在把通用人工智能(AGI)的重大问题带入公共辩论。本文分析这一举措背后的行业信号,以及从技术竞赛走向公共治理的转向意义。