#计算机视觉
共 57 篇相关文章
Depth Pro 2:单目深度估计如何兼顾锐利与时序一致
Depth Pro 2 提出统一的单目深度估计网络,同时处理图像与视频,在原生分辨率下输出度量准确、边界锐利且时序一致的稠密深度图,解决单帧锐利与多帧一致的固有矛盾。
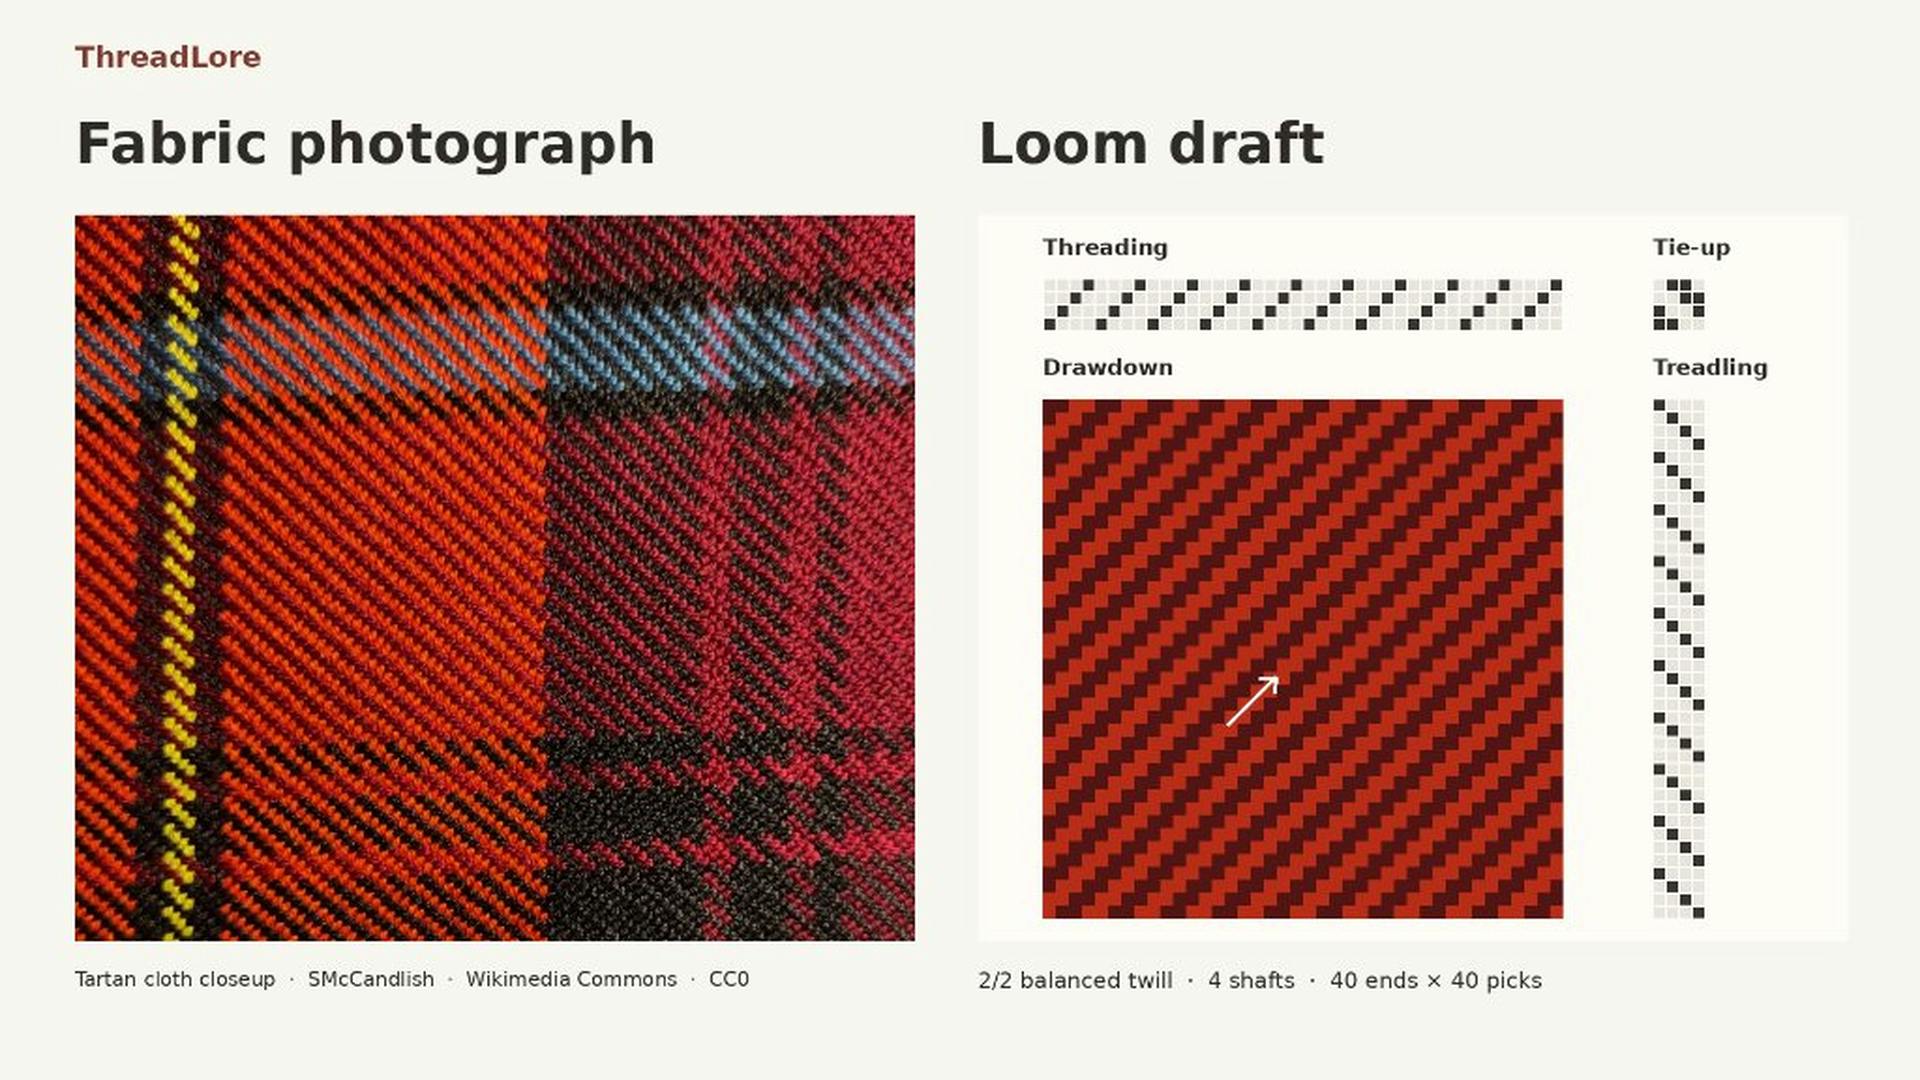
ThreadLore:用AI将织物照片还原为可编辑织机图样
ThreadLore 是一款来自 Product Hunt 的 AI 工具,能将织物照片转化为可编辑的织机图样。用户可校验 AI 建议的编织结构,并导出为织机卡片或 WIF 文件,适合手工艺人与织物研究者。
Depth Pro 2:单目深度估计实现清晰与时序一致
苹果发布Depth Pro 2,一种在全分辨率下为图像和视频估计稠密度量深度的新方法。它通过单一可扩展网络同时实现度量准确、边界锐利和时序一致的深度估计,克服了先前方法在一致性与锐度之间的权衡,并开源了代码和权重。

AI误将零食袋认作枪支:学生起诉背后的技术隐忧
AI将多力多滋零食袋误判为枪支,黑人高中生提起诉讼。本文从计算机视觉误判机制、算法公平性与安防AI落地困境三个角度,分析这起事件背后的技术隐忧与开发者启示。

船舶机舱油泄漏检测:生产级计算机视觉架构
解读Reddit分享的船舶机舱加压油泄漏检测计算机视觉架构,涵盖分层设计、合成数据策略与边缘部署考量,分析其工程价值与局限。

Reddit寻CV技术联合创始人:股权合作引热议
Reddit上一则寻找计算机视觉技术联合创始人的帖子,折射出AI创业中技术人才稀缺与股权招募信息不对称的矛盾。本文分析CV技术合伙人难招的原因,并给出联合创始人招募的关键要素。

WACV 2027 FABRIC研讨会急招审稿人,11月6日截止
WACV 2027 FABRIC Workshop因审稿时间紧张,在Reddit紧急招募应急审稿人,方向涵盖计算机视觉、多模态学习、生理传感、医疗AI与情感计算,需在11月6日中午(美国时间)前完成审稿。

餐厅CV系统实战:上座率与桌面清洁度检测架构设计
基于Reddit开发者讨论,解析餐厅计算机视觉系统的生产级架构设计:座位占用检测与桌面清洁度判断的技术选型、边缘-云混合模式、模型策略及运营功能设计,为CV落地餐饮场景提供参考。

YOLO多角度物体去重:20x22px小目标跨会话方案
针对YOLO多角度物体去重难题,解析20x22px小目标裁剪在会话隔离下的匹配策略,提出分层去重架构与成本控制方案。

Kornia:空间AI的几何计算机视觉库
Kornia是一个基于PyTorch的可微分几何计算机视觉库,为空间AI提供图像滤波、几何变换、相机标定与三维投影等算子,支持端到端深度学习训练。GitHub星标超11.5k。
Reddit热议:LLM被高估了?一张梗图引发的算法之争
Reddit一张“LLM = Overhyped”梗图引发讨论:在计算机视觉视频任务尤其是目标跟踪中,大语言模型是否被过度追捧?本文分析LLM的能力边界、专用算法的价值,以及技术选型应回归任务本身的理性态度。
镜面服装下的深度估计:人像清晰,背景为何消失?
Reddit用户测试镜面服装下的深度估计模型,发现人物分割清晰但背景几何丢失。本文分析失效根源在于镜面反射破坏背景线索,探讨边缘与背景的相互作用,并提出数据与模型改进方向。

530万参数服饰分类器Pasma:小模型逆袭还是场景限定?
Vestes Archive 开源 530 万参数服饰分类器 Pasma,综合集 Top-1 达 89.12% 超过 SigLIP-Base 零样本,但家居目录子集排名反转。本文解析其部署取舍、类别召回短板与复现性限制。

事件相机数据表示:交互式教程详解
事件相机数据表示是算法应用的关键。本文介绍事件帧、时间表面、体素网格等主流表示方法,并推荐一个包含交互式示例的教程,帮助开发者直观理解事件相机数据处理。

2026年CNN项目创意:打造作品集的实用指南
针对2026-27年作品集需求,整理四个CNN项目方向:农业病害检测、医学影像可解释性、视频动作识别和混合CV管道,并给出让项目脱颖而出的工程习惯建议。
Meta全球AI开发者黑客松组队需求:计算机视觉与医疗AI方向
Reddit开发者发帖为Meta Global AI Developer Hackathon招募队友,方向聚焦计算机视觉与医疗AI。本文分析这一组队信号背后的赛道逻辑、技能互补需求与黑客松选题策略。

从光子到生产:开源计算机视觉工程阅读路径
Reddit 用户开源计算机视觉工程阅读路径,涵盖从图像形成到生产部署的 16 个章节,强调一手来源、依赖顺序和可复现基准,帮助工程师理解模型为何失败并构建可靠视觉系统。

花朵计数模型压力测试:总数对了,结构错了
开源花朵计数项目 Bloom-Counter 的 99.7% 召回率被证明是生成器与检测器共调的结果。作者用光照与遮挡压力测试暴露真实失败模式:类别降级、碎片误报、成簇少算,并评估白平衡+CLAHE 与面积拆分的实际收益与代价。
纯经典CV实现PDF表格识别:开源项目Spartan解析
探索开源项目Spartan:仅用形态学和LSD等经典CV技术实现PDF表格检测与结构识别,无需深度学习。了解其技术原理、优势、局限及贡献方向。

Florence-2-Large入门指南:一个模型搞定多任务视觉
Florence-2-Large 是 Lucataco 部署在 Replicate 上的多任务视觉基础模型,统一支持图像描述、目标检测、视觉定位与分割提示。本文梳理其核心能力、四类适用场景、五个关键限制,与 base、Kosmos-2、InternVL 等模型的选型对比,并附 Python 上手代码。