8GB显存本地跑大模型:低配玩家的模型选择指南
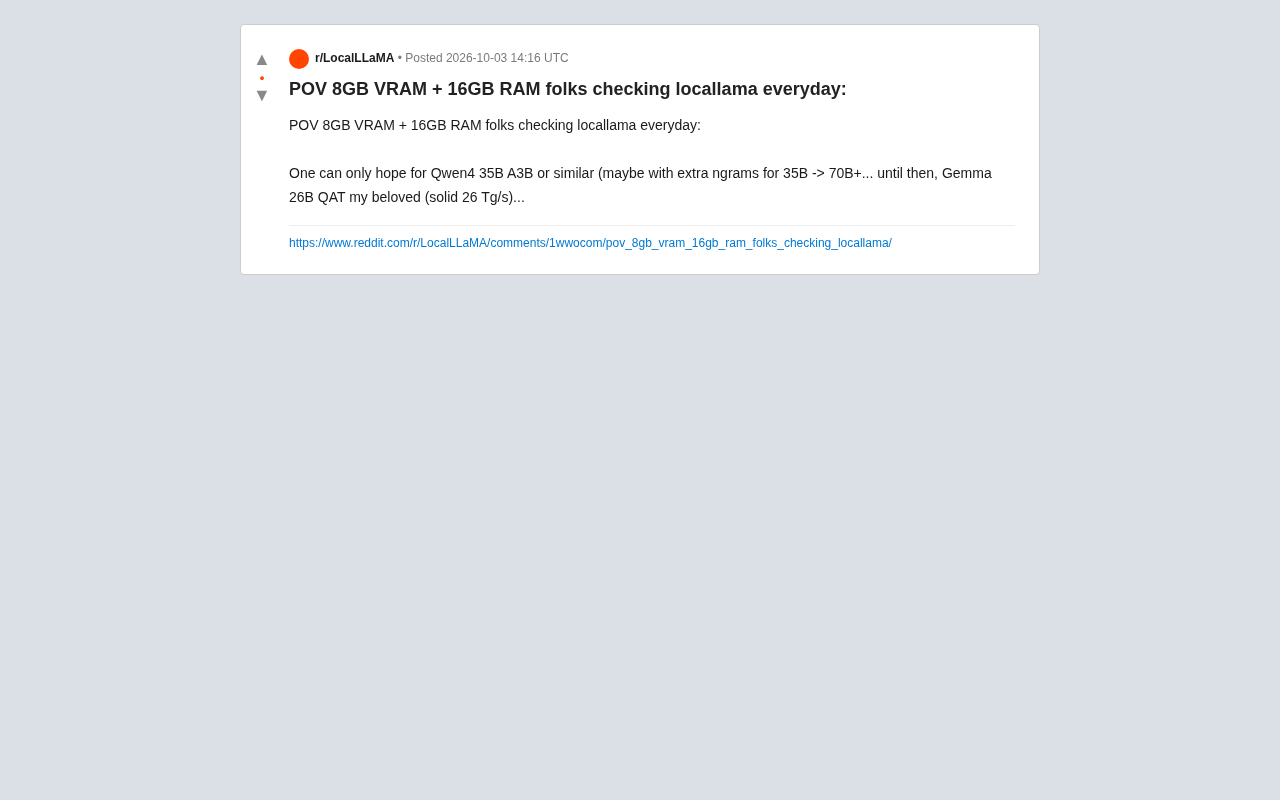
8GB显存用户借助QAT量化与MoE架构,正在突破本地大模型的硬件瓶颈。
本文以r/LocalLLaMA社区的一则帖子为切入点,描绘了拥有8GB显存+16GB内存的入门级本地AI玩家所面临的现实困境。文章解释了为何8GB显存是本地运行大语言模型的关键门槛,并说明量化技术(尤其是QAT量化感知训练)如何让低配用户在质量与速度之间找到可用的平衡点——以Gemma 26B QAT实现26 Tokens/秒为例证。文章进一步阐述了社区对MoE架构(如Qwen4 35B A3B)的高度期待:通过"大总参数、小激活参数"的设计,有望让低配硬件用户享受到接近大模型的能力。整体而言,QAT量化与MoE架构被认为是推动本地AI普惠化的两大关键技术方向。
低配硬件玩家的本地大模型困境
在r/LocalLLaMA社区,一位用户用自嘲的口吻描述了许多本地大模型爱好者的真实处境:手握8GB显存(VRAM)加16GB内存(RAM)的配置,每天刷社区,只为等待一款能在自己机器上流畅运行的高质量模型。
这条帖子虽然简短,却精准戳中了庞大的入门级本地部署群体的痛点。8GB显存是目前许多中端游戏显卡(如RTX 3060、RTX 4060)的标配,而这个配置在本地运行大语言模型时,往往处于一个尴尬的中间地带——能跑,但选择受限。
为什么8GB显存是道坎
大语言模型的运行对显存需求极高。模型参数越多,所需显存越大。一个未经量化的70亿参数(7B)模型,以FP16精度加载就需要约14GB显存,直接超出8GB的承载能力。
这也是为什么低配玩家高度依赖量化技术。通过将模型权重从16位浮点压缩到4位甚至更低,显存占用可以大幅降低。即便如此,8GB显存通常也只能较为舒适地运行7B到14B级别的量化模型,再大就需要把部分层卸载到内存(RAM),而这会显著拖慢推理速度。
帖子中提到的16GB内存正是这个用途——当显存装不下整个模型时,剩余部分依靠内存兜底,但代价是生成速度的下降。
内存卸载(CPU offloading)的速度瓶颈值得进一步说明。当模型层被卸载到系统内存时,数据需要经由PCIe总线在GPU与CPU之间反复传输。PCIe 4.0 x16的理论带宽约为32 GB/s,而GPU显存的内部带宽(如RTX 4060的288 GB/s)是其近10倍。这意味着每一次推理步骤中,只要涉及卸载层的访问,速度就会被拖慢到显存带宽的十分之一以下。实践中,将一半模型层卸载到内存后,生成速度往往从每秒十几个Token骤降至个位数,严重影响对话流畅度。因此,16GB内存更多扮演的是"能用但不好用"的兜底角色,而非真正的性能扩展方案。
Gemma QAT:当下的务实之选
原帖作者点名了自己当前的"心头好":Gemma 26B QAT,并给出了具体的性能数据——稳定的26 Tokens/秒生成速度。
这里的QAT指"量化感知训练"(Quantization-Aware Training),是一种在训练阶段就考虑量化影响的技术。相比训练后直接量化,QAT模型在压缩到低精度后仍能保持较好的输出质量,这对硬件受限的用户尤为关键。
26 Tokens/秒对于本地部署来说是相当可用的速度——大致相当于人类快速阅读的节奏,意味着交互体验不会有明显卡顿。能在8GB+16GB配置上跑出这个成绩,说明QAT量化方案确实在质量与效率之间找到了不错的平衡点。
QAT与PTQ(训练后量化,Post-Training Quantization)的区别是理解这项技术价值的关键。PTQ是在模型训练完成后直接对权重进行数值压缩,操作简单但精度损失较大,尤其在4-bit以下时模型输出质量会明显劣化。QAT则在训练过程中模拟量化带来的数值误差,让模型在迭代中主动学会"容忍"精度损失,最终导出的量化权重与原始精度模型的行为差异更小。对最终用户来说,同样是Q4量化,QAT版本在逻辑推理、代码生成等对精度敏感的任务上通常表现更稳定,代价是厂商需要投入更多训练计算资源来提供这一版本。
对Qwen4的期待:MoE架构是关键
帖子中最值得玩味的是作者对未来模型的期许:"只能寄希望于Qwen4 35B A3B或类似的模型"。
这里的"35B A3B"指向的是MoE(混合专家)架构。所谓A3B,意味着模型总参数规模虽大(35B),但每次推理实际激活的参数只有约3B。这种设计的妙处在于:模型整体能力接近大模型,但单次推理的计算和显存压力接近小模型。
对于低配玩家而言,MoE架构是极具吸引力的方向——它有可能让8GB显存用户享受到远超参数规模暗示的模型能力。作者甚至畅想通过额外的ngram技术,让35B的实际表现向70B看齐,这反映出社区对"小马拉大车"式技术突破的强烈渴望。
MoE(Mixture of Experts,混合专家)架构的基本原理是将模型的前馈网络层替换为多个并行的"专家"子网络,并由一个路由器(router)在每个token的推理中动态选择少数几个专家参与计算。以35B A3B为例,模型共有约35B参数分布在众多专家中,但每次前向传播只激活约3B参数对应的专家。这带来两个直接好处:一是显存中只需常驻激活专家的权重(可通过动态加载实现),二是浮点运算量(FLOPs)大幅降低,使得推理速度接近同等激活参数量的稠密模型。MoE并非新概念,其大规模落地可追溯到Google的Switch Transformer(2021年),但近年来Mixtral、Qwen等开源模型将其推向了消费级硬件玩家的视野。
本地部署生态的真实写照
这条看似随意的帖子,折射出本地大模型社区的几个现实:
一是入门级硬件用户群体庞大且活跃,他们并非追求极致性能,而是在有限预算内寻找最优解。
二是量化技术(尤其是QAT)已成为低配部署的核心支撑,模型厂商是否提供优质量化版本,直接决定了这款模型在社区的受欢迎程度。
三是MoE架构正被寄予厚望。随着Qwen、Mistral等团队持续推出MoE模型,"用小激活参数撬动大模型能力"的路线,很可能成为普惠本地AI的关键突破口。
对于正在考虑入门本地大模型的用户,这条帖子给出的启示很明确:8GB显存并非终点,搭配合理的量化模型和内存卸载策略,完全可以获得实用的本地AI体验。而未来MoE架构的普及,有望进一步拉低高质量模型的硬件门槛。
相关推荐
用DeepSeek一小时破解游戏坐标加密?一次AI逆向分析实录
一位B站UP主演示用国产大模型DeepSeek辅助逆向某游戏坐标加密算法。本文从AI代码分析能力、技术真实性与合规风险角度,理性解析AI辅助逆向工程的现状与边界。
0基础用Dify搭建写小说AI工作流:10分钟跑通教程
零基础教程:手把手教你用开源平台Dify搭建一个写小说的AI工作流。从GitHub安装、API Key配置模型,到Chatflow节点搭建与提示词设置,10分钟跑通你的第一个AI应用。
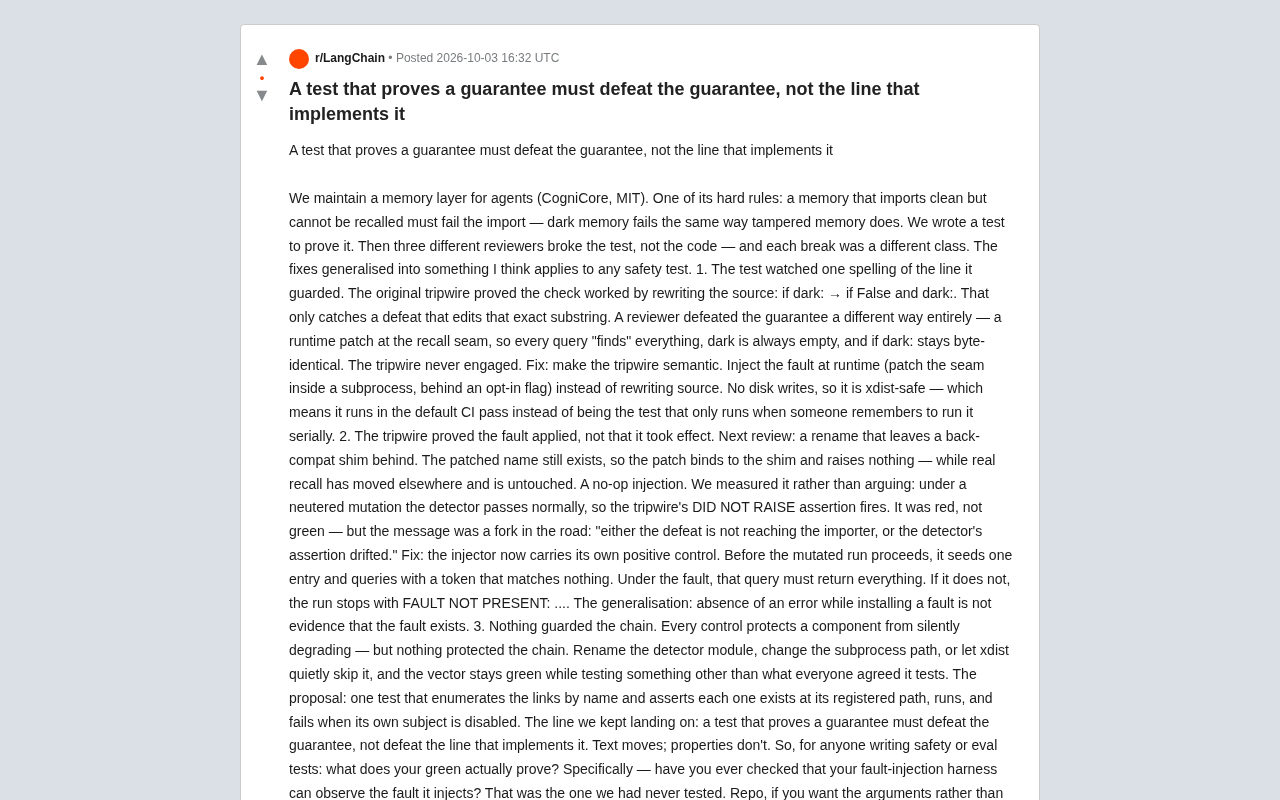
安全测试的真相:验证保证本身,而非实现它的那行代码
CogniCore 团队在为 AI Agent 记忆层编写安全测试时,被三位审查者从三个不同类别打破。本文剖析故障注入测试的盲区:测试必须击败保证本身而非实现它的代码行,并给出可泛化的工程原则。