602个视觉模型跨5款GPU实测:性能差异全解析
602个视觉模型在5款GPU上的大规模基准测试揭示架构与硬件的交互关系。
一项针对602个视觉模型在5款不同GPU上的大规模基准测试填补了视觉模型硬件性能系统性评估的空白。测试覆盖从经典CNN到最新Transformer架构的广泛模型家族,关注推理延迟、吞吐量和显存峰值等核心指标。关键发现表明,不同模型架构对硬件变化的敏感度差异显著,模型选型需考虑硬件鲁棒性;显存占用与吞吐量的权衡是部署的核心考量。开发者应将基准数据作为筛选起点,结合任务精度、硬件预算和框架生态做二次验证。由于公开信息仅披露测试规模,具体模型清单和详细指标未完整呈现,结论需审慎引用。
大规模视觉模型基准测试的意义
在计算机视觉领域,模型性能往往被简化为准确率数字,而实际部署中的推理速度、显存占用和硬件适配性却鲜有系统性评估。近期一项针对602个视觉模型在5款不同GPU上的实测研究,填补了这一空白。据Reddit社区分享的测试结果,该研究覆盖了从经典CNN到最新Transformer架构的广泛模型家族,为开发者和研究者提供了难得的横向对比数据。
这类大规模基准测试的价值在于:它不局限于单一任务或单一硬件,而是试图揭示模型架构、参数量与硬件配置之间的交互关系。对于需要选择推理硬件的工程团队而言,这种跨模型、跨GPU的视角比孤立的跑分更有参考意义。
测试方法论与覆盖范围
模型选择与任务多样性
602个视觉模型的规模在同类研究中相当罕见。虽然原始信息未披露完整模型列表,但可以推断其覆盖了图像分类、目标检测、语义分割等主流视觉任务。从Reddit讨论中可知,测试涵盖了不同参数量级的模型,从小型轻量网络到大型视觉Transformer均有涉及。这种广度使得结论能够反映视觉模型生态的整体硬件需求分布。
视觉Transformer(ViT) 是近年来计算机视觉领域的重要架构创新,其核心思想是将图像分割为固定大小的图块(patch),通过线性投影转换为序列后送入Transformer编码器。与CNN依赖局部卷积核不同,ViT通过自注意力机制建模全局依赖关系,在大规模预训练下展现出超越CNN的潜力。然而,ViT的计算复杂度和显存需求通常高于同等参数量的CNN,对硬件配置更为敏感。在实际部署中,ViT的推理性能受输入分辨率、patch大小和注意力头数等因素影响显著,这也是大规模基准测试中需要重点关注的架构类型。
五款GPU的对比维度
测试选取了5款不同GPU进行交叉评估。尽管具体型号未在现有素材中详述,但跨5款硬件的设计意味着研究能够捕捉不同显存容量、计算单元配置和架构代际之间的性能差异。多源信息显示,此类基准通常关注推理延迟、吞吐量和显存峰值三个核心指标,它们直接决定模型能否在目标硬件上落地。
推理延迟、吞吐量和显存峰值是衡量视觉模型部署性能的三个核心指标。推理延迟指单次前向传播所需时间,直接决定实时应用(如自动驾驶、视频监控)的响应能力;吞吐量指单位时间内可处理的样本数,影响批量推理场景的服务成本;显存峰值则是模型加载和运行时占用的最大显存,决定了模型能否在目标GPU上运行。三者之间存在权衡关系:增大批处理大小可提升吞吐量但会增加显存占用和延迟;降低输入分辨率可减少显存和延迟但可能损失精度。理解这些指标的相互作用是解读基准测试结果的基础。
关键发现与行业启示
模型架构对硬件敏感度的影响
大规模测试最直接的产出是揭示哪些模型对硬件变化更敏感。据测试者分享,不同视觉模型在跨GPU迁移时的性能波动差异显著——部分架构在更换硬件后吞吐量保持相对稳定,而另一些则出现明显起伏。这一发现提醒工程团队:模型选型不能只看准确率,还需评估其硬件鲁棒性。
硬件鲁棒性指模型在不同硬件配置下保持性能稳定的能力。不同架构对硬件变化的敏感度差异源于其计算模式和内存访问特征:CNN的卷积运算高度依赖专用硬件加速器(如Tensor Core),在支持该特性的GPU上表现优异,但在较旧架构上可能明显下降;Transformer的自注意力机制则对显存带宽和容量更为敏感,在显存受限的硬件上容易出现性能瓶颈。此外,算子融合、内核实现和驱动优化程度也会影响跨硬件迁移时的性能波动。工程团队在模型选型时,应将硬件鲁棒性纳入评估维度,避免在开发环境表现良好但部署环境性能骤降的情况。
显存与吞吐的权衡
视觉模型部署中,显存占用往往比计算量更早成为瓶颈。602个模型的实测数据为这一权衡提供了量化基础。从社区讨论来看,测试结果有助于识别那些在有限显存下仍能保持较高吞吐的模型,这对边缘部署和成本敏感场景尤为重要。
对开发者的实践建议
面对如此大规模的基准数据,开发者应避免陷入"唯跑分论"。综合Reddit社区的分析,合理的做法是将测试结果作为筛选起点,再结合自身任务精度要求、硬件预算和框架生态做二次验证。视觉模型的硬件表现受驱动版本、批处理大小和输入分辨率影响很大,基准数据应被视为方向性参考而非绝对结论。
局限与后续展望
说一下,现有公开信息仅披露了测试规模(602个模型、5款GPU),具体的模型清单、GPU型号和详细指标并未完整呈现。单一来源的局限性意味着读者在引用结论时需保持审慎。未来若研究团队公开完整数据集和测试脚本,其参考价值将大幅提升,也有望推动视觉模型基准测试走向标准化。
相关推荐
Replit亮相Web Summit里斯本:AI编程平台加速欧洲布局
Replit以Replit Live形式参与Web Summit里斯本2026 Day 1,本文梳理其从在线IDE向AI应用构建平台转型的路径,并分析其欧洲市场机会与合规挑战。
Codex接入Zotero:批量综述与精读工具实测
实测Codex接入Zotero的两个新功能:基于分类批量生成文献综述,以及筛选重点论文做深度精读。详解综述的对照表与引用核查、精读的方法与实验分析三层结构,附完整工作流与使用建议。
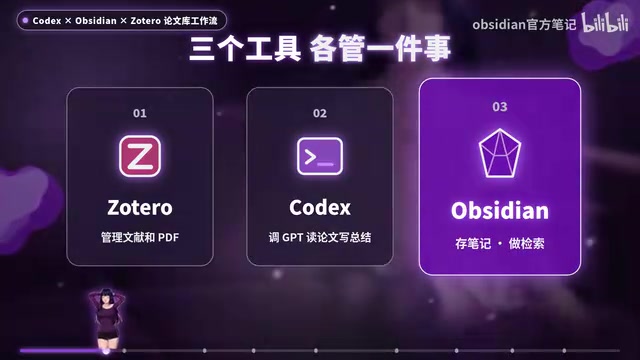
Codex+Obsidian+Zotero:AI自动精读论文工作流
分享一套Codex+Obsidian+Zotero论文管理检索工作流:Zotero管文献、Codex调用GPT自动精读并写笔记、Obsidian配合DataView建索引,实现向论文库提问、快速生成综述素材,附精读模板与两个Skill的配置步骤。