Agent开发的核心瓶颈:知识工厂比软件工厂更重要
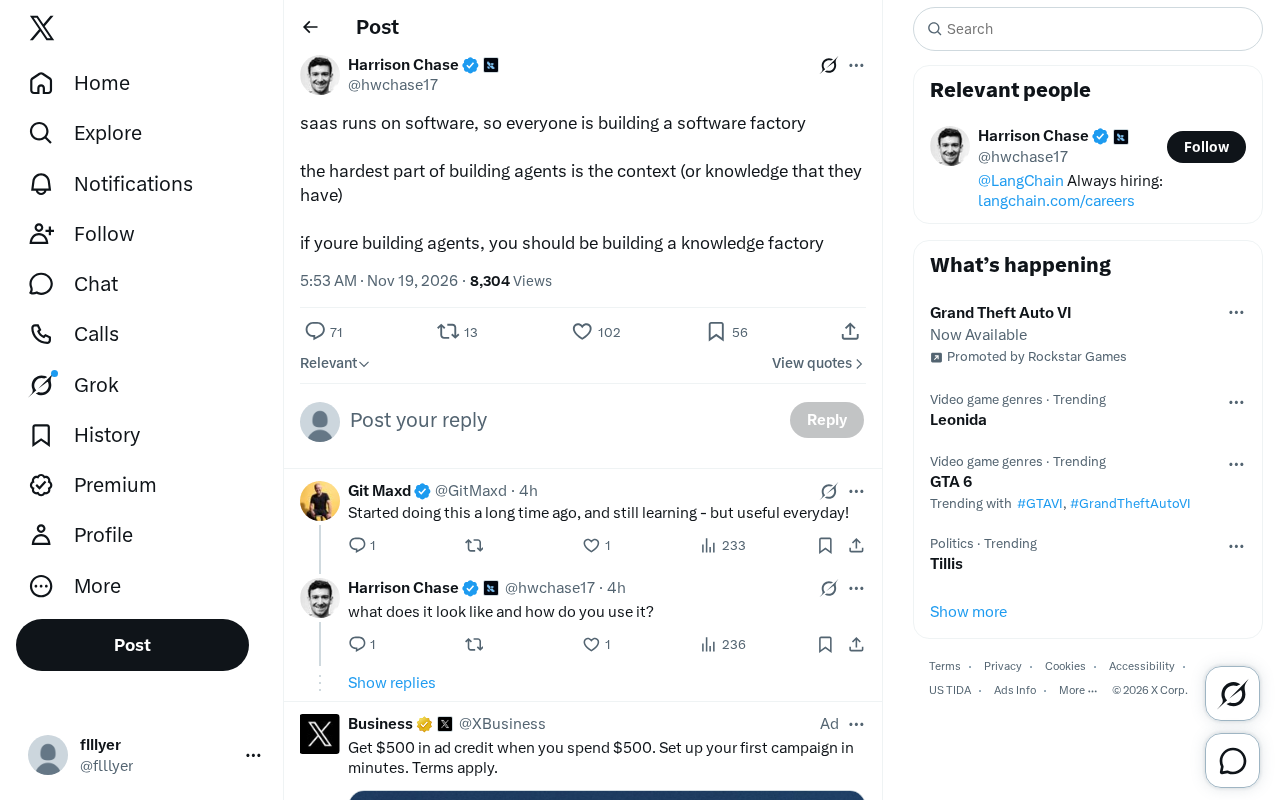
构建Agent的瓶颈在上下文而非模型,团队应建设知识工厂而非只做软件工厂。
文章指出,SaaS 行业依赖软件工厂规模化生产应用,但 AI Agent 的底层逻辑不同:其最难的部分是上下文,即 Agent 所拥有的知识。模型只是引擎,上下文才是燃料,缺乏高质量知识供给会导致幻觉和落地困难。因此团队真正需要建设的是“知识工厂”——一套持续采集、清洗、组织、更新知识的系统,需解决知识获取与结构化、动态更新、上下文选择与压缩三大问题。软件工厂提供运行载体,知识工厂提供智能内核,二者互补。文章建议将知识工程视为一等公民,并指出 Agent 的竞争壁垒将从模型调用转向知识资产的组织能力。
SaaS 行业的底层逻辑是软件驱动,因此众多团队正在构建“软件工厂”来规模化生产应用。但当目光转向 AI Agent 时,这一逻辑正在被颠覆。一条来自 Twitter 的观点指出:构建 Agent 最难的部分是上下文(context),即 Agent 所拥有的知识。 如果你正在构建 Agent,那么你真正需要建设的是一座“知识工厂”,而非单纯的软件工厂。
为什么上下文成为 Agent 的瓶颈?
传统软件的行为由代码逻辑严格定义,输入输出相对确定。而 Agent 的智能表现高度依赖其对任务背景、领域知识和实时信息的掌握程度。模型本身提供推理能力,但若缺乏精准、结构化的上下文,Agent 就容易产生幻觉或给出脱离场景的答案。
换言之,模型是引擎,上下文是燃料。没有高质量的燃料,再强的引擎也无法驱动 Agent 可靠运行。这也解释了为何许多 Agent 项目在演示阶段表现惊艳,落地时却举步维艰——差距往往不在模型,而在知识供给。
上下文窗口(context window) 指大语言模型单次推理时能够接收的 token 总量上限,涵盖用户输入、系统提示、检索到的知识片段以及历史对话等。主流模型的窗口从早期的 4K 发展到如今的 128K 乃至百万级,但相比企业知识库的总量仍然十分有限。这带来两个直接后果:一是无法将全部知识一次性塞入提示,必须做检索与筛选;二是窗口越长,模型对中间位置信息的注意力越容易衰减(即“lost in the middle”现象),导致关键知识被忽略。因此,上下文管理不是简单地把窗口撑大,而是要在有限容量内做精准取舍,这也正是知识工厂需要解决的核心工程问题。
幻觉(hallucination) 指模型生成看似合理但与事实不符或缺乏依据的内容。在 Agent 场景中,幻觉的根源往往不是模型能力不足,而是上下文缺失或错误——当模型没有可依据的权威知识时,它会倾向于用参数中记忆的模糊模式进行补全。缓解幻觉的常见手段包括检索增强生成(RAG)、要求模型引用来源、以及在上下文中明确标注知识边界。这也解释了为什么知识供给的质量直接决定 Agent 的可靠性。
知识工厂:Agent 时代的新基础设施
“知识工厂”并非简单的文档库,而是一套持续采集、清洗、组织、更新知识的系统。它需要解决几个关键问题:
1. 知识的获取与结构化
Agent 所需的知识来源多样,包括内部文档、数据库、API 返回结果、对话历史等。知识工厂的第一步是将这些非结构化或半结构化信息转化为可检索、可推理的结构。这涉及文档解析、实体抽取、关系构建等环节。
检索增强生成(RAG,Retrieval-Augmented Generation) 是当前为 Agent 注入外部知识的主流范式:先从知识库中检索与当前任务相关的片段,再将其拼入提示交给模型生成答案。RAG 的关键环节包括文档切分(chunking)、向量化嵌入(embedding)、相似度检索与重排序(reranking)。其中切分策略直接影响检索粒度——切得太碎会丢失上下文,切得太大则引入噪声并浪费窗口。除向量检索外,混合检索(结合关键词 BM25 与语义向量)和知识图谱(以实体和关系组织知识)也是结构化知识的重要形式,前者提升召回率,后者擅长处理多跳推理和关系型问题。知识工厂的“结构化”环节,本质上就是在为这些检索方式准备高质量、可寻址的知识单元。
2. 知识的动态更新
静态知识库会迅速过时。知识工厂必须具备增量更新能力,能够感知数据源的变化并同步到 Agent 的上下文中。对于时效性强的场景(如客服、运维),这一点尤为关键。
3. 上下文的选择与压缩
模型的上下文窗口有限,而知识总量往往远超窗口容量。知识工厂需要根据当前任务动态筛选最相关的知识片段,并以合适的形式注入。这不仅是检索问题,更是上下文工程(context engineering)的核心挑战。
上下文工程(context engineering) 是继提示工程之后兴起的实践领域,关注的不是“如何措辞提问”,而是“在有限的上下文窗口内放入哪些信息、以什么顺序和格式放入”。它涵盖系统提示设计、工具定义、检索结果筛选、历史对话摘要与压缩、以及多轮交互中的状态管理等。与提示工程相比,上下文工程更强调系统性的信息编排:例如将最相关的证据放在窗口首尾以对抗注意力衰减,对长对话做滚动摘要,或按任务阶段动态切换知识源。对于构建知识工厂的团队而言,上下文工程是把“知识资产”转化为“模型可用输入”的最后一公里,其质量往往比知识总量更能决定 Agent 的实际表现。
软件工厂与知识工厂的协同
这并非否定软件工厂的价值。软件工厂解决的是应用交付的效率问题,而知识工厂解决的是 Agent 的认知质量问题。两者是互补关系:软件工厂提供运行载体,知识工厂提供智能内核。
对于正在构建 Agent 的团队,一个务实的建议是:将知识工程视为一等公民。在架构设计初期就规划知识的采集管道、存储结构和更新机制,而不是等到 Agent 表现不佳时再回头补课。
对开发者的启示
这条推文虽短,却点出了一个容易被忽视的真相:Agent 的竞争壁垒不在于模型调用,而在于知识资产的组织能力。当模型能力逐渐商品化,谁能构建更高效的知识工厂,谁就能让 Agent 在真实场景中表现得更可靠、更专业。
对于 SaaS 团队而言,这或许意味着一次角色转变——从软件生产者转变为知识运营者。而那些率先建立起知识工厂的团队,将在 Agent 时代获得难以复制的优势。
相关推荐

Gemini 4 Hydrogen 对比测试:仅耗1%周配额,表现不输Sonnet
实测Gemini 4 Hydrogen与Sonnet完成同一CRUD任务:Hydrogen仅耗1%周配额,表现相当且UI细节更优,而Anthropic模型耗7%。开发者建议日常任务不必迷信高价模型。

Gemini 4 Neon发布:多项基准超越Opus 5.5,谷歌重回第一梯队
谷歌DeepMind发布Gemini 4 Neon,Artificial Analysis智能指数61分排名第三,编程指数登顶第一,多项基准超越Opus 5.5,定价每百万token输入3美元输出15美元,已在Gemini API和AI Studio开放。

Gemini 4 Neon评测:跑分直逼Carbon,API性价比解析
Google Gemini 4 Neon 全面评测:跑分直逼 Carbon,API 定价为 Hydrogen 两倍,Antigravity 额度消耗仅一倍而 Carbon 为三倍,实测可替代 90% Carbon 场景。附渠道限制、封号风险与组合策略分析。