Agent智能体全栈入门:LLM、RAG、MCP与记忆管理
从LLM到Agent,逐层拆解Function Calling、MCP、Skill、Harness与记忆管理的技术栈。
文章以B站UP主智博AI的实战课为蓝本,系统梳理了Agent智能体的全栈概念。首先指出LLM虽是"大脑",但只能单次生成、缺乏主动性与长期记忆,因此需要外层Agent系统补齐;接着区分Function Calling(调用动作)与Tool(被调用的函数),说明模型如何"动手"。记忆管理部分提出两条解法:上下文接近上限时做摘要压缩,以及借助外部存储与RAG检索形成长期记忆。MCP被类比为AI时代的USB-C接口,核心优势是工具的热插拔与统一发现;Skill则是按需加载、可复用可组合的能力单元。最后介绍CLI作为轻量执行通道,以及Harness通过提示词约束与工程约束双层机制保障Agent行为安全可控,并以一张概念地图收束全栈。
Agent智能体全栈入门:LLM、RAG、MCP与记忆管理
大模型能写诗、能答题,却没法帮你查天气、订机票——问题不在智商,在于它缺少一套"动手"的机制。B站UP主智博AI的这堂实战课,从最底层的大模型运作逻辑讲起,一路串到Agent、Function Calling、MCP、Skill、CLI与Harness,把智能体技术栈的每个零件都拆开摆了一遍。本文在复述课程内容的同时,补充一些理解上的关键点。
一、LLM:Agent的大脑,但不是全部
智博AI把大模型比作Agent的"核心大脑":它基于海量文本、通过Transformer架构训练而来,核心能力是自然语言理解与生成。但这个大脑有三个先天特征:只能根据指令生成输出,没有主动发起任务的能力;以单次交互为主,不具备长期记忆管理;知识受限于训练数据的时间,拿不到实时信息。
从输入到输出的过程,课程拆得很细:文本先被预处理、切分成Token,每个Token映射为一个ID,再映射为一组向量;这些数字化表示进入模型后,模型输出的是每个Token的概率分布,按概率采样、逐步生成。正因为本质上是"按概率采样",大模型天然带有随机性。
这一层是整个技术栈的地基。后文出现的记忆管理、工具调用、协议封装,本质上都是在给这个"只会单次作答的函数"打补丁。
Transformer架构是2017年Google在论文《Attention Is All You Need》中提出的神经网络结构,其核心是自注意力机制(Self-Attention):序列中每个Token都能直接"看到"其他所有Token并计算相关权重,从而并行建模长距离依赖,突破了RNN逐词串行处理的效率瓶颈。现代大模型几乎都基于Transformer的Decoder-only变体,通过堆叠数十层注意力与前馈网络,配合海量语料的自监督预训练获得语言能力。理解这一点有助于明白:模型输出的概率分布来自对这些注意力权重的逐层计算,而非查表或规则匹配,因此它的"知识"天然是统计性的、可能出错的。
二、Agent与LLM的边界在哪里
Agent可以理解为"大模型 + 外层Agent系统"的整体。它的工作循环是:明确任务目标 → 规划拆解 → 调用工具 → 获取反馈 → 确认目标是否达成,未达成则回到规划继续循环,直到任务完成再把结果交给用户。
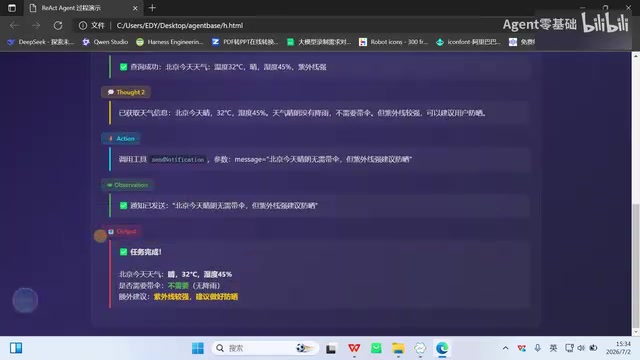
课程用了一个查天气的演示:用户要求查询北京当天天气并判断是否带伞,Agent先确认任务,思考后调用天气查询工具,拿到结果再思考,调用发送工具把信息推给用户,最后给出结论。这就是一个典型的ReAct过程。
两者的定位差异可以列成一张对照表:LLM是被使用的工具、作为大脑存在,被动响应、无状态记忆;套上Agent系统后,它变成可被委托的系统,能自主决定行动、主动执行、状态化记忆,还能使用工具并反思优化。
课程里有个很妙的边界判断:人没了手脚依然是人,但大模型如果失去调用工具和自主行动的能力,它就不再是Agent,只能退化为一个大模型。这句话点明了两者是概念层面的差别,而不是功能多少的差别。
ReAct(Reasoning + Acting)是2022年提出的Agent范式,核心思想是让模型交替产出"思考(Thought)—行动(Action)—观察(Observation)"三元组:先推理当前该做什么,再调用工具,拿到返回结果后继续推理,循环直至得出结论。它把推理轨迹与外部工具反馈交织在同一上下文里,使模型能根据真实执行结果动态修正计划,而不只是凭内部知识一次性作答。查天气案例正是这一循环的具象化。后续的Plan-and-Execute、Reflexion等模式都可视为对ReAct的变体或改进。
三、Function Calling与Tool:模型怎么"动手"
大模型只会输出概率分布和Token,而执行函数是与现实交互的动作,模型自己做不到,只能由Agent系统代劳。流程是:用户向Agent描述提供的工具;模型想调用工具时返回一段字符串;Agent系统解析字符串、转成JSON、提取函数名与参数;由Agent系统代为执行函数,再把结果返回给模型。
Tool与Function Calling的关系,课程打了比方:你打电话叫司机来接你,"打电话"这个动作是Function Calling,"司机接你并送到目的地"是Tool。Tool是人为提前写好、把接口暴露给Agent的函数。分清这两个概念,后续接MCP、写Skill时思路会顺很多。
四、记忆管理:给模型补上"不忘事"的能力
为什么需要记忆管理?两个原因。一是上下文窗口上限,输入Token数量有限(课程提到常见限制在8000到12万左右量级),超出后模型要么丢弃最早的信息,要么压缩,久而久之就"失忆"。二是模型本身对较久远的对话内容容易遗忘。
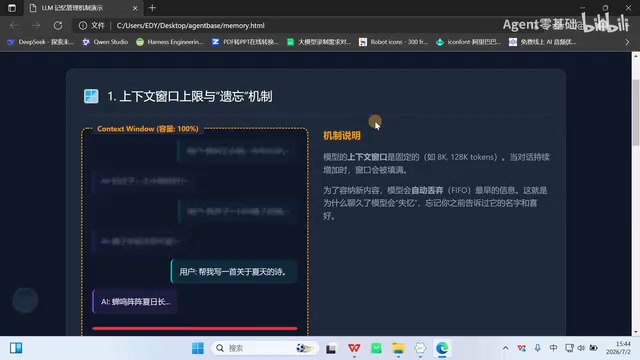
对应的解法也有两条。记忆压缩:接近窗口上限时,Agent系统把早期多轮对话送进模型生成简要摘要,用少量Token的摘要替换掉原本消耗几千Token的原始对话,腾出空间继续聊。长期记忆:把记忆写入外部存储,需要时通过RAG(检索增强生成)检索出来,注入模型上下文,形成记忆分层结构。RAG在本课只是点到为止,课程明确说后面会重点讲。
RAG(检索增强生成) 的基本链路是:先把外部文档切块(Chunking),用Embedding模型将每块编码为向量并存入向量数据库;用户提问时,将问题同样编码为向量,通过相似度检索(如余弦相似度)召回最相关的若干片段,拼入提示词作为上下文,再由模型基于这些片段生成回答。它的价值在于让模型绕开训练数据的时间边界,访问私有或实时知识,同时降低幻觉。记忆管理中的"长期记忆"正是RAG的一种应用:把历史对话向量化存储,需要时按语义相关性召回,而非全量塞回上下文。
五、MCP:AI时代的USB-C接口
MCP即模型上下文协议,由Anthropic提出,定位是让LLM与外部数据源、工具实现无约集成。它有三大原语:Prompt(预定义指令模板,向模型介绍工具用法)、Resource(提供结构化上下文数据)、Tool(集成工具,供模型按需调用)。
MCP和直接把工具塞给模型的最大区别在于"热插拔"。直接定义的工具是固定的,加新工具往往要重启整套服务;而MCP服务可以在服务端直接新增工具,Agent请求时就能拿到新的工具信息与调用方法,主机和客户端不必重启。这正是它被称为"AI的USB-C接口"的原因——标准化、可扩展。
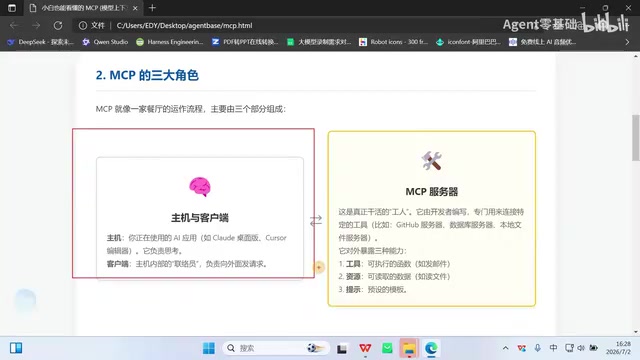
工作流程是:Agent先向MCP服务端询问提供哪些工具或资源,拿到列表;用户提问后,模型回忆工具定义并合理调用;Agent作为客户端向MCP服务发送标准请求,服务端解析并执行,结果回传;Agent把信息注入模型,模型总结后回复用户。
(原文将MCP多处写作"NCP",应属口误或转写误差,此处按MCP理解。)
MCP采用客户端-服务端架构:Host(如IDE、桌面助手)内嵌MCP Client,与一个或多个MCP Server建立连接;Server以标准化方式声明自己提供的Prompt、Resource与Tool,Client据此向模型暴露能力。传输层常用stdio(本地进程)与基于HTTP的SSE/Streamable HTTP(远程服务)两种方式,使同一协议既能接本地脚本,也能接云端服务。这种分层让工具的"提供方"与"使用方"彻底解耦——工具作者只需实现一次Server,任何支持MCP的Host都能即插即用,这也是热插拔能力的技术基础。
六、Skill:按需加载的能力单元
Skill是按需加载的指令与资源集合,把目标、流程、工具、知识与约束封装成可复用的能力单元,可以简单理解为"一段流程控制的提示词 + 相应的工具结构"。它有四大特征:按需加载(模型按任务查找并加载)、可复用(提示词与工具打包成文件夹即可分享)、可版本化(支持多版本管理)、可组合(多Skill协同完成任务)。
标准文件夹结构里,skill.md 存放提示词,reference 放参考资料,tool 放Python脚本或其他脚本,另有静态资源(图像、参考文本、视频等)。工作流程是:用户输入 → 模型识别意图 → 加载所需skill.md → 注入系统提示词(步骤、角色设定、输出格式)→ 注册Skill内工具 → 按提示词推理并调用工具 → 组合结果循环推理 → 输出。
七、CLI与Harness:执行通道与安全外壳
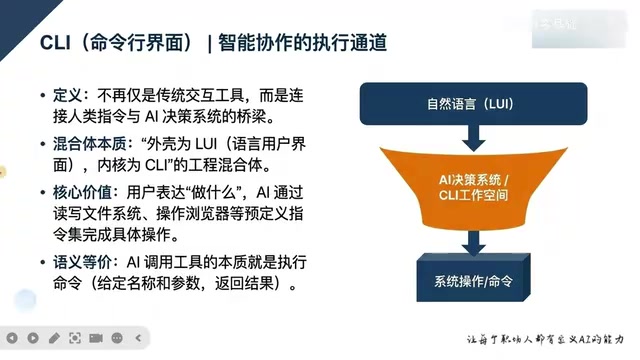
CLI命令行界面在AI时代有了新意义。大量CLI数据存在于AI训练语料中,模型天生会写CLI命令,可以通过极少的Token消耗完成文件读写、操作浏览器等预定义操作,交互路径比MCP轻得多。
Harness(驾驭工程)是给Agent套上的安全可控外壳,经典定义是 Harness Agent = Model + Harness。它通过强化提示词与外部检测机制约束模型行为。课程举例:开发一个待办事项API系统时,先写出架构分层、强制依赖规则与当前需求——这是提示词层面的约束;Harness智能体据此解析任务意图并执行;系统可指定其他Agent核查或启动应用审查,Harness智能体根据审查结果自主修复缺陷并提交。
一句话概括:Harness ≈ 提示词约束 + 工程约束。提示词约束是跟模型说好哪些能做、哪些不能做;工程约束是用代码检测并拦截越界行为,把错误结果打回模型,避免灾难性后果。
八、一张图收束全栈概念
课程结尾做了一次串联:LLM是语言理解与生成的大脑、最基础的能力层;Agent是LLM加上Agent系统(含Harness)的整体;Function Calling是模型调用外部函数的桥梁;Tool是直接为模型提供服务的工具;MCP是统一发现与调用工具的USB-C接口;Skill是高度封装、可复用的流程与应用;CLI是模型执行命令的重要交互方式;Memory负责记忆管理,弥补上下文窗口限制、帮助模型记住上下文。RAG作为检索增强生成的关键技术,留待后续课程展开。
这套概念地图的价值在于:它把"做一个Agent"从玄学拆成了可以逐个攻克的模块。真正上手时,多数人卡住的地方不是模型能力,而是工具注册、记忆分层和安全约束这些工程细节——这正是本课着墨最多的部分。
相关推荐
Google发布Gemini 4 Hydrogen:速度与代码生成成核心卖点
Google发布Gemini 4 Hydrogen模型,主打速度与代码一次作对能力;智能体可代付账单、开Google Ads账户;百度上线模型交易平台磁源锁,阿里714旗舰升级,开源270亿参数机器人模型Prince GE开放商用。
Gemini 4 Hydrogen长测:官方2.5倍速,3D打印成最大惊喜
Gemini 4 Hydrogen全套长测:定价5.5/7美元每百万tokens,官方称快2.5倍,实测3D打印STL文件质量惊艳,可无支撑打印,整套高强度测试仅消耗4%周配额。

AI时代程序员就业指南:转型路径与具身智能机会
AI时代程序员如何转型?本文基于B站职业规划直播,解析不拥抱AI的风险、Web Coding到FDE的转型路径、具身智能的数据瓶颈与大模型对研究岗位的影响,给出校招社招可操作的求职与学习顺序。