AI Agent入门指南:智能体的核心架构与工作原理详解
从定义到架构,系统拆解AI Agent的感知、规划、行动与记忆四大核心机制。
本文系统介绍了AI Agent(智能体)的完整知识框架。智能体的本质是能自主观察环境、规划任务并调用工具达成目标的系统,与传统对话AI的最大区别在于无需人类逐步介入。其架构由感知、大脑(Planning)、行动三大模块构成:感知模块依托多模态能力读取文字、图片、视频等信息;大脑模块通过思维链与反思机制完成任务规划;行动模块则通过调用计算器、搜索、代码解释器等工具将决策付诸实践。记忆管理同样不可或缺——短期记忆依赖上下文窗口、System Prompt和对话压缩,长期记忆则主要通过RAG检索增强生成和Markdown文件存储来实现。掌握这一体系,是进入AI Agent开发领域的必要基础。
AI Agent(智能体)已经成为当下最热门的技术概念之一。当越来越多的人只需一句话就能让AI自主完成复杂任务时,仍停留在与AI文字聊天阶段的用户,或许该重新认识智能体究竟意味着什么。本文基于B站教程内容,系统梳理AI Agent的定义、大模型能力演进、三大核心架构以及记忆管理机制,帮助初学者建立完整的知识框架。
AI Agent到底是什么
很多人第一次听到Agent,会本能地理解为「代理」。但在中文语境中它被译为「智能体」,核心是为了强调其独立性与自主性。
智能体的标准定义是:能够观察周遭环境并做出行动以达成目标的系统。与传统对话式AI最大的区别在于,你只需给智能体一条指令,它就能自主规划整个任务流程,无需人类逐步介入。更关键的是,当它发现自己缺乏完成任务所需的知识时,还能主动调用工具或联网搜索来补足能力。
近期爆火的产品(如教程中提到的图标类AI应用)本质上都是这一概念的落地形态——一个宣称「能做任何事」的AI,背后正是智能体架构在支撑。
大模型进化:从文本工具到超级大脑
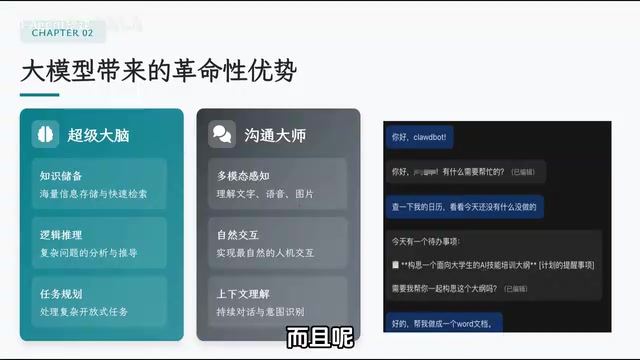
智能体成立的首要前提,是底层大模型足够智能。教程将当下的大模型称为「超级大脑」,其能力提升体现在几个维度。
知识储备与响应速度大幅提升。早期的AI主要用于文本创作与代码编写,面对复杂数学问题常常出错。如今的大模型已经能够自动拆解任务,将其分成简单步骤逐步完成,即便是数学计算也能给出可靠答案。
多模态感知是另一个决定性突破。传统AI对话只能收发文字,难以满足真实需求。多模态模型让用户可以通过文字、语音、视频等多种方式提供信息,AI也能反向生成图片、语音甚至视频。
这种能力带来了更自然的交互体验。遇到难以描述的问题时,用户可以直接截图发给AI,无需再费力用文字描述——AI能够「看懂」图片并直接给出答案。这种交互方式,正在让AI从工具变为可对话的协作者。
智能体的三大核心架构
从「聪明的大模型」到「可用的智能体」,还需要完整的架构支撑。教程将其拆解为三个核心模块。
感知模块
智能体要独立完成任务,必须能感知外界环境。这一职能主要由多模态能力承担,让智能体能够读取文字、语音、视频乃至电脑桌面的实时状态。
大脑模块
接收信息后,智能体需要进行思考、决策与规划,对应架构图中的Planning部分。这里包含几个关键机制:**Reflection(反思)**让它能进行自我批判;**思维链(Chain of Thought)**则相当于「深度思考」按钮背后的逻辑——把任务分解成一步步的执行序列,明确先做什么、再做什么。
思维链(Chain of Thought,CoT)由Google研究人员于2022年正式提出,其核心发现是:当提示词中包含分步推理示例时,大模型在复杂推理任务上的准确率会显著提升。直觉上可以理解为,模型在生成每一个词时都只能"向前看",如果强迫它把中间步骤写出来,相当于把工作记忆外化到上下文中,从而让后续推理有据可依。现在各家模型产品里的"深度思考"或"extended thinking"模式,本质上都是让模型在给出最终答案前先输出一段内部推理过程,正是CoT的工程化落地。Reflection(反思)机制则更进一步:智能体在完成一轮行动后,会将执行结果与预期目标进行比对,如果发现偏差,则重新规划下一步行动,形成"计划—执行—反思—再计划"的循环,这也是智能体能够在无人监督下持续改进输出质量的关键所在。
行动模块
仅在对话框里思考无法真正完成任务,行动模块通过调用工具让智能体「动起来」。教程列举了几类典型工具:遇到复杂计算时调用calculator计算器;需要补充知识时使用search联网搜索;编写代码需要验证正确性时使用code interpreter代码解释器。
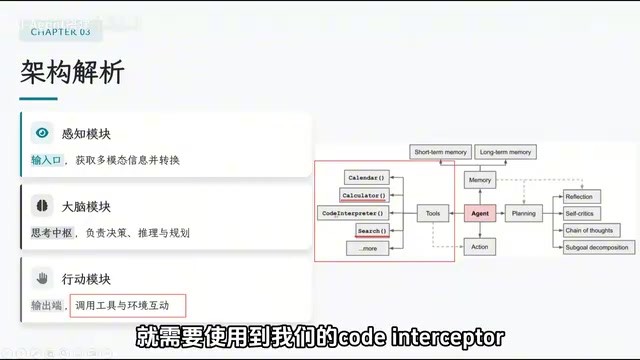
以「点一杯咖啡」为例:智能体会先思考用户的偏好(喜欢的咖啡种类),选定后再调用支付接口工具完成下单。这一整套「感知—思考—行动」的闭环,让AI初步具备了自主智能体的形态。
记忆机制:AI如何「记住」你
除三大模块外,还有一个容易被忽视的关键——记忆模块。
先破除一个误区:并不存在一个专属AI一直为你服务。事实上,每一次对话,AI都是以全新的、陌生的身份来响应的,它本身看不到之前的对话。之所以感觉AI一直「记得」你,靠的是对话管理机制。
短期记忆:上下文窗口
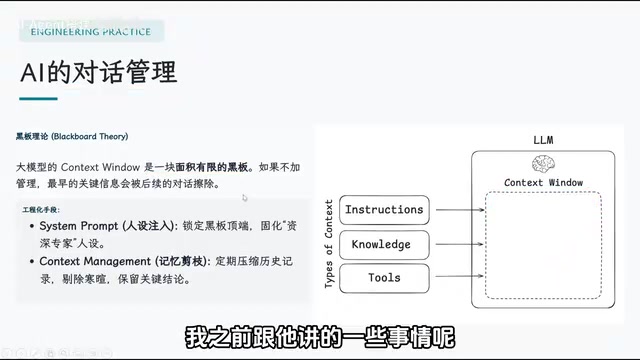
所有对话都保存在**上下文窗口(context window)**中,模型公司还会在其中写入隐藏指令(例如「你是某公司的AI,核心任务是解答用户问题」)。可以把它想象成一块面积有限的黑板。
当对话达到几万甚至几十万字,窗口写满时,AI就会遗忘早期内容。工程上有两种应对手段:
- System Prompt(人设注入):将核心任务写成一句话,锁定在窗口顶端,不随对话流程被删除,确保AI始终记得自己的角色定位。
- 记忆简知(对话压缩):当轮数过多、窗口将满时,把全部对话交给另一个AI进行总结,剔除寒暄等无用信息,只保留用户姓名、偏好等关键信息,从而腾出空间继续对话。
长期记忆:RAG与文件存储
短期记忆终究有限,长期记忆需要另辟蹊径。**RAG(检索增强生成)**是当前管理长期记忆的主流手段,同时也能解决AI知识来源不足的问题。
其原理并不复杂:把用户的历史记录、购物记录、对话内容以及企业私有知识都存入知识库。当用户提问时,将问题转化为向量,到向量知识库中检索相关片段,再把检索到的资料与用户问题拼接在一起交给大模型回答。这样每一次回答都能有据可依。
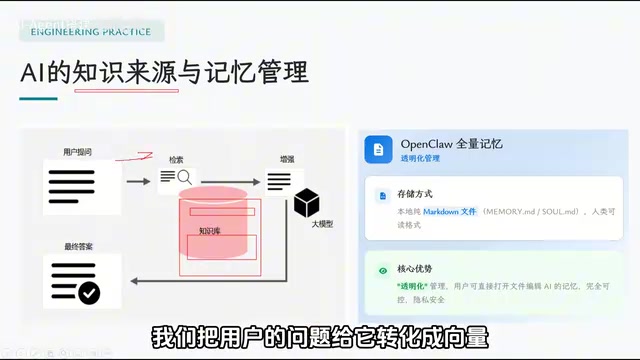
此外,教程还提到另一种更直观的记忆方案——以Markdown文件形式存储记忆。它与普通文本记录无异,好处是人类可以直接读取AI记住了什么,也能手动修改。当涉及隐私需求时,直接编辑对应片段即可,透明度和可控性都更高。
RAG(Retrieval-Augmented Generation,检索增强生成)由Meta AI于2020年提出,最初是为了解决大模型"知识截止日期"和"幻觉"两大痛点。其技术流程可以拆分为两个阶段:离线索引阶段将文档切分为若干文本块(chunk),通过嵌入模型(Embedding Model)将每个文本块转化为高维向量并存入向量数据库;在线检索阶段则将用户问题同样向量化,通过余弦相似度等指标找出最相关的若干文本块,将其作为上下文拼接到提示词中,再交由大模型生成答案。向量相似度搜索之所以有效,是因为语义相近的文本在高维空间中距离更近,从而实现"语义检索"而非简单的关键词匹配。RAG相较于对模型直接微调的优势在于:知识库可以实时更新,无需重新训练模型,成本极低,且可追溯来源,便于核查答案依据。
智能体的核心特征与学习方向
综合来看,一个成熟的AI Agent具备四项核心特征:
- 独立自主性:无需他人逐步指导即可行动;
- 目标导向性:所有动作最终指向任务完成;
- 环境感知能力:能读取传感器、语音、视频乃至桌面环境并做出反应;
- 工具使用能力:可调用代码工具、联网搜索等扩展自身能力。
随着AI Agent快速发展,它正开始为人类提供高质量的内容与服务。对于希望进入这一领域的人来说,掌握RAG技术以及对AI工作原理的深入理解,将成为未来企业极为看重的技能。在此基础上,进一步学习MCP等相关技术,才能真正搭建出属于自己的AI工作流。
MCP(Model Context Protocol)是Anthropic于2024年底发布的开放协议,旨在标准化大模型与外部工具、数据源之间的连接方式。在MCP出现之前,每个AI应用都需要为每种工具单独编写集成代码,维护成本极高。MCP的设计类似于USB接口的思路:只要工具服务商实现了MCP Server,任何支持MCP的AI客户端都能即插即用地调用该工具,而无需关心底层实现细节。对于希望搭建AI工作流的开发者而言,理解MCP意味着可以快速组合搜索、数据库查询、代码执行、文件读写等能力模块,将精力集中在业务逻辑而非底层接口适配上。目前主流的AI编辑器和智能体框架已陆续宣布支持MCP,它正在成为智能体工具调用层的事实标准之一。
相关推荐
MiniMax H3实测:3步采样打造整首歌口型同步MV
一位创作者用MiniMax H3 Extender制作整首歌口型同步MV的完整实测:音频切片、htdemucs人声隔离、fully_copy保留语法、3步turbo LoRA提速,附三款LoRA对比与自动化质检方案。
Parsec开源工具:用小模型给AI Agent瘦身上下文
开发者开源工具Parsec通过训练小语言模型(SLM)为长时运行的AI Agent削减上下文膨胀,缓解Claude Code等编码助手的token超限问题。本文解析其分层架构思路与实际应用价值。
NepKANUN:基于RAG的尼泊尔法律智能助手解析
NepKANUN是一款基于RAG框架和微调大语言模型的尼泊尔法律AI助手,通过定制化问答数据集实现精准法律咨询,BERTScore最高达0.82,为小语种垂直领域AI落地提供参考。