AI Agent实战入门:从RAG到智能体的技术进阶路线图
从提示词到Agent:梳理大模型应用工程师的完整能力结构与行业落地路径。
本文基于一位技术分享者的直播内容,系统梳理了大模型应用开发的能力要求与行业落地脉络。工程师能力结构上,需具备Python/PyTorch基础,以及小模型工程化、大模型微调(以LoRA为代表)、Agent开发和底层认知四大模块。行业落地经历了原生大模型、提示工程、RAG、Agent四个阶段,每阶段都在弥补前一阶段的缺陷,Agent通过翻译官、工具达人、记忆管家、任务管家四项能力,将大模型从问答工具升级为能处理复杂任务的"数字员工"。市面主流Agent分为公司类、角色类、工具类和行业类,其中行业类落地价值最高,也是就业转型的重点方向。文末提示内容源自课程推广直播,框架具参考价值,但数据需独立核实。
大模型应用开发的行业分水岭正变得越来越明显:一边是只会写提示词的初学者,另一边是能把模型真正落地到业务系统的工程师。这篇文章基于一位有多年行业经验的技术分享者(自称"大宇老师")的直播内容整理,梳理出从基础能力到Agent开发的完整技术脉络,帮你理清转型大模型应用开发的方向。
大模型应用工程师需要什么能力结构
想进入工业界做大模型落地,能力结构必须清晰。基础部分有三项硬指标:Python要足够熟练;PyTorch要能手写关键模块;神经网络、深度学习和Transformer的底层机制要理解透彻,不能停留在调库层面。Forward怎么实现、Tensor怎么计算,这些必须能讲明白,否则面试时两个问题就会露馅。
基础之上,企业级能力被拆成四大块。第一块是小模型工程化能力——像BERT、T5这类经典模型,重点不是会用,而是能否嵌入业务流、封装成API、部署为稳定服务。比如把一个文本分类模型封装成HTTP接口并支撑一定QPS,这才算真正的工程能力。
第二块是大模型微调能力。企业要的不是只会调用通用大模型的人,而是能在垂直数据集上做适配的人。LoRA这类参数高效微调方案必须掌握,微调完还要会量化压缩、推理优化后再上线。第三块是Agent开发能力,基于LangChain、LangGraph的流程编排是刚需。第四块是底层认知,强化学习原理、模型并行、推理加速机制(vLLM、Flash Attention等关键词面试一定会问)。前三块最核心,第四块是加分项。
LoRA(Low-Rank Adaptation)是目前工业界最主流的大模型参数高效微调方案,理解其原理对于评估微调成本至关重要。全量微调一个70亿参数的模型需要数百GB显存,对大多数企业不现实。LoRA的核心思路是:冻结原始模型的全部参数,在需要更新的权重矩阵旁注入两个低秩矩阵A和B(秩r通常取4~64),只训练这两个小矩阵,训练完成后将其与原始权重合并,对推理性能几乎没有影响。这样可以将可训练参数量降低至原来的0.1%~1%,显存占用大幅缩减。结合量化技术(如QLoRA,使用4bit量化基础模型)后,消费级显卡也能完成十亿参数级模型的微调,这是当前垂直行业模型适配的主流技术路径。
大模型商业落地的四个阶段
要理解Agent的价值,得先看清大模型商业落地一步步走到今天的四个阶段。
第一阶段是原生大模型。 技术本质是基于海量互联网公开数据训练,通过学到的知识进行内容生成。ChatGPT爆发时让很多人惊叹它能写文案、写代码,但很快暴露出致命短板:没有自主思考能力,只能回答训练数据里的知识,问它训练截止后的内容就会一本正经地产生幻觉,也无法对接企业业务系统。
第二阶段是提示工程。 通过优化提示词提升输出质量,思维链、思维树等技巧一度被疯狂学习。但提示工程有三大核心缺陷:无法访问企业私有数据、无法处理复杂业务问题、输出结果严重依赖人工调优。在2026年,提示工程已经成为大模型应用工程师最基本的技能——就像用电脑之前必须会打字,但会打字不等于是IT工程师。
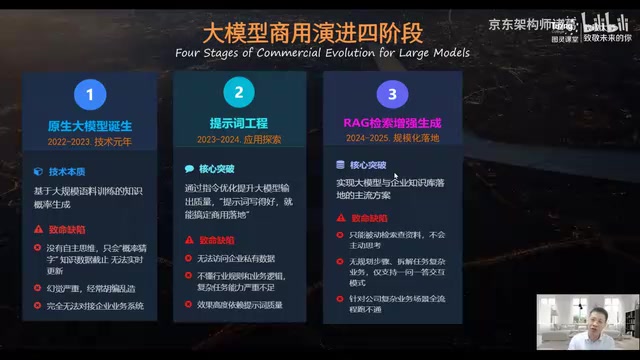
第三阶段是RAG(检索增强生成)。 这是当前很多传统企业数字化转型的首选方式。把公司的表格、文档、图片、音频等数据处理后存入知识库,大模型在回答前先检索知识库。很多企业的智能客服、知识库问答都是通过RAG实现的。但RAG的天生缺陷也很明显:只能被动检索查资料,不会主动思考,无法处理复杂业务,且只支持一问一答。
第四阶段是智能体(Agent)全面爆发。 大模型具备了自主规划和执行思考的能力,从一个"问答工具"升级为能调用多种工具完成复杂任务的"数字员工"。这也是当前企业做大模型转型改造的主流方案之一。
RAG(Retrieval-Augmented Generation,检索增强生成)的工作原理值得展开说明。其核心流程分为两个阶段:离线阶段将企业文档切片、向量化后存入向量数据库(如Faiss、Milvus、Chroma);在线阶段则在用户提问时,先将问题同样向量化,通过余弦相似度等算法从数据库中检索最相关的文本片段,再将这些片段作为上下文拼入提示词,引导大模型基于这些"参考材料"生成回答。这一机制有效解决了大模型的知识截止问题和私域数据无法访问的问题,同时也因为有原文支撑而在一定程度上降低了幻觉风险。RAG的短板在于检索质量直接决定输出质量——若问题与文档的语义匹配不准,或问题需要跨多段文档进行推理,RAG便会失效,这也是Agent相比RAG能处理更复杂任务的根本原因。
Agent到底解决了什么问题
Agent可以理解为"大模型时代的代理"——就像一个中国人和一个美国人沟通时中间的翻译。用户提问,Agent理解需求,调用各种工具做复杂处理后返回结果。
原生大模型有几个硬伤:没有记忆(每次对话都是重新开始)、有知识截止时间、无法联网、无法操作工具和电脑。Agent针对性地解决了四个问题:
- 翻译官:把人的自然语言需求翻译成模型能懂的指令,再把输出转成人能理解的结果;
- 工具达人:帮大模型调用API、联网搜索、操作文件、对接系统,让模型从"会说话"变成"能动手";
- 记忆管家:记住上下文和历史对话,实现连贯的多轮交互;
- 任务管家:把复杂问题分解成多个步骤,规划执行流程,遇到问题还能调整方案。
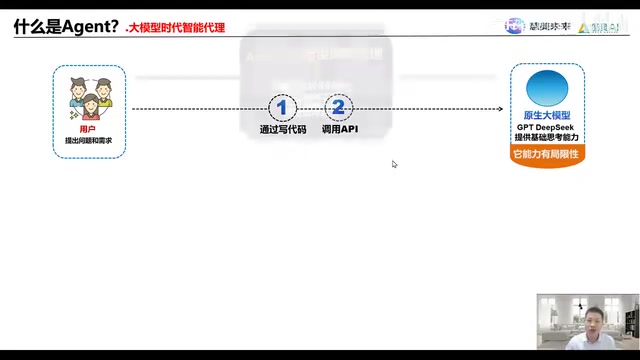
我们日常用的豆包、DeepSeek,以及程序员常用的Claude Code、Cursor这类编程工具,本质上都是Agent。以Claude Code为例,它能理解整个项目结构、调用编译器调试代码,这些正是Agent中"工具达人"和"记忆管家"能力的体现。
LangChain和LangGraph是目前构建Agent应用最常用的两个开源框架,二者定位有所差异。LangChain提供了链式调用的抽象层,将提示模板、模型调用、工具调用、记忆模块等封装成标准组件,适合构建相对线性的流程。LangGraph则在LangChain基础上引入了图结构编排,允许定义节点(处理单元)和边(跳转条件),支持循环、分支和多智能体协作,更适合需要"思考-行动-观察-再思考"反馈循环的复杂Agent场景。Agent的核心执行范式通常称为ReAct(Reasoning + Acting):模型先推理当前状态,选择并调用一个工具,观察工具返回结果后再次推理,如此循环直到任务完成或达到最大迭代次数。理解这一循环机制,是从"会用LangChain"到"能设计复杂Agent流程"的关键跨越。
市面上主流Agent的四大分类
能真正落地并产生商业价值的Agent,基本逃不开四大分类,想从事Agent开发、大模型测试运维或AI产品经理的人都能从中找到定位。
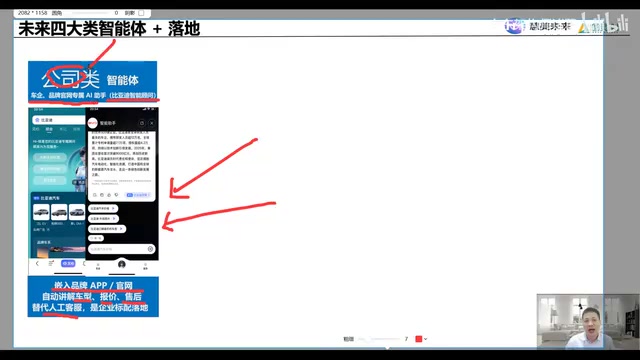
公司类Agent:品牌官网的专属智能体,比如比亚迪的智能顾问,嵌入APP和官网,24小时替代人工讲解车型和配置。稍有规模的传统企业都在做或准备做。
角色类Agent:即数字人,比如AI虚拟主播、带货主播。技术上是AI Agent能力加上数字人形象的组合,短视频和电商公司已在大批量使用。
工具类Agent:解决单一功能痛点,把一件事做深做透,比如AI写作、简历生成工具。这类相对容易上手,适合结合某个行业痛点做成付费或流量产品。
行业类Agent:面向B端传统企业数字化转型,深入业务全流程。比如电商场景中从用户咨询、查库存到自动完成订单,还有工业Agent、法律Agent等。这类开发周期长、成本高,但被认为最有价值,也是就业转型应重点关注的方向。
从技术趋势看学习方向
分享者将大模型的发展节奏描述为:"大模型之年"拼的是算力和模型聪明程度,但那只是原子能力;Agent则经历了从概念走向小规模落地的"先行者阶段",再到"百亿级智能体"的规模化应用阶段。据其展示的行业采访片段,AI Agent相关业务的增速可达一倍以上,企业端对智能体的需求正从"锦上添花"走向"刚需驱动",越来越多客户要求基于自身业务定制专属Agent。
需要提醒的是,这份内容源自一场带有课程推广性质的直播,其中夹杂了大量营销话术和引导互动的表述。文中关于能力结构、落地四阶段、Agent四大分类的框架有一定参考价值,但涉及具体政策数据、普及率数字等说法未经独立核实,读者应保持批判性判断,把它当作梳理学习路线的参考而非权威结论。
相关推荐
LynnReal-Omni:32B统一视频扩散模型开源,四步生成多任务全覆盖
LynnReal-Omni 是基于 MiniMax H3 架构的 32B 统一视频扩散模型,支持文生视频、图生视频、姿态引导、视频修复等多任务,四步快速生成,Flash 版单张 H100 上 377ms 完成 540p 视频,权重与 ComfyUI 节点已开源。

Anthropic联合创始人:AI"紧急停止开关"或应强制立法
Anthropic联合创始人向BBC表示,AI系统的"紧急停止开关"(kill switch)可能需要通过法律强制推行。本文分析这一呼吁背后的产业逻辑、技术挑战以及监管与创新之间的张力。

AI数据中心建设热潮,正冲击工业创伤深重的城市
AI数据中心建设热潮正与曾受重工业创伤的城市社区激烈碰撞。以费城为例,全国性反对声浪聚焦能耗、水资源与环境公平问题,揭示AI增长与地方利益的结构性冲突。