AI给房屋打"破败分"引众怒:算法治理的边界在哪

AI为房屋打"破败分"引发争议,折射算法治理中透明度、偏见与问责缺失的深层困境。
某市政部门引入AI系统为辖区房屋自动评定"破败分数",以识别需整治物业,遭到市议员和居民强烈反对。争议核心在于三点:评分标准不透明使居民无从申诉;训练数据可能携带对低收入或少数族裔社区的系统性偏见,算法会放大而非消除歧视;误判造成的罚款或强制整改代价,往往由最缺乏话语权的居民承担。文章指出,将治理决策外包给算法,实质上是一种责任"漂白"——技术中立的表象掩盖了人为价值判断。作者认为,要让自动化治理真正服务公共利益,必须建立知情权与解释权、人工复核环节、独立审计和明确问责主体四条底线,技术可以提升效率,但不能取代对公民权利的尊重。
当算法开始给你的家打分
一则来自Hacker News的讨论引发关注:某地市政部门采用AI系统为辖区内房屋评定"破败分数"(blight scores),用于识别需要整治或处罚的物业。这一做法遭到当地市议员和居民的强烈反对,质疑声集中在算法的公平性、透明度以及对居民权益的潜在侵害上。
所谓"blight",在美国城市治理语境中通常指房屋失修、荒废或影响社区环境的状态。地方政府长期面临如何高效识别问题物业的挑战,而AI图像识别与数据分析被视为一种"降本增效"的工具——通过卫星影像、街景照片或公开数据自动为每栋房屋生成评分。然而,当这套逻辑落到具体的家庭头上时,争议随之而来。
注:受原始素材信息量所限(Hacker News 仅有标题及少量讨论),本文侧重于对这一现象背后治理逻辑的分析,具体案例细节请以原始报道为准。
争议的核心:算法能否替人做判断
居民和市议员的反弹并非无的放矢。用AI给房屋打分,本质上是把一个涉及个人财产、居住尊严的复杂判断,交给了一套不透明的评分模型。这里至少存在三层问题。
评分标准是否公开
一个房屋被判定为"破败",依据的是屋顶破损、油漆剥落,还是院落杂草?这些特征的权重如何设定?如果评分模型是黑箱,居民就无从知晓自己为何被标记,也难以有针对性地申诉或整改。透明度的缺失,是公众信任崩塌的第一道裂缝。
训练数据是否存在偏见
AI评分系统高度依赖训练数据。如果历史数据本身带有对特定社区、特定族裔或低收入区域的系统性偏见,算法会"忠实"地放大这种偏见,导致某些社区被过度标记。这类算法歧视在信贷、司法等领域已有大量前车之鉴,房屋评估同样无法幸免。
算法歧视(algorithmic bias)在公共政策领域已有系统性记录。最典型的案例是美国广泛使用的COMPAS累犯风险评估系统——调查机构ProPublica于2016年发现,该系统对黑人被告的高风险误判率是白人被告的近两倍。类似的偏见模式在自动化住房领域同样存在:美国住房与城市发展部的研究显示,历史上遭受"红线政策"(redlining,即系统性拒绝向少数族裔聚居区提供金融服务)的社区,其公开数据中已沉淀了数十年的系统性不平等。当AI模型以这些历史数据为训练基础时,过去的歧视性判断会以"客观分数"的形式得到再生产和固化,形成研究者所称的"反馈循环"——被过度标记的社区因整治行动而产生更多负面记录,进而使下一轮算法更倾向于标记同类社区。
误判的代价由谁承担
一张过时的卫星照片、一次光线不佳的街景拍摄,都可能让正常房屋被误评为破败。而这种误判的后果——罚款、强制整改甚至征收——却实实在在地落在居民身上。当算法出错,纠错的成本和举证责任往往被转嫁给了最没有话语权的一方。
效率与公平的老命题
市政部门引入AI打分,出发点可以理解:人力巡查成本高、覆盖慢、主观性强,算法看似提供了一个"客观"且规模化的解决方案。但"客观"是个危险的错觉。算法的每一个参数、每一份训练数据,背后都是人的选择,都嵌入了价值判断。
把治理决策外包给算法,容易造成一种责任的"漂白"——当官员说"这是系统评估的结果"时,人为决策的责任被隐藏在技术中立的表象之下。市议员的介入恰恰点破了这一点:涉及公民财产权的行政决定,不能简单地让一个评分数字来拍板。
这种将行政责任转移给技术系统的现象,学界称之为"自动化偏见"(automation bias)——决策者倾向于过度信任算法输出,即便面对相反的人工判断也不轻易推翻。其背后有制度性动机:若决策出错,官员可将责任归咎于"系统"而非个人;若决策正确,则可宣称提升了效率。法学学者Frank Pasquale将这类不透明的算法系统称为"黑箱社会"(The Black Box Society),指出当关键决定由不可解释的模型作出时,公民的申诉权利在实践中会遭到实质性架空——你无法反驳一个你看不见内部逻辑的评分。这也正是为何欧盟《通用数据保护条例》(GDPR)第22条专门规定了公民反对纯自动化决策的权利,并要求提供"有意义的解释"。
算法治理需要的护栏
这起事件不是孤例,而是AI进入公共治理领域的一个缩影。从福利资格审核到警务预测,政府部门越来越多地部署自动化决策系统,而配套的监督机制却常常滞后。要让技术真正服务于公共利益,几条底线值得坚持。
知情权与解释权:任何被算法评分影响的公民,都有权知道评分依据,并获得可理解的解释。
人工复核环节:算法输出应作为参考而非最终裁决,尤其在涉及处罚时,必须保留人工审查和申诉通道。
独立审计:评分模型应接受第三方对准确性和偏见的独立评估,结果公开。
明确的问责主体:技术出错时,必须有清晰的责任归属,而不能让"系统"成为免责挡箭牌。
写在最后
AI给房屋打"破败分"的争议,表面看是一次地方治理的小风波,深层却触及了智能时代的普遍焦虑:当越来越多关乎个人命运的决定由算法作出,我们如何确保这些系统公平、透明、可问责?居民和市议员的反对声,与其说是对技术的抵触,不如说是对一套缺乏护栏的自动化治理的合理警惕。技术可以提升效率,但不能取代对公民权利的尊重。这,或许才是这场讨论留给所有人的真正课题。
相关推荐

MCP工具投毒:被忽视的AI智能体攻击面与防御之道
MCP工具投毒正成为智能体AI的新攻击面。本文解析工具描述为何可被恶意利用,剖析信息鸿沟与数据外泄链条,并给出白名单注册表、哈希固定、最小权限与链路策略等分层防御方案。
MCP联合创造者:智能体需要的是连接性,而非更强模型
MCP联合创造者David Soria Parra在演讲中指出,决定智能体未来的是连接性与开放标准,而非更强的模型。本文梳理模型能力演进、编程Agent落地逻辑、MCP的无状态改造及Tasks、Skills、身份授权等未来路线图。
SageMaker新技能上线:为编码智能体赋能生成式AI推理优化
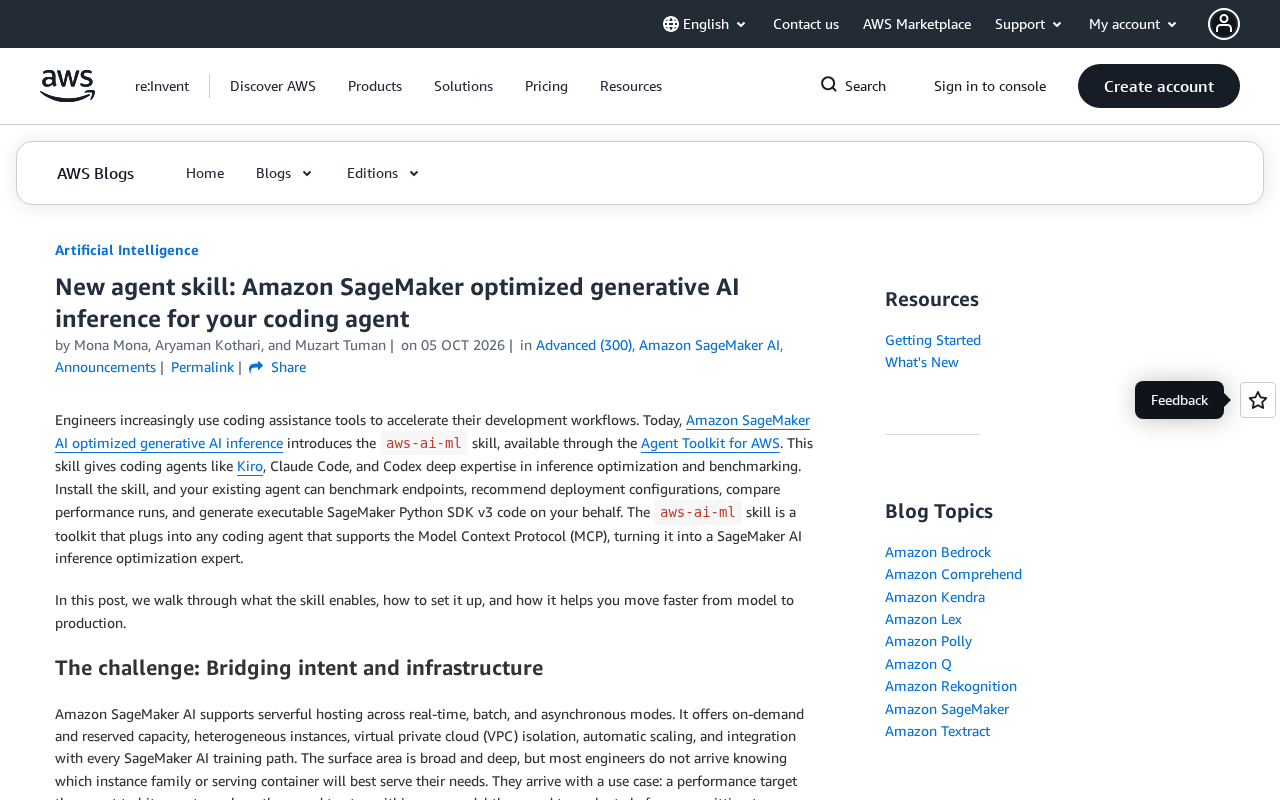
Amazon SageMaker 推出 aws-ai-ml 新技能,通过 Agent Toolkit for AWS 为 Kiro、Claude Code、Codex 等编码智能体注入生成式AI推理优化专长,支持自然语言生成可执行的 SageMaker Python SDK v3 代码完成基准测试、推荐与对比。