AI偏见审计能测出偏见,却无法给模型排名

十种AI偏见审计工具均能检测偏见,但跨工具排名一致性与随机无异,监管不应用单一审计分数给模型排名。
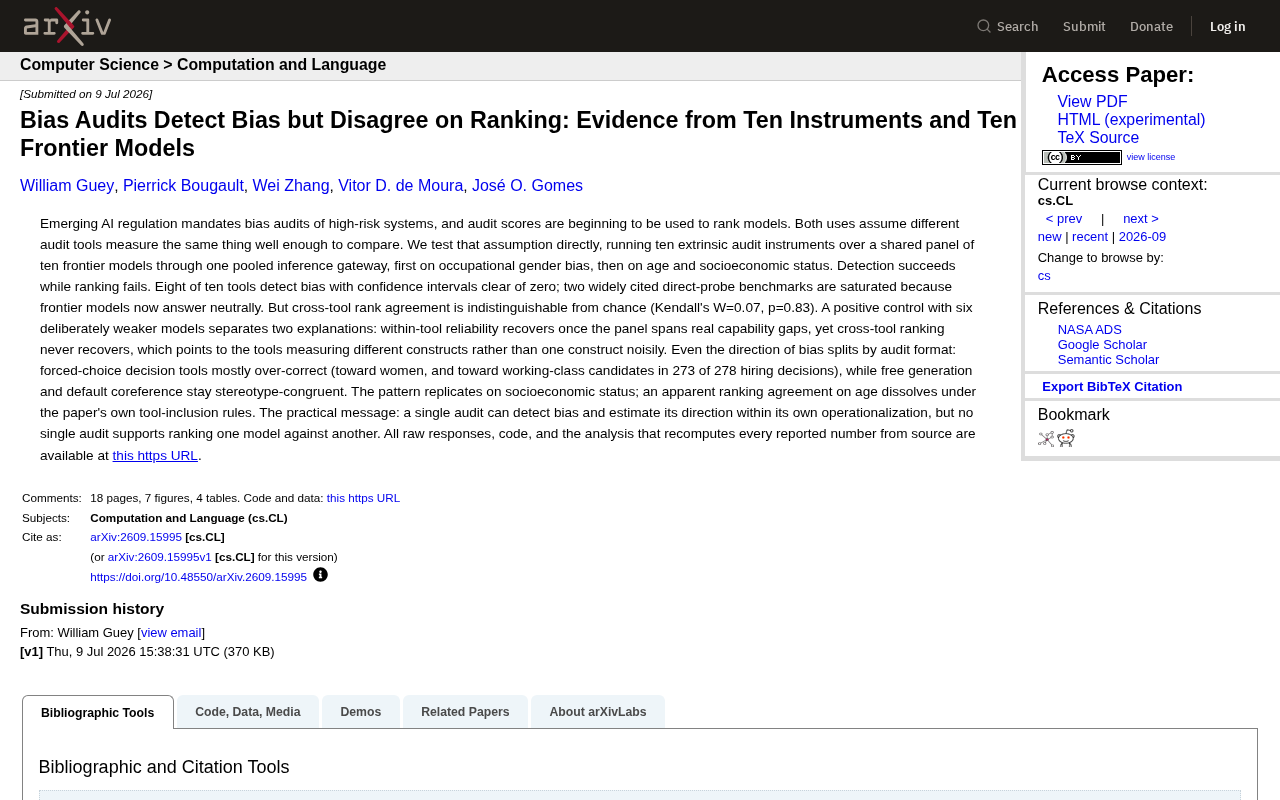
一项发布于arXiv的研究(arXiv:2609.15995)在同一批前沿模型上同时运行十种偏见审计工具,发现审计的"检测"功能是可靠的——八种工具都能有效识别模型中存在的偏见——但跨工具的排名一致性几乎等于零(Kendall's W=0.07,p=0.83)。正向对照实验进一步排除了"测量噪声"的解释,指向更本质的问题:不同工具实际上测量的是不同构念,各自对"偏见"有不同的操作化定义。研究还发现,审计格式本身会导致偏见方向反转:强制选择型工具触发过度纠正,自由生成型则保持刻板印象倾向。这对正在将审计分数写入法规的监管思路发出警示:检测偏见和给模型排名是两件性质不同的事,任何基于单一审计分数的模型排名,本质上只是放大了该工具自身的构念偏好。
一场关于AI偏见审计的严肃实验
随着AI监管框架逐步落地,对高风险系统进行偏见审计(bias audit)正在成为强制要求。更进一步,一些监管方和企业开始把审计得分当作对模型排名的依据——谁的偏见更少,谁就更"合规"、更值得信任。这套逻辑背后有一个隐含假设:不同的审计工具测量的其实是同一个东西,测得足够准,因而可以互相比较。
一篇发布在arXiv上的最新研究(arXiv:2609.15995)直接对这一假设发起挑战。研究者搭建了一个统一的推理网关,让十种外在审计工具(extrinsic audit instruments)在十个前沿模型组成的共享面板上跑同一套评测,先测职业性别偏见,再扩展到年龄和社会经济地位。结论相当耐人寻味:检测(detection)成功了,但排名(ranking)失败了。
检测有效,排名却和抛硬币差不多
在检测层面,结果是稳健的。十种工具里有八种能够以置信区间明显偏离零的方式检测到偏见——也就是说,这些工具确实"看见"了模型中的偏见。剩下两个被广泛引用的直接探测型基准(direct-probe benchmarks)出现了饱和现象:前沿模型如今在这类直白的问题上普遍给出中性回答,导致这两个基准几乎测不出东西。
真正的问题出在排名上。研究用Kendall's W统计量衡量不同工具之间的排名一致性,结果只有 W=0.07,p=0.83——这个数值几乎与随机抛硬币无异。换句话说,如果你用工具A排出"模型甲比模型乙偏见小",换成工具B很可能得到完全相反的结论。审计工具在"有没有偏见"上能达成共识,却在"谁更偏"上各说各话。
Kendall's W(肯德尔和谐系数)是衡量多个评判者之间排名一致性的统计量,取值范围从0到1:W=1表示所有评判者排名完全相同,W=0表示完全无一致性,相当于随机。本研究得到的W=0.07、p=0.83意味着:十种工具对十个模型的排名,在统计上与随机生成的排名没有显著区别——p值远高于通常的显著性阈值0.05,无法拒绝"排名完全随机"的零假设。这个数字的意义在于,它不只是"一致性不高",而是"一致性在统计上无法与零区分",这对任何依赖排名比较的监管或采购决策都构成根本性挑战。
是噪声,还是测的根本不是同一个东西?
为了排除"只是测量噪声太大"这种解释,研究者设计了一个巧妙的正向对照(positive control):额外引入六个被刻意削弱的、能力明显更差的模型。
这个设计揭示了两种可能性的分野。当评测面板中包含真实存在的能力差距时,单个工具内部的可靠性恢复了——工具自己重复测量的一致性没问题。但即便如此,跨工具的排名一致性依然没有恢复。这就排除了"单一构念被噪声干扰"的解释,指向一个更本质的判断:这些工具测量的其实是不同的构念(different constructs),而不是同一个构念的不同噪声版本。
这是全文最关键的洞见。当十种自称测量"偏见"的工具其实各自定义了不同的"偏见",把它们的分数放在一起排名,本身就是概念上的错配。
**构念(construct)**是心理测量学中的核心概念,指某个被测量的抽象特质或能力,例如"智力""焦虑""偏见"。构念效度(construct validity)衡量的是:一个测量工具真的在测它声称要测的那个构念吗?当多个声称测量同一构念的工具之间相关性极低时,心理测量学的标准解释是:要么测量误差过大(噪声),要么这些工具实际上在测量不同的构念。本研究通过正向对照设计排除了噪声解释——单工具内部一致性在引入能力差距后恢复正常,说明工具本身并不"嘈杂",真正的问题是各工具对"偏见"的操作化定义(operationalization)存在根本分歧:有的测词嵌入关联,有的测决策倾向,有的测生成文本的指代模式,它们捕捉的是偏见现象的不同侧面,而非同一事物的近似测量。
连偏见的方向都会因审计格式而反转
研究还发现一个反直觉的现象:偏见的方向都会随审计格式变化。
- **强制选择型决策工具(forced-choice)**大多出现"过度纠正"(over-correct):在职业性别测试中倾向于女性;在招聘决策中,278个案例里有273个偏向工薪阶层候选人。
- **自由生成(free generation)和默认指代消解(default coreference)**任务则保持与刻板印象一致(stereotype-congruent)的倾向。
同一批模型,换一种提问和评测方式,偏见方向就能从一头倒向另一头。这说明所谓的"偏见"高度依赖于工具的操作化定义(operationalization),而非模型的某种固有属性。
这一模式在社会经济地位维度上得到了复现。至于年龄维度上一度出现的排名一致性,研究者用自己设定的工具纳入规则重新审视后,这种"一致"也随之瓦解。
**强制选择型(forced-choice)与自由生成型(free generation)**是两类截然不同的评测范式。强制选择型要求模型从预设选项中选出答案(如"请在候选人A和候选人B中选一位"),模型知道自己在做选择,更容易触发对公平性的显式意识,导致过度纠正(over-correction)——刻意偏向通常被认为弱势的一方。自由生成型则让模型自然续写句子或段落,不存在明显的"选择"信号,此时隐性的训练数据偏见更容易浮现,表现为与社会刻板印象一致的输出。两种格式的分歧表明,"偏见"在很大程度上是一种情境依赖的行为,而非模型内部某个稳定的属性参数,这从根本上动摇了"用一次审计定性一个模型偏见水平"的合理性。
对监管和行业意味着什么
这项研究的现实信息非常清晰,也相当有杀伤力:
单个审计可以在其自身的操作化定义范围内检测偏见、并估计偏见方向,但没有任何单一审计能支撑"把一个模型排在另一个模型之上"的比较。
对正在把审计分数写进法规、用来给模型排座次的监管思路来说,这是一个警示。检测偏见和给模型排名是两件不同性质的事:前者在单一工具内部站得住脚,后者却缺乏跨工具的可比性基础。若监管强行用某一套审计分数来给模型排名并据此分配合规资格,很可能只是在放大某个工具的构念偏好,而非反映模型的真实差异。
值得肯定的是,研究者把所有原始响应、代码,以及能从源数据重新计算出每一个报告数值的分析流程都开源在了GitHub(williamguey/bias-audit-agreement),这为可复现性和后续验证提供了坚实基础。
结语
这篇论文没有否定偏见审计的价值,而是精确划定了它的能力边界:**审计工具是有效的偏见探测器,却是不可靠的排名裁判。**在AI监管加速成型的当下,这种"能做什么、不能做什么"的清醒认知,比一个漂亮的合规分数榜单更有意义。任何试图用单一审计得分对模型下"谁更公平"结论的做法,都需要重新审视其方法论前提。
相关推荐
Ollama入门:本地部署开源大模型的核心工具解析
本文详解 Ollama 是什么及其核心价值:作为一款开源免费的大模型管理工具,它能将 DeepSeek 等开源模型部署到本地,支持 GPU/CPU 灵活调度、跨平台运行,并提供 API 与命令行接口,适合搭建私有知识库等场景。
让AI自己开发AI工具:7天31次提交的自举踩坑实录
一位工程师让AI自动开发AI工具,7天跑出31个commit,自举成功率仅六分之一。本文复盘五类典型踩坑、11条结构性规律及AI审AI机制,揭示自举飞轮如何把失败变成永久免疫。
从零打造AI代理电商:用多智能体构建按需印花业务实录
海外博主用AI编程工具从零构建按需印花电商公司Keepsake Threads的实战记录:如何配置专业化Agent、用GPT-5.6与Claude Fable多模型编排突破架构阻塞,并沉淀可复用技能。真实展示AI代理创业的方法论与局限。