AI智能体支付难题:为何不该让LLM直接掌管API密钥
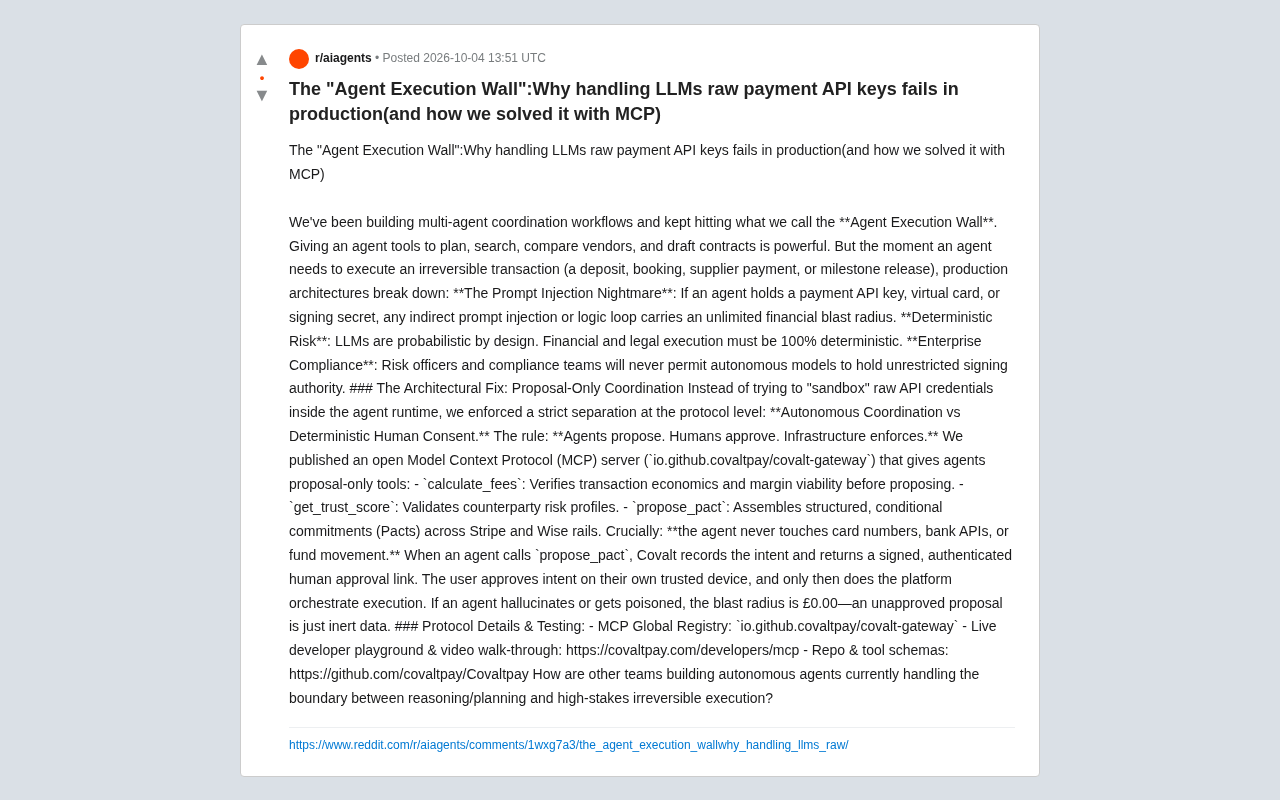
AI智能体只负责提议、人类负责批准,用协议层职责分离解决支付执行的安全与合规难题。
文章围绕「智能体执行墙」这一概念展开:AI智能体在规划与搜索方面已相当成熟,但当涉及不可逆金融交易时,现有架构往往失效。核心原因在于三重风险:间接提示词注入可将持有支付密钥的智能体变成攻击工具;LLM的概率性本质与金融执行要求的绝对确定性天然冲突;企业合规团队不会批准自主模型持有签名权限。文章介绍了一个开源MCP服务器方案,通过协议层职责分离解决这一问题:智能体只能调用「仅提议」类工具(费率计算、风险评分、提议生成),全程不接触真实凭证;每笔不可逆交易必须经过签名认证的人类审批链接才能实际执行。这一设计将财务爆炸半径归零——即便智能体被投毒,最坏结果也只是生成一条未批准的惰性提议。
智能体执行墙:自主性遇上不可逆交易
让AI智能体规划、搜索、比价、起草合同,已经是相当成熟的能力。但当一个智能体需要真正执行不可逆交易时——支付定金、确认预订、向供应商付款、释放里程碑款项——生产级架构往往在此刻崩塌。Reddit 上一支正在构建多智能体协调工作流的团队把这个瓶颈称为「智能体执行墙」(Agent Execution Wall),并分享了他们的解决思路。
核心问题很直白:规划和推理可以容忍概率性,但金融与法律层面的执行必须是100%确定性的。把两者混在同一个运行时里,风险会被无限放大。
三重风险:为什么不能把密钥交给LLM
原帖把这类架构的风险拆解为三个层面,每一个都足以让方案在企业环境里无法落地。
提示词注入的噩梦
一旦智能体持有支付API密钥、虚拟卡或签名密钥,任何间接提示词注入(indirect prompt injection)或逻辑死循环,都意味着无限大的「财务爆炸半径」。攻击者只需在智能体读取的某个外部内容中植入恶意指令,就可能诱导它发起真实转账。传统的沙箱思路试图在智能体运行时内部「关住」这些凭证,但只要凭证在运行时内可被调用,攻击面就始终存在。
间接提示词注入(Indirect Prompt Injection)与直接提示词注入的区别在于攻击路径:直接注入是用户在对话框里手动输入恶意指令,而间接注入则是将恶意指令藏在智能体会主动读取的外部内容中——例如网页、PDF文档、电子邮件正文、数据库查询结果,甚至是供应商返回的报价单。当智能体「读」这些内容并将其传入LLM上下文时,嵌入其中的指令会被模型当作合法意图执行。这种攻击之所以对持有支付权限的智能体特别危险,是因为攻击面极度分散——任何智能体碰过的外部数据源都可能成为载体,防守方几乎无法穷举所有注入点,而攻击者只需成功一次即可触发真实转账。
确定性缺失
LLM 的设计本质就是概率性的。它擅长生成、推断、补全,却无法保证每一次输出都严格一致。而财务和法律执行恰恰要求绝对的确定性——同样的输入必须产生同样的、可审计的结果。把执行权交给一个本质上「会猜」的系统,在合规意义上是不成立的。
企业合规的红线
风控官和合规团队永远不会批准一个自主模型持有不受限制的签名权限。这不是技术偏好问题,而是监管与审计的硬约束。任何试图绕过这一点的架构,都很难通过企业采购与安全评审。
架构解法:只提议,不执行
该团队给出的方案没有纠结于如何「更安全地」把密钥塞进智能体,而是在协议层做了一刀切的职责分离,并提出一条清晰的原则:
智能体负责提议,人类负责批准,基础设施负责执行。
他们发布了一个开源的 Model Context Protocol(MCP)服务器 io.github.covaltpay/covalt-gateway,只向智能体暴露「仅提议」类工具:
calculate_fees:在提议前核算交易经济性与利润可行性;get_trust_score:校验交易对手的风险画像;propose_pact:跨 Stripe 和 Wise 通道组装结构化、带条件的承诺(称为 Pact)。
关键在于:智能体自始至终都不接触卡号、银行API或任何资金流动操作。
人类同意成为执行的唯一开关
当智能体调用 propose_pact 时,平台只记录这个「意图」,并返回一个经过签名认证的人类审批链接。用户在自己可信的设备上确认意图,之后平台才会真正编排执行。
这个设计的妙处在于爆炸半径归零。如果智能体出现幻觉或被投毒,它能产生的最坏结果,也只是生成了一条未经批准的提议——而未批准的提议不过是一堆惰性数据,造成的损失是 £0.00。换句话说,攻击者即使完全控制了智能体的推理过程,也无法越过人类这道确定性闸门。
Model Context Protocol(MCP)是由 Anthropic 于2024年底提出并推动开源的一套标准协议,旨在规范AI模型与外部工具、数据源之间的交互方式。它的核心思路是把「工具能做什么」从「工具实际执行什么」中分离出来,服务端声明工具的输入输出 schema,客户端(即LLM运行时)按协议调用,整个过程可被中间层拦截与审计。MCP 已获得 OpenAI、Google DeepMind 等主流厂商跟进支持,并建立了全球工具注册表。对本文场景而言,MCP 的价值在于它提供了一个标准化的「只暴露部分能力」的接入层——服务端可以精确控制哪些工具对智能体可见,从协议层而非运行时层面限制智能体的操作权限,这比在智能体内部做权限判断要可靠得多。
这是不是过度设计?
值得讨论的是,「提议-批准」模式本质上牺牲了部分自动化程度,换取了安全与合规。对于高频、小额、低风险的场景,每笔都要人类点一下审批链接,体验上未必理想。原帖给出的工具里 get_trust_score 和 calculate_fees 实际上就是在为批准环节做前置准备,让人类决策尽可能轻量。
从行业视角看,这与「Human-in-the-loop」的智能体安全思路一脉相承。真正的争议点不在于要不要人类介入,而在于介入的粒度——是每笔交易都审批,还是设定阈值与规则后批量授权。原帖的方案偏保守,把不可逆交易全部拦在人工确认之前,这在支付这类高风险领域是合理的默认选择。
Human-in-the-loop(HITL)是机器学习与自动化系统领域的一种设计范式,指在自动化流程的关键节点强制引入人类判断,而非让系统完全自主运行。在智能体安全语境下,HITL 并非单纯意味着「人工审核每一步」,而是一种风险与效率的工程权衡:通过设定置信度阈值、金额上限、操作类型白名单等规则,系统可以在低风险操作上保持全自动,只在超出预设范围时才触发人工确认。这与本文方案的「全量拦截」策略形成对比——后者将所有不可逆交易统一交由人工批准,是一种偏保守的默认姿态,适合初期部署或高监管行业,但长期来看可通过引入条件化规则来提升自动化覆盖率,同时维持对高风险操作的人工控制。
给开发者的启示
对正在构建自主智能体的团队来说,这篇分享提出了一个必须回答的问题:你的系统在推理/规划 与 高风险不可逆执行 之间的边界划在哪里?
几条可直接借鉴的原则:
- 永远不要让凭证进入LLM的可调用范围,哪怕有沙箱;
- 把「意图」和「执行」在协议层彻底解耦,意图可以是概率性的,执行必须是确定性的;
- 用签名认证的人类审批作为不可逆操作的最终闸门;
- 通过 MCP 这类标准协议暴露「只读/只提议」工具,降低集成成本的同时收窄攻击面。
该项目已登记在 MCP 全球注册表,并提供了开发者 playground、视频演示(covaltpay.com/developers/mcp)与开源仓库(github.com/covaltpay/Covaltpay),感兴趣的团队可以直接试用其工具 schema。随着智能体支付成为越来越现实的需求,如何守住执行边界,会是接下来一段时间绕不开的工程命题。
相关推荐
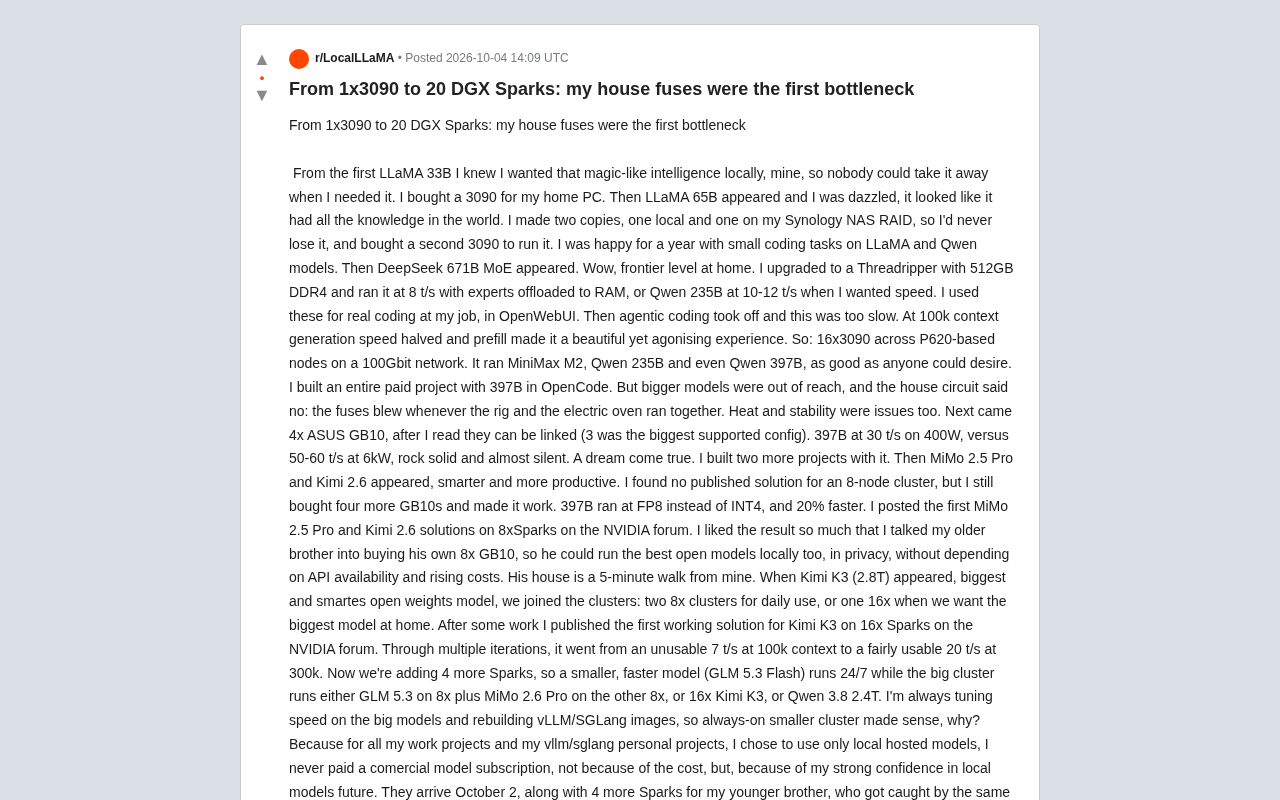
从1块3090到20台DGX Spark:本地大模型玩家的硬件进化史
一位Reddit用户记录了从单块RTX 3090到20台NVIDIA DGX Spark的本地大模型部署进化史,涵盖MoE内存卸载、多卡功耗瓶颈、保险丝跳闸,以及如何在家用集群上跑通Kimi K3等万亿参数开源模型。
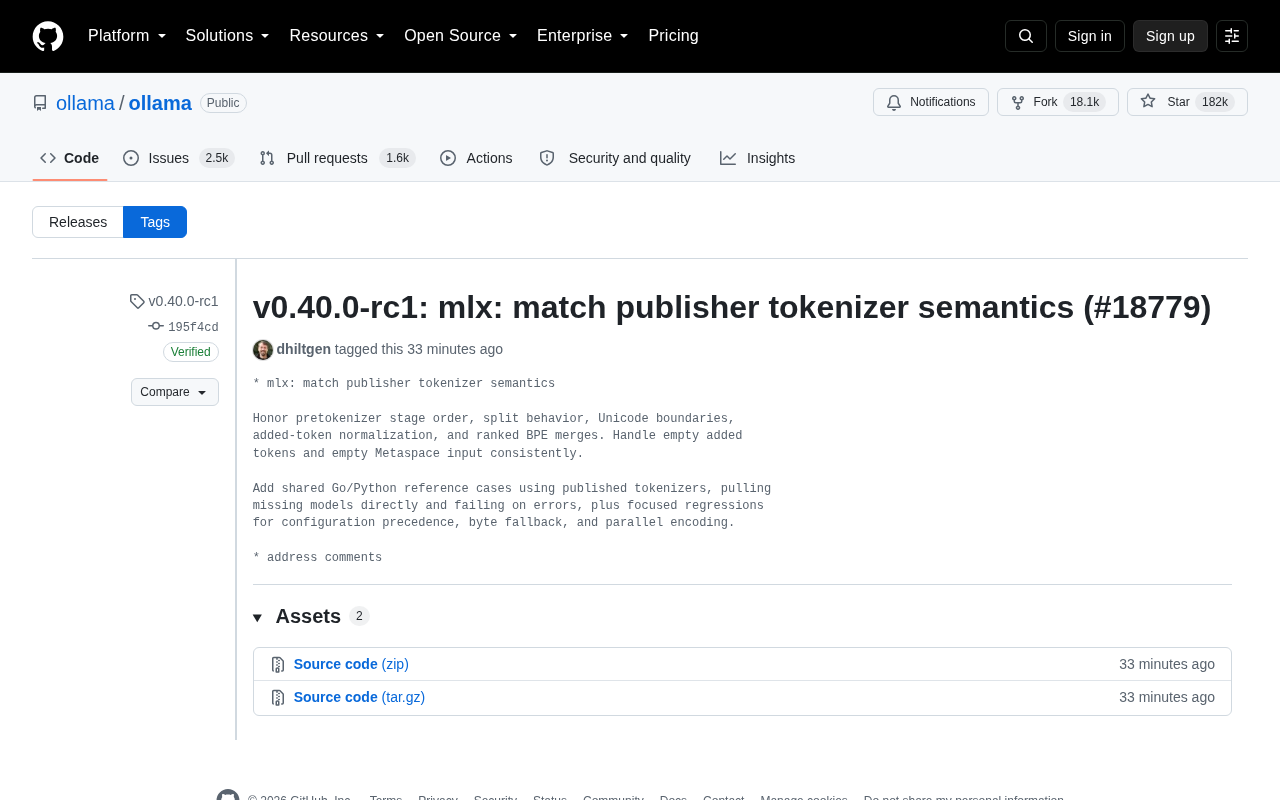
Ollama v0.40.0-rc1 发布:MLX 分词器对齐发布者语义
Ollama 发布 v0.40.0-rc1 预览版,核心更新为 MLX 后端分词器对齐发布者语义,涵盖预分词顺序、Unicode 边界、BPE 合并及跨语言测试保障,提升 Apple Silicon 本地推理一致性。
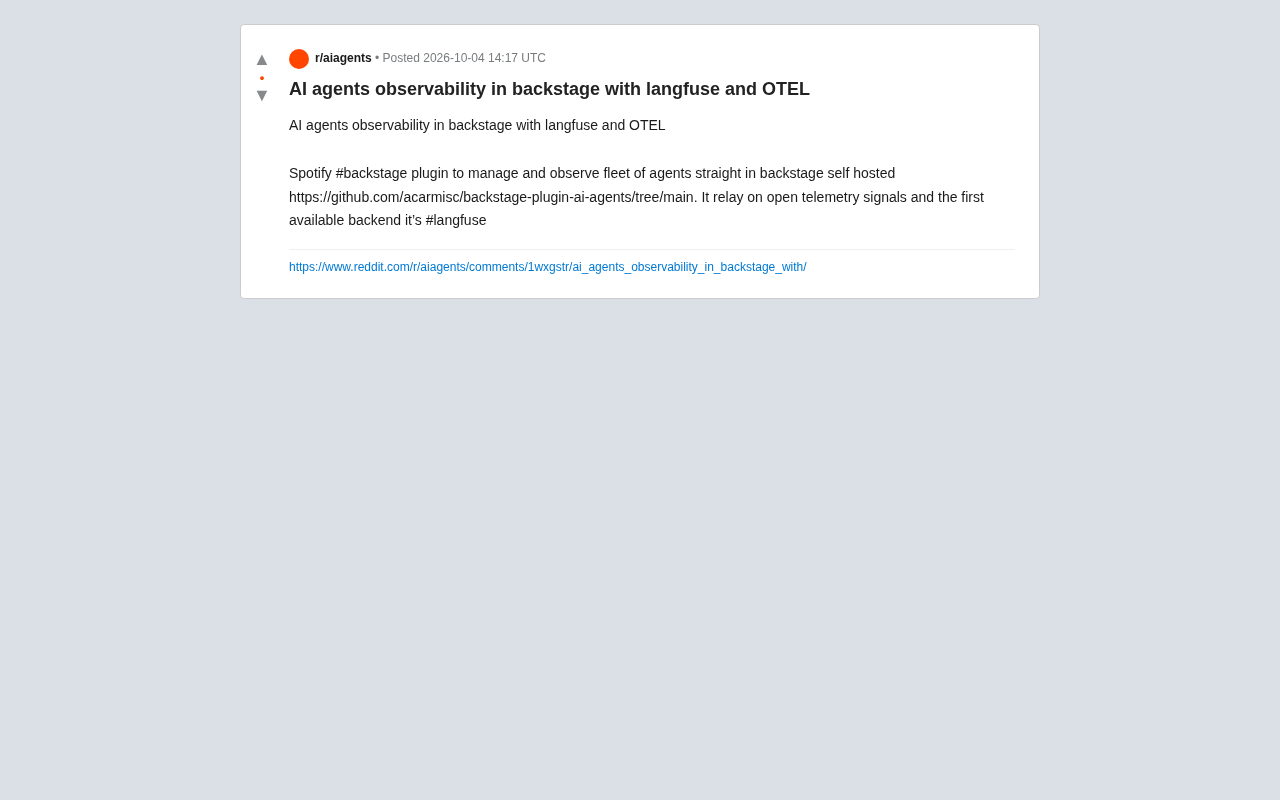
用 Langfuse 与 OTEL 在 Backstage 中实现 AI Agent 可观测性
一个开源 Backstage 插件,基于 OpenTelemetry 和 Langfuse 实现 AI Agent 可观测性,让团队在自托管开发者平台中集中管理和监控 Agent 集群。