Anthropic 无人能敌?Fable 5.2 实测深度解析
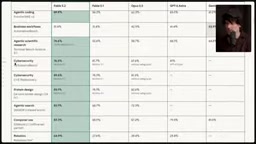
Fable 5.2 基准屠榜但表现尖刺,与 Opus 5.5 形成攻坚与日常的互补格局。
文章基于一位 YouTube 科技频道作者超过十小时的实测,评估 Anthropic 新发布的 Fable 5.2 与 Mythos 5.2。官方基准显示其在 agentic 编码与科学研究上大幅领先,科学推理从 52.6 跃升至 74.6,CVE 复现率约 90%,但作者自建评测发现它在大型代码库分析和真实 PR 审阅上反而不及 Opus 与 Sonnet,呈现「尖刺状」能力分布。Fable 与 Mythos 实为同一底层模型,差异在安全防护与访问权限。定价降至每百万输入 8 美元、输出 40 美元,速度约 106 TPS,接近 Opus。订阅额度上 Fable 有独立上限且连带消耗常规周额度。真实体验中代码审阅质量好但速度慢,前端生成好看、游戏可玩性却不如 Opus。作者由此认为 Anthropic 同时占据攻坚与日常两类模型位置。
一个没有对手的发布周
据 YouTube 科技频道分析,Anthropic 最新发布的 Fable 5.2 与 Mythos 5.2 在多项基准测试中取得了压倒性成绩。视频作者在发布当天连续测试超过十小时,用他自己的话说,这是「近年来见过最彻底的一次基准屠榜」。但更值得玩味的是他得出的结论:真正让 Anthropic 立于不败之地的,或许不是这个新模型,而是它和 Opus 5.5 之间的互补关系。
作者的评测覆盖了官方基准、自建评测集、真实代码库分析、订阅额度实测以及前端与游戏生成等多个维度。这种多角度交叉验证,比单一跑分更能说明一个模型的实际定位。
基准测试:科学领域的巨大跃升
Agentic 与科学基准全面领先
在官方公布的基准中,Fable 5.2 在 agentic coding 的 Frontier Code 2 与 Frontier Suite 2 上拿下最高分,在 agentic science research 上从 Fable 5.1 的 52.6 跃升至 74.6,不仅反超了 Opus 5.5,也超过了此前被视为标杆的 Astra(68.1)。CyberSecBench 上借助 Mythos 版本取得约 90% 的 CVE 复现率,蛋白质设计基准达到 85.1。
作者特别指出,这些成绩里真正有含金量的是「计算机科学之外」的部分。Anthropic 明显在生物、化学与终端科学任务上投入了大量训练资源,而硬件工程方向的 BenchCAD 也出现了大幅提升。他援引与多位电气工程师的交流称,软件领域已经发生的能力跃迁,正在向硬件与电子工程蔓延。
Agentic coding / agentic science research 的含义:这里的「agentic」指的是模型以自主代理(agent)方式工作的能力——不是单轮问答,而是能自行规划步骤、调用工具、读写文件、迭代验证,最终完成一个多步骤任务。agentic coding 通常考察模型在真实代码仓库中定位 bug、修改代码、跑通测试的端到端能力;agentic science research 则考察模型在科研流程中的自主性,例如设计实验、分析数据、检索文献并得出可验证结论。这类基准比传统单题问答更贴近实际部署场景,也更能反映模型「能不能独立把活干完」,因此其分数跃升往往被视为能力代际变化的信号。
CVE 复现率:CVE(Common Vulnerabilities and Exposures)是公开披露的软件安全漏洞编号体系。所谓「CVE 复现」指模型根据漏洞描述,自主构造出能触发该漏洞的环境与输入,从而验证漏洞真实存在。复现率约 90% 意味着模型在绝大多数公开漏洞上都能完成从描述到可运行验证的闭环,这既体现极强的代码理解与推理能力,也意味着显著的双用途风险——这正是 Anthropic 需要通过 Mythos 版本做访问管控的原因之一。
但自建评测暴露了短板
官方跑分之外,作者用自己构建的评测集做了交叉检验,结论并不一致:在分析大型代码库、审阅真实 PR 这类任务上,Fable 5.2 反而低于 Opus 和 Sonnet。他用「spiky」(尖刺状)来形容这种表现——某些维度极高,某些维度明显塌陷。
他把这种特性比喻成团队里那位聪明但偶尔走神的同事:大部分时间说得有道理,偶尔完全不知所云,但剩下那一小部分会突然给出远超预期的洞见。
同一栋楼,两个入口
关于 Fable 与 Mythos 的关系,官方说法是二者为同一底层模型。作者用一个比喻来消化这个设定:同一家餐厅有两个入口,一个有重兵把守、核查身份,另一个守卫较少但需要特殊权限。餐厅内部和菜品完全一样,区别只在于谁能进出、能带走什么。
落到实际使用上,Fable 带有较强的网络安全与生物安全防护,因此可以向所有用户开放;Mythos 则面向通过生命科学与网络安全验证计划审核的机构。这也解释了为什么 CyberSecBench 和蛋白质设计这类基准必须切换到 Mythos 才能跑。
TPS 与推理成本的关系:TPS(tokens per second)指模型每秒输出的 token 数量,是衡量生成速度的直接指标。在 API 定价按 token 计费的体系下,速度本身不直接改变单价,但会显著影响单位时间内的吞吐与用户体验,也会间接反映后端托管效率。作者观察到 Fable 5.2 在降价的同时 TPS 从 81–84 提升到约 106,因此推断其单 token 推理成本低于前代——可能来自更小的模型规模、更高效的推理栈或更好的批处理调度。需要强调的是,这是基于价格与速度的间接推断,官方并未公布参数量或成本结构,读者应将其视为合理猜测而非确证。
价格、速度与订阅额度的真实账本
API 定价与 Fast 模式
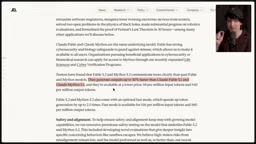
Fable 5.2 的 API 定价为每百万输入 token 8 美元、每百万输出 token 40 美元,相比前代更低。新增的可选 Fast 模式允许用户支付两倍价格换取约 2.5 倍速度,作者认为这个溢价相对合理,尤其是对比 OpenAI 那档需要开启 ultra fast 才能获得明显提速的方案。
速度方面,实测显示 Fable 5.2 达到约 106 TPS,与前代 81–84 TPS 相比提升明显,已经接近 Opus 的 112 TPS。结合降价与提速,作者推断这个模型在推理成本上明显低于前代——要么模型更小,要么在托管效率上做了特殊优化。这一推断是作者的个人判断,官方并未确认。
订阅额度的隐藏规则
作者花大量篇幅实测 200 美元订阅档的额度机制。关键点在于:Fable 有独立的额度上限,且每消耗 2 点 Fable 额度,同时扣除 1 点常规周额度。也就是说,即便 Fable 额度归零,周额度仍可能剩一半——反过来,把 Fable 用满会连带压缩常规额度。
按他的测算,纯用 Opus 5.5 可以把 200 美元订阅用出约 1.4 万至 1.5 万美元的 API 等值;若一半额度分给 Fable 5.2,会损失约四千美元的总额度,但得益于更低的单价和更高的输出效率,实际拿到的 token 数量并不吃亏。他还提到发布时附带的额度重置机制:账号年龄越长,获得的重置次数越多,且 Claude 的重置不会同时重置倒计时,这一点比部分竞品的处理方式更容易规划。
订阅额度与 API 等值的换算逻辑:订阅制产品通常不直接按 token 计价,而是设置使用上限(如每周消息数或额度点数)。作者所说的「用出约 1.4 万至 1.5 万美元的 API 等值」,是指把订阅期内实际消耗的 token 量按 API 单价折算成金额,用来衡量订阅的性价比。这种换算依赖对额度点数与 token 之间兑换比例的估算,会随模型单价、输出长度和缓存命中率而变化,因此只能作为量级参考。它揭示的关键事实是:在重度使用场景下,订阅制的边际成本远低于按量付费,而 Fable 独立额度与常规额度联动扣减的规则,会实质性改变用户的额度规划策略。
真实开发体验:好用,但要盯着
代码审阅是亮点,速度是代价
在真实 PR 审阅任务中,作者认为 Fable 5.2 的整体判断质量不错,且不像其他模型那样容易陷入细枝末节的挑剔。但代价是速度:审阅 8 个 PR 花了约 120 分钟,而 GPT 系列完成同类批次只需 20–30 分钟。他坦言这个时间成本「吃掉了很多价值」。
在代码库分析任务上,61 条结论中有若干错误,成本约 23 美元;相比之下 6.1 Sol 用 29 分钟、4.19 美元给出 38 条全部正确的结论。作者的结论是,Sol 在分析类任务上性价比极高,而 Fable 5.2 更适合放在需要深挖的难题上。
自主性没跟上能力
作者引用朋友的总结:这个模型能力更强,但自主性并没有同步提升。它更擅长在长任务中不被卡住、解决困难问题,但在需要人类判断和取舍的地方,并不会比前代做得更好。
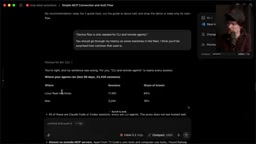
他举了一个颇具说服力的例子:让模型审计一个项目并给出优先级建议,反馈质量很高,事后才发现当时用的其实是 Opus 而非 Fable——这恰恰说明 Opus 5.5 的能力被严重低估。另一个例子则相反:要求模型隐藏录制时不应泄露的邮箱信息,结果模型把邮箱直接写进了那条「安全模式」提示栏里。
前端与游戏生成:好看,不一定好玩
在网页生成测试中,Fable 5.2 产出的 UI 在开启动画技能后观感不错,但关闭技能后会回落到模板化水平。作者还提到模型喜欢堆砌多余的 eyebrow 文本和小标题,通过修改 agent 配置文件可以缓解。
在游戏生成对比中,Fable 版本画面明显更好,但作者认为 Opus 版本的游戏循环更有趣,甚至玩到了通关。他的判断是:Opus 做出来的东西更好玩,Fable 做出来的东西更好看,两者组合才是最优解。
为什么是 5.2 而不是 5.5
作者对版本号做了一番解读,但最终选择不过度推断。他的逻辑很简单:如果这个模型够格叫 Fable 5.5,Anthropic 就会叫它 5.5。之所以停在 5.2,是因为 Opus 5.5 与 Fable 5.2 之间的差距,小于 Sonnet 5.5 与 Opus 5.5 之间的差距——按命名惯例,它够不上那个位置。
这也引出了整段视频最核心的观察:Anthropic 目前同时握有最强的「攻坚型」大模型和最强的「日常主力」模型。Opus 5.5 像一位可靠的主力干将,指哪打哪;Fable 5.2 像一位才华横溢但需要哄着的专家,给它足够难的问题就能交出惊人答案。作者用自家产品 T3 Code 的使用数据佐证这一格局:Opus 5.5 发布后,其流量占比迅速攀升到 63% 以上,而他汇总的跨平台数据显示 Claude 系模型整体占比已升至 78% 左右。
编辑观点
这篇评测的价值不在于复述跑分,而在于揭示了「最强模型」这个说法本身的模糊性。一个模型可以在科学基准上碾压全场,同时在日常代码审阅里输给自家兄弟;可以在视觉生成上领先,却在游戏可玩性上落后。对开发者而言,真正的问题不是「哪个模型最强」,而是「哪类任务该交给哪个模型」——而 Anthropic 目前恰好在这个问题的两端都放了自己的答案。这或许才是「无人竞争」的真实含义:竞争不在模型之间,而在任务分配之间。
相关推荐
火箭为什么不学飞机水平降落?一个物理与工程的权衡
火箭为什么不学飞机那样带机翼水平降落?本文从机翼的升力条件、入轨速度代价与可复用助推器结构复用三个角度,解释航天飞机式着陆与猎鹰9号垂直着陆背后的工程取舍。
AI治理工具能拦截Agent与API调用吗?
Reddit开发者质疑AI治理工具只标记不拦截Agent调用。本文分析标记与实时阻断的能力分层,揭示厂商演示与生产需求的错位,并提供选购时的关键追问清单。
Perplexity新默认设置:体验与背后逻辑
Perplexity新默认设置:体验与背后逻辑
探讨Perplexity默认设置更改的意义与影响,分析默认选项如何引导用户体验,并推测可能涉及的模型、搜索范围或答案风格调整。