Anthropic投入500万美元推动AI数学研究

Anthropic 投入500万美元携手西蒙斯基金会,支持数学界探索AI使用规范。
Anthropic 宣布投入500万美元,包含资金、算力与 Claude 访问权限,与西蒙斯基金会合作支持数学界应对 AI 变革。资助由基金会以社区驱动方式管理,用于工作坊、会议和专家讲座,而非由技术公司指定研究方向。文章指出,将算力与模型访问纳入资助降低了数学家试用 AI 的门槛;数学作为检验机器推理的试金石,对逻辑一致性要求极高,而学术界接纳 AI 的主要障碍在于验证成本。合作的核心价值在于让数学家共同摸索可信的使用范式,而非单纯展示模型能力,其进展值得持续关注。
Anthropic宣布投入500万美元的资助、算力与Claude访问权限,携手西蒙斯基金会(Simons Foundation)共同支持数学界应对AI带来的深刻变革。这一消息通过官方推文发布,迅速在学术与技术社区引发讨论——当大模型开始介入最抽象的数学推理,研究者究竟该如何使用它们,又该如何评估它们的产出?
一笔不只是钱的投入
根据Anthropic公布的信息,这笔总额500万美元的支持包含三个部分:资金、计算资源,以及对Claude模型的访问权限。与常见的科研资助不同,算力和模型访问被明确列为资助内容,这本身就释放了一个信号——在AI辅助研究中,基础设施的门槛可能比经费更现实。
数学研究对推理链条的严谨性要求极高,模型能否稳定输出可验证的中间步骤,直接决定了它是有用的工具还是昂贵的干扰。Anthropic将算力与模型访问打包进资助,实际上是在降低数学家试错的门槛:研究者不必先申请一笔预算去购买API调用,再小心翼翼地证明这笔钱花得值。
为什么交由基金会来管
值得关注的是资助的管理方式。Anthropic并未自己主导项目分配,而是与西蒙斯基金会合作,由后者以社区驱动的方式管理奖项,用于支持工作坊、会议以及领域专家的讲座。
这一安排颇具深意。AI公司擅长的是模型能力,而数学社区自有其评价体系、学术网络与议题优先级。把资金分配权交给长期深耕基础科学的基金会,能减少"技术公司定义研究方向"的疑虑,也让资助更贴近数学家真实的需求。社区驱动意味着方向由下而上产生,而不是由资助方自上而下指定。
西蒙斯基金会(Simons Foundation)由对冲基金亿万富翁詹姆斯·西蒙斯(James Simons)于1994年创立,是美国规模最大的私人基础科学资助机构之一。西蒙斯本人是数学家出身,曾与陈省身合作提出 Chern-Simons 不变量,该基金会长期资助数学、物理、生命科学及自闭症研究等领域,其数学与物理科学部门(MPS)在学术界具有很高的公信力。基金会下设的 Simons Foundation 资助项目以“由科学家评审科学家”著称,评审委员会多由活跃在一线的研究者组成。因此,Anthropic 选择由其管理这笔资助,实际上是把项目分配权交给了熟悉数学社区评价标准的一方,有助于避免 AI 公司因商业利益而左右研究议程的质疑。
数学会成为AI推理的试金石吗
数学长期被视为检验机器推理能力的硬骨头。形式化证明、猜想验证、文献梳理,这些任务对模型的逻辑一致性要求远高于日常问答。Anthropic在推文中直言,弄清楚如何在数学研究乃至更广泛的科学研究中使用AI,"需要时间、努力和资源"——这句话本身透露出的谨慎,比任何宣传口径都更接近现实。
从行业动向看,多家机构都在探索AI与数学的结合路径,但多数集中在工具层面。此次资助若能把工作坊和专家讲座的产出沉淀为可复用的方法论,其价值可能超过资金本身。数学家需要的不是又一个会"编造引理"的聊天机器人,而是能可靠承担繁琐推导、并在出错时清晰暴露问题的协作对象。
形式化证明(formal proof)是指用机器可验证的语言(如 Lean、Coq、Isabelle 等证明助手)将数学定理的证明逐步写出,每一步都可由计算机检查其逻辑正确性。与自然语言证明不同,形式化证明不允许跳步或含糊其辞,因此常被用作评估大模型推理严谨性的基准。近年来,Lean 社区已构建了庞大的数学库 mathlib,并出现了 MiniF2F、PutnamBench 等专门测试 AI 形式化推理能力的数据集。对于 AI 辅助数学而言,形式化验证提供了一种“可验证的中间步骤”机制:模型输出的每一步推导都能被独立检查,从而把“看似合理”与“逻辑正确”区分开来。这也是为什么业界把形式化证明视为检验模型推理可靠性的关键场景之一。
科研AI落地仍待方法论
把视角拉远,这场合作触及的是科研AI的共性难题:模型能力提升很快,但学术界接纳它的速度受制于验证成本。一篇论文中若使用了AI辅助,审稿人如何确认推导无误?资助方如何评估产出?这些问题没有现成答案。
Anthropic与西蒙斯基金会的尝试,本质上是在为这些问题搭建讨论场域。工作坊和会议的意义不在于宣布某个模型有多强,而在于让数学家自己摸索出使用规范。这种"慢"的方式,或许正是推文中所说"需要时间"的真实含义。
对于关注AI应用落地的从业者而言,这次合作提供了一个观察样本:当AI公司把资源投向基础科学,重点不在于模型能解出多少题,而在于能否与学科社区共同建立可信的使用范式。这件事的进展,值得持续跟踪。
在学术出版领域,AI 辅助写作与研究的透明度问题已引发广泛讨论。COPE(出版伦理委员会)、ICMJE(国际医学期刊编辑委员会)等机构陆续发布指南,要求作者披露 AI 工具的使用范围与方式;部分期刊明确禁止将 AI 列为作者,但允许在方法部分说明其辅助作用。然而,数学论文的验证成本远高于文本类研究:审稿人需要逐一核对推导步骤,若其中混入 AI 生成但未经严格验证的引理,错误可能被层层引用而难以追溯。因此,数学界对 AI 辅助的接纳不仅涉及披露规范,还需要建立“可追溯的推导链”和“人工复核关键步骤”的流程。这些方法论问题目前尚无统一标准,正是此次资助中工作坊与会议试图推动解决的方向。
相关推荐
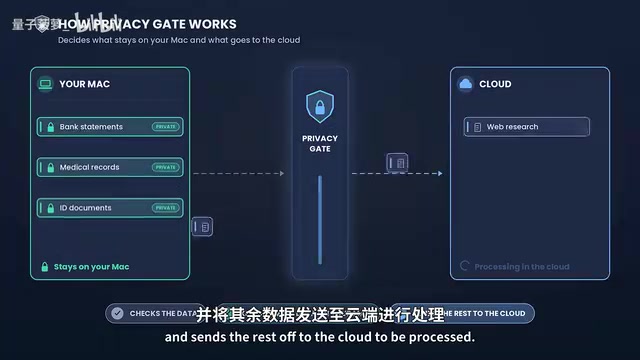
Perplexity混合计算实测:隐私数据不出Mac
Perplexity Hybrid Compute 实测:PrivacyGate 如何拦截敏感数据、本地模型与云端模型如何分工、16GB 与 32GB Mac 的模型差异,以及银行流水、医疗记录等真实场景下的隐私保护表现。
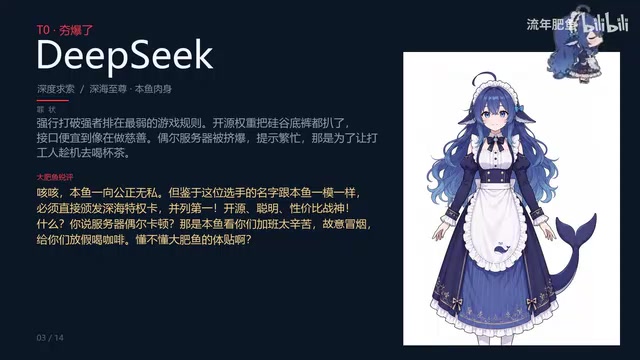
大肥鱼锐评国内外主流大模型:豆包登顶、DeepSeek并列第一
B站UP主大肥鱼锐评国内外主流大模型:豆包凭情绪价值登顶,DeepSeek以开源性价比并列第一,文心、海螺、元宝、Kimi、Qwen、可灵、Claude、Gemini、Grok各被贴上鲜明人设标签。本文梳理这份「最不客观」榜单背后的产品逻辑与选型启示。
AI Agent上生产前如何真测?一套可落地的测试与监控框架
BotGage创始人Pramin Pradeep分享AI Agent上生产前的测试方法:Agent注册可见性、红队测试、生产环境可观测性三步框架,附QA成本从18万美元降至8万美元的真实案例,以及IT角色向Agent监督者转型的分析。