AttnSR:用注意力机制破解长程智能体强化学习奖励分配难题

AttnSR利用策略模型注意力图回溯分配步骤级奖励,无需额外奖励模型即可提升长程智能体RL效率。
长程LLM智能体仅获结果奖励,步骤级信用分配困难。新论文提出AttnSR,在训练回放中沿策略模型的注意力图反向追踪,将最终响应对各步骤的注意力权重转化为奖励分配依据,并以运行基线判断强化或惩罚,无需额外奖励模型或环境展开,属即插即用方案。在Qwen2.5-7B-Instruct上,ALFWorld留出集成功率从91.2%升至97.1%;ScienceWorld各检查点均有改善且环境交互减少29.9%。消融显示收益源于分配方式而非简单累加。局限在于单模型验证与长序列下注意力可靠性待考。
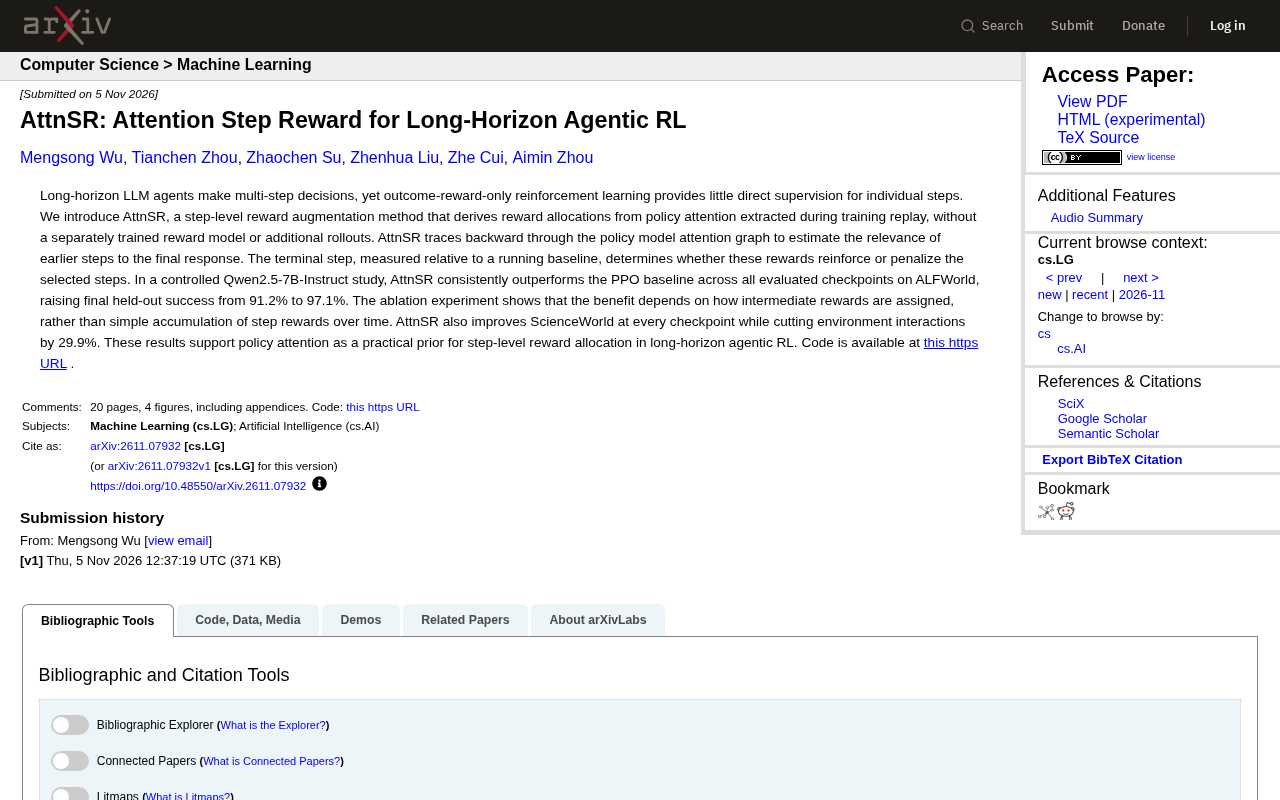
长程LLM智能体需要做出多步决策,但仅依赖结果奖励的强化学习难以为每个步骤提供直接监督。一篇新论文提出AttnSR方法,通过策略模型在训练回放中产生的注意力来推导步骤级奖励分配,无需单独训练奖励模型或额外展开。
核心问题:步骤级监督的缺失
在长程智能体任务中,智能体与环境交互数十甚至上百步,最终只获得一个结果奖励信号。这种稀疏奖励导致信用分配困难——智能体难以判断哪些中间步骤对最终成功至关重要。传统方法要么依赖人工设计的中间奖励,要么训练额外的奖励模型,前者泛化性差,后者成本高昂。AttnSR的出发点很直接:策略模型自身的注意力已经隐含了对步骤重要性的判断,能否直接利用这一信号?
信用分配(Credit Assignment) 是强化学习中的经典难题:当智能体经历一长串动作后只收到一个最终结果奖励时,需要判断这一奖励应归因于哪些中间动作。在长程任务中,奖励信号稀疏且延迟,导致策略梯度估计的方差显著增大——同一成功轨迹中的关键步骤与无关步骤获得相同权重,学习信号被稀释。常见缓解手段包括:设计稠密的中间奖励(依赖领域知识)、训练独立的奖励模型(如基于偏好数据的过程奖励模型 PRM)、或采用蒙特卡洛树搜索式的多次展开来估计步骤价值。这些方法要么泛化性受限,要么带来高昂的计算与标注成本。AttnSR 所针对的正是这一成本与效果的权衡问题。
AttnSR如何工作
AttnSR的核心思路是从策略模型的注意力图中回溯,估计较早步骤与最终响应之间的相关性。具体而言,在训练回放过程中,方法沿着策略模型的注意力图反向追踪,将最终响应对各步骤的注意力权重转化为奖励分配的依据。终端步骤的奖励相对于一个运行基线进行衡量,决定这些分配是强化还是惩罚所选步骤。这一设计避免了额外训练奖励模型或增加环境交互,属于即插即用的奖励增强方案。
你可能没注意到,消融实验揭示了关键洞察:AttnSR的收益取决于中间奖励如何分配,而非简单地将步骤奖励随时间累加。这意味着注意力引导的分配方式本身才是性能提升的来源。
运行基线(running baseline) 在策略梯度类算法中用于降低奖励信号的方差。做法是维护一个随训练推进而更新的参考值(如近期轨迹回报的滑动平均或价值网络的估计),用实际获得的终端奖励减去该基线,得到优势估计(advantage)。优势为正说明该轨迹优于平均水平,应被强化;为负则应被抑制。AttnSR 将这一机制与注意力分配结合:每个步骤获得由注意力权重决定的分摊比例,再整体乘以相对于基线的优势值,因此同一套分配格局会随终端结果的好坏而反向切换为强化或惩罚,避免了对绝对奖励尺度的依赖。
训练回放(training rollout) 指智能体在当前策略下与环境交互并采集轨迹、再用于策略更新的过程。AttnSR 强调其注意力信号直接取自这一常规回放阶段,而非额外的评估展开,因此不增加环境交互次数,这正是其在 ScienceWorld 上实现交互减少 29.9% 的关键原因。
实验结果:ALFWorld与ScienceWorld双验证
在受控的Qwen2.5-7B-Instruct研究中,AttnSR在ALFWorld的所有评估检查点上均优于PPO基线,最终留出集成功率从91.2%提升至97.1%。在ScienceWorld上,AttnSR同样在每个检查点都有改善,同时将环境交互次数减少了29.9%。交互效率的提升对实际部署意义重大——更少的环境调用意味着更低的训练成本和更快的迭代速度。
据论文报告,这些结果支持将策略注意力作为长程智能体强化学习中步骤级奖励分配的一种实用先验。代码已在GitHub开源(fairyshine/AttnSR),便于社区复现与扩展。
ALFWorld 是面向具身文本智能体的基准环境,任务包括在模拟家庭场景中寻找并操作物体(如“把干净的苹果放进冰箱”),需要数十步的探索、定位与操作组合,是检验长程信用分配的常用测试平台。ScienceWorld 则是交互式科学实验环境,智能体需完成涉及测量、加热、混合等操作的实验流程,步骤更长且对中间决策的正确性要求更高。两个基准的共同特点是结果奖励稀疏、中间步骤语义丰富,因而适合评估步骤级奖励分配方法。留出集(held-out set)成功率指在训练中未出现的任务实例上的成功率,用于衡量泛化而非记忆。
启示与局限
AttnSR的价值在于提供了一种轻量级的信用分配思路:不改变策略网络结构,不引入额外模型,仅从已有注意力信号中挖掘监督信息。这为长程智能体RL的训练效率优化开辟了新方向。不过,当前实验基于Qwen2.5-7B-Instruct单一模型,方法在不同架构和规模上的泛化性仍需进一步验证。此外,注意力权重的可靠性在更长序列任务中可能衰减,这是后续研究需要关注的问题。
相关推荐

Anthropic Fable 5.2实测:一句话生成3A游戏与Excel克隆
Anthropic Fable 5.2实测:三行提示词生成可玩《战争机器》克隆、完整Excel和DaVinci Resolve克隆,解析基准测试、Ultra Code模式、token成本与定价策略,评估它是否值得替代Opus 5.5。

赛博寻书:BT社区如何「劫走」塞林格遗作
塞林格未发表的《The Ocean Full of Bowling Balls》仅存于大学图书馆且禁止复制。一个私密BT tracker悬赏六TB上传积分,社区从背诵接力到eBay买书扫描,最终成功让文本流出,却因传播过快被管理员删种。本文复盘这场赛博寻书行动及其讽刺结局。

弹劾防长赫格塞斯?五角大楼战争与中期选举风暴
五角大楼气氛紧张,伊朗战事持续八个月仍无退出方案。评论分析赫格塞斯弹劾动议的真实动机:不是罢免,而是留下政治记录,并剖析战争如何通过油价与生活成本影响中期选举选情。