本地大模型变笨了?揭开Q4量化陷阱与自测指南
本地大模型跑得差,很可能怪错了对象——真正的元凶是你从未主动选择的量化版本与运行器配置。
本文系统拆解了本地大模型性能被低估的核心原因:量化(Quantization)。量化将模型权重从高精度压缩到更低 bit 数以节省显存,但不同 bit 数和算法配方会带来截然不同的结果。8-bit 几乎无损,4-bit 在短任务尚可接受,但在长上下文场景下检索损失可高达 23%,跌破 3-bit 后模型能力急剧退化。更隐蔽的是:OLLAMA、LM Studio 等工具默认静默选择 Q4KM,用户实际评价的是一个从未主动选择的文件;而 KV cache 精度、运行器框架、上下文长度上限和 chat 模板错误,都会让模型悄悄变笨却不抛出任何错误。文章给出了一套五分钟自测法:查清所跑版本、修好技术栈默认值、用真实任务在相邻量化档位做对照实验,以此区分"量化问题"与"模型本身问题"。
跑本地大模型时,你有没有过这样的体验:明明是口碑很好的模型,一上手却觉得笨得离谱?在下结论说"这模型不行"之前,先别急——问题很可能不出在模型本身,而在于你根本没选过、却被默认加载的那个量化版本。
量化(Quantization)是烘焙进本地模型文件里的压缩等级,它是让庞大模型能跑在普通硬件上的关键功臣。但"合理压缩"和"把模型脑叶切除"之间,只隔着一条细线。
量化到底动了什么手脚
以 QWEN 3 的 27B 模型为例,它由 270 亿个数字构成。量化做的事,就是把每一个数字四舍五入到一个更粗糙的网格上——8 bit、4 bit、3 bit、2 bit。于是同一个模型名下,会衍生出 Q8、Q6、Q5、Q4、Q3、Q2 一整个阶梯。
体积差异极其惊人:QWEN 3 27B 全精度需要 56GB,Q8 降到 30GB,Q4 只剩 18GB。而数字后面那些字母——KM、KXL、IQ、UD——才是真正的"配方",它们决定了模型的哪些部分被保护、哪些被压得最狠。
最关键的一点:你跑的那个版本,很可能是工具替你选的。在 OLLAMA 里不加任何标签拉取模型,默认给你的就是 Q4KM,18GB 的文件,却挂着一个写着"latest"的标签。Hugging Face 的 OLLAMA 快捷方式只要仓库里有 Q4KM 就优先选它,Mac 上的 MLX 则默认转换成 4 bit。你以为在评价一个模型,其实是在评价一个你从未主动选择的文件。
数字后面的字母后缀并非装饰,而是不同量化算法的简写。KM / KS / KL(K-Quants 系列)是 llama.cpp 社区开发的分组量化方案,核心思路是把权重分成若干组,每组单独记录缩放因子,从而在低 bit 下保留更多精度层次;KM 是中等组大小,KS 更激进、KL 更保守。IQ(Importance-Quant)系列则更进一步,利用激活值统计来衡量每个权重对输出的"重要性",对重要权重分配更高精度,其余激进压缩,常见于 IQ3_XS、IQ4_NL 等命名。AWQ(Activation-aware Weight Quantization)和 GPTQ 是两种主流的 4-bit 训练后量化框架,前者通过搜索每组的最优缩放因子来最小化激活误差,后者则用二阶梯度信息逐层修正量化误差;两者都能生成名称中带"Q4"的文件,但优化目标不同,结果也不同。了解这些后缀,才能真正比较两个"Q4"文件到底是不是同一回事。
8 bit 几乎无损,4 bit 以下开始危险
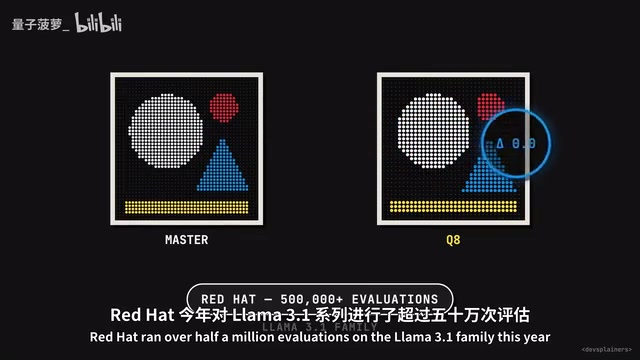
好消息是,8 bit 的代价小到测不出来。Red Hat 今年在 LLaMA 3.1 家族上跑了超过 50 万次评估,8-bit 浮点构建在编程和长上下文测试中与原版持平。即便是 4-bit 的 LLaMA 3.1 8B,在 HumanEval 编程测试上也只从 67.3 掉到 67.1,可以忽略不计。
但跌破 4 bit,情况就变得棘手。一项编程研究把 DeepSeek Coder 压到 2 bit,直接丢失了 67% 的通过解;而同一模型的 4-bit 版本,只为了换取 70% 更小的体积,仅仅牺牲了 2%。
至于 1-bit 的极端案例,Unsloth 曾发布 QWEN 3 235B 的 1-bit 构建,宣称保留 77% 精度。三天后他们贴出免责声明:在长任务上实际得分只有 8%,并且明确警告"别拿它做工具调用"。Reddit 上一个典型例子是:有人问 QWEN 最新的 Python 版本,它跑了一次网络搜索,然后反过来问用户最新的 Python 版本是多少。网友的评价一针见血——"它被 QWEN 化(切脑)了"。
平均分掩盖了两件事:翻转与上下文
单看平均分很容易得出"Q4 无损"的乐观结论,但它藏住了两个真相。
第一是答案翻转。 微软的一篇研究把 4-bit LLaMA 2 拿来测 MMLU,总分只动了三分之一个百分点,看似稳定。但实际有 13% 的单题答案发生了变化——一半从对变错,一半从错变对,正负相抵才显得"没变"。
第二是上下文长度。 一篇 EMNLP 研究让 4-bit 模型跑长文档任务,发现在 12.8 万 token 时检索损失平均高达 23%,其中 70B 的 LLaMA 在某种 4-bit 方法下丢掉了三分之一的分数,而同规模的 QWEN 却几乎毫发无损。一个在短对话里看起来无损的 Q4,到了 6.4 万 token 时可能是完全不同的一头野兽。这也正是 Reddit 分裂成"Q4 够用党"和"Q8 精英党"的根本原因。
同样写着 Q4,可能是两个模型
更麻烦的是,量化"配方"的差异会让同一 bit 数产生截然不同的结果。在 Red Hat 那项研究里,GPTQ 和 AWQ 是两种同 group size 的 4-bit 方法,在 HumanEval 上分别拿到 67 和 63 分——同样的位数,差了整整 4 分,差异来自它们各自选择保护哪些权重。
一位开发者做了更细致的测量:他对 QWEN 3 的 30B 模型做了 16 种量化,每种跑 100 段智能体工具调用对话,用"每个版本与原始模型下一个词选择的偏离程度"打分。结果 Bartowski 的 Q4 和 Unsloth 的 Q4 几乎完全一致,AWQ 和 NVFP4 的 4-bit 版本偏离要大约四分之一,而其中一个 NVFP4 构建甚至比比它更小的文件表现还差。
bit 数只是预算。现代 Q4 的做法是把嵌入层和输出层保留在 6 或 8 bit,狠压中间那些"容忍度高"的部分,然后统一贴上"Q4"的平均标签。真正决定成品的,还有那个跑模型的运行器。
GGUF(GPT-Generated Unified Format)是 llama.cpp 项目推出的本地模型文件格式,前身为 GGML。它将模型权重、分词器词表、chat 模板、超参数等全部打包进单一文件,便于分发和加载。文章提到"GGUF 上传时丢掉了 chat 模板"是一个真实存在的问题:部分上传者在转换或重新打包时没有正确嵌入模板,导致运行器回退到通用的"instruct"提示格式。Chat 模板规定了系统提示、用户轮次和助手轮次的分隔符与特殊标记,模板错误意味着模型收到的实际输入与训练时的格式不符,效果可能大幅下降,而模型不会报错、输出看起来仍是正常文本,这让问题极难被发现。下载 GGUF 文件后,可用 llama.cpp 附带的 llama-gguf-dump 工具或 Hugging Face 的在线 GGUF 解析页面,确认文件内是否嵌入了正确的 tokenizer.chat_template 字段。
罪魁祸首往往不只是量化
上周登上 Hacker News 首页的一篇帖子做了个漂亮的实验:拿全精度 16-bit 的 QWEN 3 30B,只更换注意力内核和推理框架 VLLM,在同样的 10 万 token 提示下,模型的用词从中途开始产生分歧——而用同一内核重跑得到的是逐 bit 相同的输出。也就是说,差异纯粹来自数学计算路径本身。
他们接着保留权重、只压缩 KV cache(模型对对话的"工作笔记"):8-bit 笔记能从工具调用错误中恢复,4-bit 笔记则永远回不来。NVIDIA 自家的 4-bit 格式在 8.8 万 token 上下文处,有一半 token 与参考值不一致,甚至在错误的接口上跑出了错误的 Cisco 命令(把 show arp 跑成了 show run)。
Simon Willison 在 LM Studio 里跑 Q4 QWEN 3,模型总在思考到一半时耗尽 token——原因是 LM Studio 默认上下文只有 8000 token,模型把它全花在"思考"上了。开满上下文后问题就消失了。另一个常见坑是 GGUF 上传时丢掉了 chat 模板,运行器只好回退到一个通用模板,模型看起来还在正常说话,实则越说越笨,而且因为什么都没崩溃,根本没人察觉。
KV cache 是 Transformer 在推理时用来缓存已处理 token 的键值向量(Key-Value)的内存区域,可以理解为模型在对话中积累的"工作记忆"。不对 KV cache 做量化时,它以 16-bit 浮点存储,随上下文长度线性增长,是长文本推理显存占用的主要来源之一;对其做 8-bit 或 4-bit 量化可以大幅节省显存,代价是精度损失叠加在模型权重量化之上。文章提到的实验表明,KV cache 量化对长上下文任务的影响有时比权重量化本身更明显:权重 Q4 尚可恢复的工具调用错误,一旦 KV cache 也压到 4-bit 就变得无法挽回。运行框架(如 llama.cpp、vLLM、LM Studio)通常提供独立的 KV cache 精度参数,在显存允许的情况下,建议将其保持在 8-bit 或 16-bit,尤其是需要长上下文或精确工具调用的场景。
五分钟自测:先搞清楚你到底跑的是什么
与其在论坛上争论"27B 到底行不行",不如动手做三步自测:
第一步:查清楚你加载的是什么
用 ollama show、查看 LM Studio 的模型面板,或直接看 GGUF 文件名。如果你的答案只是"QWEN 27B",那你其实还不知道自己在跑什么。
第二步:修好整个技术栈
把上下文调到高于运行器默认值,使用模型卡上标注的采样器设置,并且在做编程和智能体任务时,把 KV cache 保持在 8 bit 或更高。
第三步:用真实任务做对照实验
从你的实际工作里挑两个任务——一个有明确通过/失败判定,一个需要精确的工具调用。先在当前等级跑,再用同一上传者高一档的版本(Q4 → Q6 或 Q8)跑,其他一切不变。如果失败消失了,问题出在量化等级;如果 Q8 也照样失败,那才是模型本身的问题。
几条值得记住的经验
在相同显存预算下,一个 Q4 的大模型通常打得过 Q8 的小模型,但这条规律在跌到 3 bit 附近就失效了。此外,从成品 16-bit 模型硬压出来的 1-bit 文件,和一开始就为 1-bit 训练的模型(比如之前介绍过的 Bonsai 27B)是完全不同的两回事。
当你发布测试结果时,请写清楚到底跑了什么。比如:"QWEN 3 27B,Unsloth UD Q4KXL,llama.cpp,64K 上下文,Q8 KV,RTX 5090"。虽然拗口,但至少别人能复现。
量化确实会导致错误的评判,但它并不总是唯一的元凶——提示词、模板、测试框架和运行器,全都在共同塑造你最终收到的那段文本。模型名称只告诉你它是怎么被训练的,永远不会告诉你你实际跑的是什么。
相关推荐
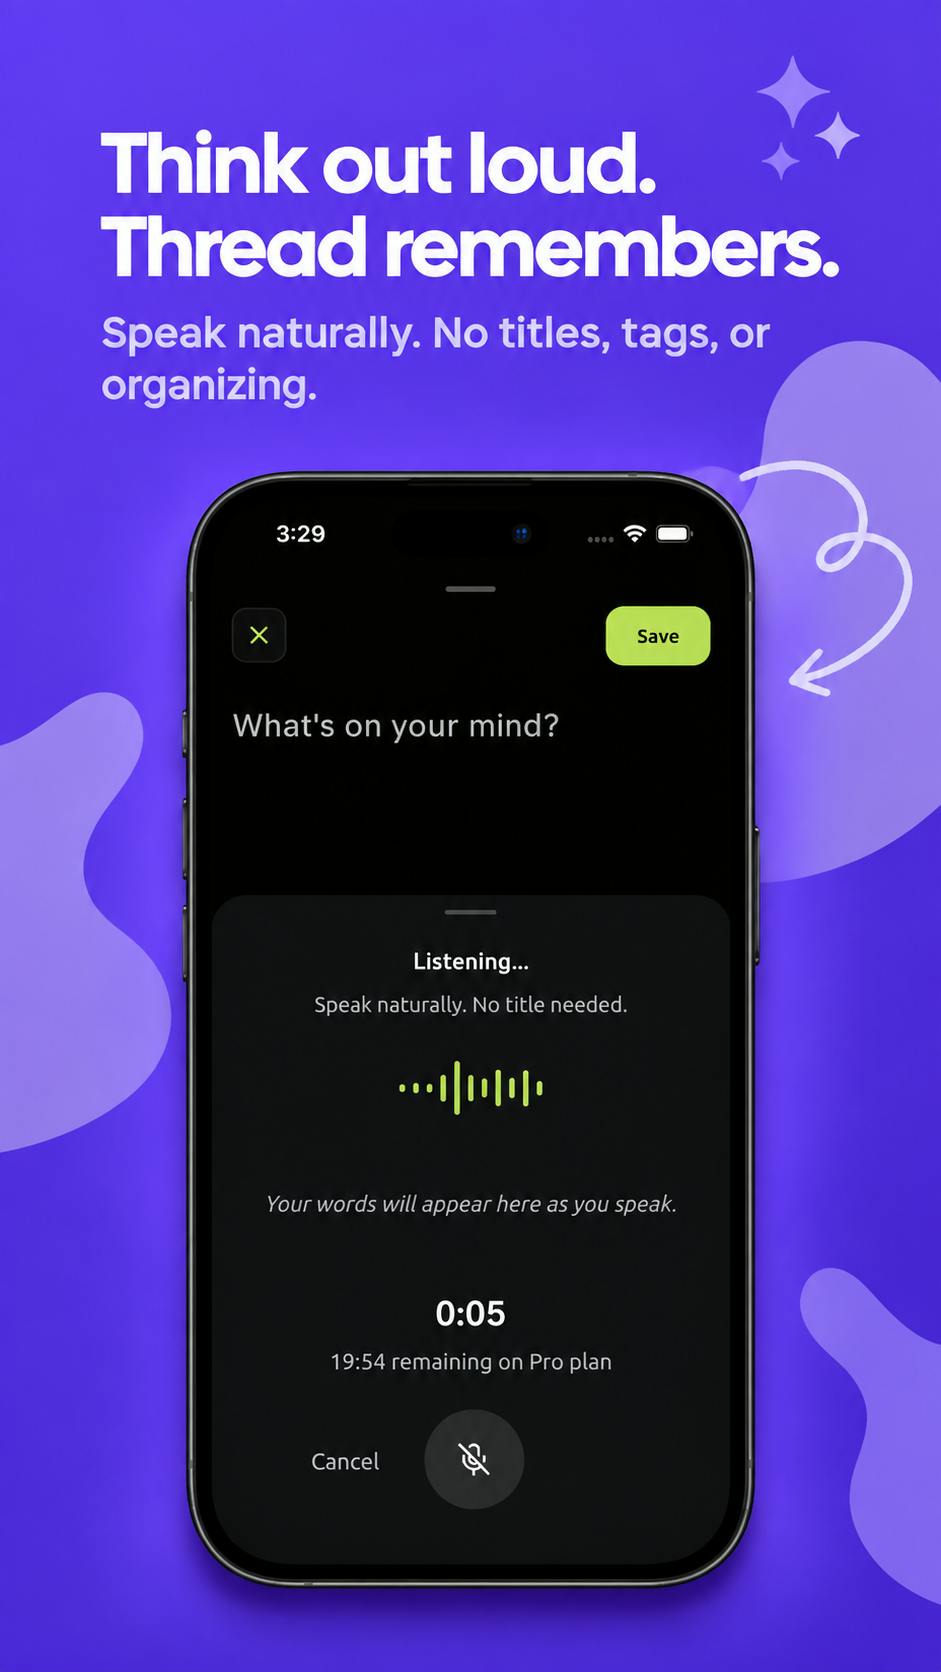
Thread:用AI连接碎片思绪的"第二大脑"日记工具
Thread 是一款登陆 Product Hunt 的 AI 日记与「第二大脑」应用,能自动连接你的碎片想法、语音笔记,发现思维模式并转化为可执行的行动点。本文解析其核心功能与差异化定位。
三个月从零入门深度学习:一份高效AI自学路线图
一份三个月从零入门深度学习的AI自学路线图:Python与数学一周、机器学习一周,随后聚焦计算机视觉、自然语言处理和数据挖掘,以大模型和应用就业为导向的高效学习规划。
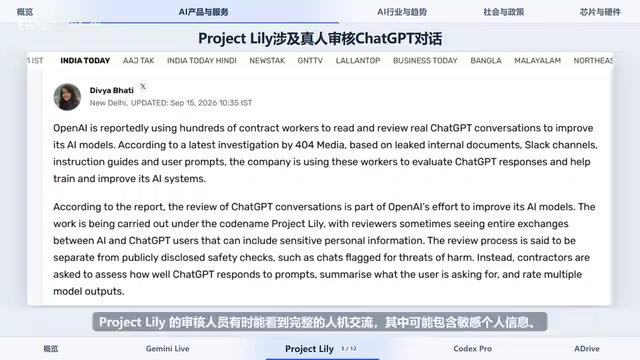
Gemini 3.8 Live发布,Google内部引入Claude编程模型
Google发布Gemini 3.8 Live整合实时对话与视觉体验,OpenAI被曝雇真人审核ChatGPT对话,Google内部引入Anthropic的Claude Opus 5用于开发。本文汇总当日AI领域重要动态。