本地大模型部署入门:Ollama与vLLM部署qwen3实战解析
本文阐释大模型从demo脚本迈向生产服务化部署的核心目标,并对比Ollama与vLLM两类主流工具的定位。
本文梳理了本地大模型生产化部署的核心命题。常见的「下载权重 + 脚本调用」方式只能在单机运行,无法支撑跨服务器、多请求来源的真实业务场景。生产级部署需要达成四项目标:在显存与推理性能之间找到性价比平衡点、将硬件费用纳入方案考量、提供统一便捷的标准化 API,以及支撑高并发访问并通过 HTTP/HTTPS 协议对任意网络设备开放。在此背景下,文章引出两款主流工具:Ollama 以极低门槛实现快速启动,适合个人开发和原型验证;vLLM 依托 PagedAttention 等优化技术实现高吞吐高并发,更贴近生产部署需求。两者定位互补,选型应结合显存预算、并发规模和开发效率综合判断。
大模型的本地化部署,是从「跑通demo」迈向「生产可用」的关键一步。很多人在学习开源模型时,往往停留在下载权重、用 transformers 或 modelscope 加载分词器与模型、调用 model.generate() 生成文本的阶段。这种方式本质上只是借用模型权重做了一次本地演示,距离真正的生产环境还有很大距离。本文结合B站相关教程内容,梳理本地大模型部署的核心目标,并引出 Ollama 与 vLLM 两类主流工具。
为什么demo级调用撑不起生产环境
回顾常见的模型调用脚本,流程大致是:下载开源模型 → 用 modelscope 或 transformers 实例化分词器和 model → 传入文本调用生成 API。这套逻辑在单机上验证模型效果没有问题,但它有一个致命局限——只能在下载模型的那台服务器上操作。
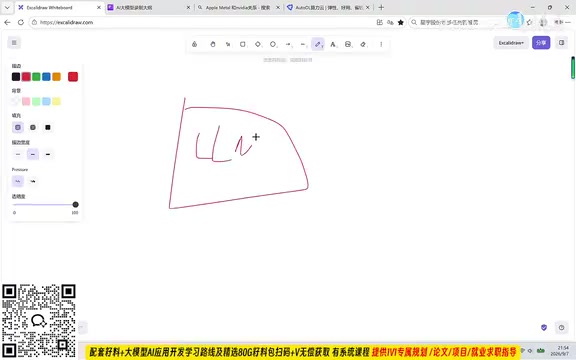
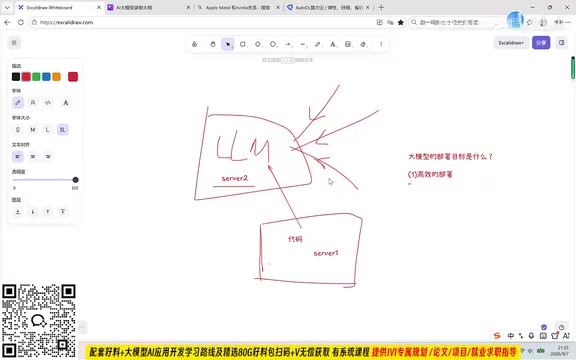
实际生产环境远比这复杂。一个线上的 LLM 服务需要接收来自各式各样用户的请求,而这些请求可能来自多台不同的服务器。更常见的情况是,业务代码和模型本身根本不在同一台机器上:代码文件部署在 server1,而 LLM 模型部署在 server2。这种跨服务器、多请求来源的架构,单纯的脚本调用完全无法支撑。
换句话说,生产级部署要解决的是「服务化」问题:如何让模型以稳定服务的形式对外提供能力,而不是绑死在一台机器的一段脚本里。
大模型部署的四大核心目标
要理解部署工具的价值,先得明确部署到底要达成什么目标。教程中将其总结为几个关键维度。
高效部署:显存与性能的平衡
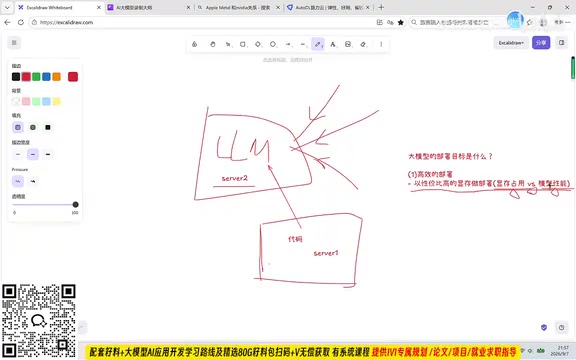
高效部署的第一层含义,是以性价比最高的显存完成部署。这里的关键不是追求极端——既不是用最小显存硬塞,也不是不计成本地堆最高端的显存,而是在显存占用、推理速度与模型性能之间找到平衡点。
举两个极端例子就很清楚:如果把全精度参数全部放进显存做推理,模型效果最好,但显存占用也最大;反过来如果把全部参数塞进 CPU,虽然省去了 GPU,却会面临推理「推不动」的性能灾难。真正的工程目标,是用最少的显存部署出尽可能高效的模型。
量化(Quantization)是实现「高效部署」最常见的手段之一。它将模型权重从高精度浮点数(如 FP32、BF16)压缩为低位整数(如 INT8、INT4),可以大幅减少显存占用——以 INT4 量化为例,理论上显存需求仅为 FP32 的八分之一。代价是模型精度会有轻微损失,但在大多数工程场景下损失可以接受。Ollama 和 vLLM 均支持加载已量化的模型权重,部分工具还支持在加载时动态量化。理解量化的基本原理,有助于在显存有限时做出合理的部署取舍,而不是非得在「全精度大显存」和「CPU 推理」之间二选一。
费用核算:部署方案的隐性成本
在面向生产的本地模型部署中,费用核算是绕不开的前置环节,而部署方案本身就是费用核算里的重要变量。不同的部署方式会直接影响显存需求和硬件成本,因此选择合适的工具不仅是技术问题,也是成本问题。
便捷性:统一稳健的部署API
第二个目标是以更快、更便捷的方式部署模型。理想状态是一两行代码就能完成部署,而不是写一大堆代码、反复调试。这要求部署工具提供统一且稳定的 API,能够覆盖各种类型的模型,形成一套标准化的部署方案。
高并发与可访问性
生产级应用往往要面对大量用户同时请求——可能是 50 个、100 个用户并发访问同一个模型服务。能扛住更高并发的部署方案,自然更具优势。
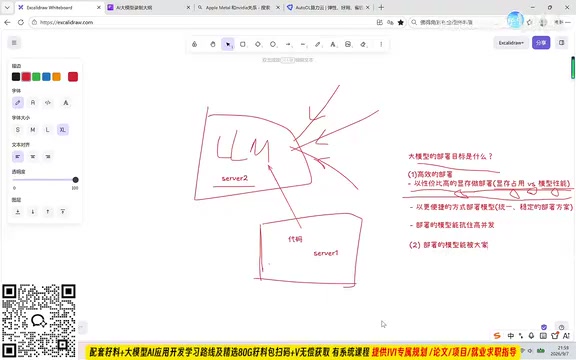
此外,部署的模型还要能被广泛访问。模型服务启动后会对外暴露一个端口(如 8000、9000 等),只要网络互通,无论请求方来自手机、client server 还是其他机器,只要双方遵循最通用的 HTTP/HTTPS 协议,就能调用这个模型服务。这种基于标准协议的访问方式,正是服务化部署的本质。
Ollama 与 vLLM:两类部署思路
基于上述目标,教程引出了两款主流的本地大模型部署工具:Ollama 与 vLLM。
Ollama 以极致的便捷性见长,适合个人开发者和快速原型验证。它封装了模型下载、加载、服务启动的全流程,通常几条命令就能把模型跑起来并对外提供 API,极大降低了上手门槛。
vLLM 则更偏向生产场景,核心优势在于高吞吐和高并发。它通过 PagedAttention 等优化技术提升显存利用率和推理速度,能够更好地应对大量用户并发请求的情况。教程中提到将通过 vLLM 部署 qwen3-0.6B 模型,正是用一个轻量模型来演示 vLLM 的部署流程。
两者并非互斥:Ollama 适合追求便捷的轻量场景,vLLM 更适合对性能和并发有要求的生产部署。理解它们的定位差异,有助于根据实际的显存预算、并发需求和开发效率来做选型。
vLLM 的核心创新 PagedAttention 借鉴了操作系统中虚拟内存分页管理的思想。传统推理框架在处理并发请求时,会为每条请求预先分配连续的 KV Cache 显存块,导致显存碎片严重、利用率低下。PagedAttention 将 KV Cache 切分为固定大小的非连续页(Page),按需动态分配和释放,使不同请求可以共享显存空间。实验数据显示,这一机制可将显存利用率提升至近 100%,并发吞吐量相比 HuggingFace Transformers 提高数倍至十余倍。这也是 vLLM 在生产环境中优势显著的根本原因:相同的硬件能同时服务更多用户请求。
小结
从脚本调用到服务化部署,本质是从「能跑」到「能用」的跨越。衡量部署方案的标准可以归结为几点:显存与性能的平衡、费用可控、API 便捷统一、能扛高并发、可被标准协议访问。Ollama 和 vLLM 分别代表了便捷与高性能两条路径,掌握它们的特性和适用边界,是本地大模型工程化的重要基础。
相关推荐

MCP工具投毒:被忽视的AI智能体攻击面与防御之道
MCP工具投毒正成为智能体AI的新攻击面。本文解析工具描述为何可被恶意利用,剖析信息鸿沟与数据外泄链条,并给出白名单注册表、哈希固定、最小权限与链路策略等分层防御方案。
MCP联合创造者:智能体需要的是连接性,而非更强模型
MCP联合创造者David Soria Parra在演讲中指出,决定智能体未来的是连接性与开放标准,而非更强的模型。本文梳理模型能力演进、编程Agent落地逻辑、MCP的无状态改造及Tasks、Skills、身份授权等未来路线图。
SageMaker新技能上线:为编码智能体赋能生成式AI推理优化
Amazon SageMaker 推出 aws-ai-ml 新技能,通过 Agent Toolkit for AWS 为 Kiro、Claude Code、Codex 等编码智能体注入生成式AI推理优化专长,支持自然语言生成可执行的 SageMaker Python SDK v3 代码完成基准测试、推荐与对比。