本地大模型选型指南:Qwen与DeepSeek怎么选?
普通人在本地离线运行大模型的选型、配置与零代码部署完整指南
本文面向无技术背景的普通用户,系统讲解如何在个人电脑上部署离线大模型。文章从两大实际痛点切入——断网无法使用AI、敏感数据不敢上传云端——指出本地大模型是兼顾隐私与自由的解决方案。在模型选型上,推荐日常使用响应快的Qwen,复杂推理场景用DeepSeek,并强调要选官方蒸馏版而非超大参数模型。通过"模型是家具、显存是房间"的比喻,文章直观解释了参数量与显存的关系,并给出按显存大小对号入座的具体建议,同时指出Q4量化是消费级硬件运行大模型的必备前提。工具层面,LM Studio、Cherry Studio+Ollama、Mac专属MLX三条路线覆盖不同用户需求,均无需命令行操作。最后提醒模型文件须存于固态硬盘以保证加载速度。
为什么要在本地跑大模型
出差时高铁断网,AI网页转圈罢工;公司的保密合同又不敢往云端上传——这是很多重度AI用户都遇到过的尴尬。本地大模型正是为解决这两个痛点而生。
只要把模型部署到自己的电脑,拔掉网线、开启飞行模式,AI照样随叫随到。它带来两个实实在在的好处:一是彻底的Token自由,不用再为API调用次数和费用发愁;二是数据百分之百锁在自己的硬盘里,敏感文件不出本地,隐私和合规都有了保障。
对个人用户而言,现在的消费级电脑确实已经具备完全离线运行大模型的能力,关键在于选对模型、配对硬件、用对工具。
Qwen 与 DeepSeek:日常陪伴 vs 烧脑推理
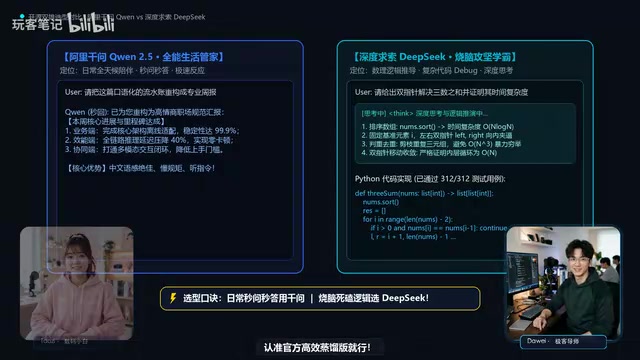
网上一搜全是黑话,阿里的通义千问(Qwen)和深度求索的 DeepSeek 到底有什么区别,小白该怎么选?
一句话概括选型逻辑:日常全天候陪伴、需要秒问秒答的场景,用 Qwen;遇到烧脑难题、需要严密逻辑推理时,再叫 DeepSeek。
Qwen 的定位更偏向通用助手,响应快、体验流畅,适合写文案、问答、翻译等高频日常任务。DeepSeek 则在复杂逻辑和深度推理上更有优势,适合解数学题、分析代码逻辑这类需要「慢思考」的场景。
需要强调的是,个人电脑千万别盲目去跑万亿参数的巨无霸模型——那既跑不动也没必要。认准官方发布的高效蒸馏版即可,蒸馏版在保留核心能力的同时大幅压缩了体积,更适合本地部署。
看懂 7B、14B 和量化:模型是家具,显存是房间
模型名字后面的 7B、14B 是什么意思?是不是数字越大越聪明?6G 显存买个 5.8G 的模型刚好塞满就行?
这里有个经典误区。7B、14B 指的是模型参数量(Billion,十亿),数字越大通常能力越强,但对硬件的要求也越高。
一个形象的比喻:模型是家具,显存是房间。 不仅家具本身要能进屋,对话历史还要占用临时空间。所以显存不能刚好塞满,必须预留至少 1.5 到 2G 的活动显存,否则一开长对话就会卡死甚至崩溃。
另一个关键点是量化。普通电脑一定要认准 INT4 或 Q4 量化版本——体积能减重约 70%,而智商几乎不打折。量化相当于给模型「压缩打包」,是消费级硬件跑大模型的必备前提。
量化(Quantization)是一种将模型权重从高精度浮点数(如32位或16位)压缩为低精度整数(如4位)的技术。INT4 和 Q4 是目前最常见的4位量化格式,前者多见于 GPTQ 等量化框架,后者则是 llama.cpp 生态中 GGUF 格式的命名惯例。两者原理相近:用更少的比特位来近似表示每个参数的数值,从而大幅减少内存占用和计算量。代价是精度上有极小损失,但在实际使用中,对日常问答、写作、代码等任务几乎无感知。消费级显卡(如6G、8G显存)之所以能跑起原本需要数十G显存的模型,正是拜量化所赐。选择模型文件时,文件名中出现 Q4_K_M、Q4_0 或 int4 等标识,即为4位量化版本,是本地部署的首选。
按显存对号入座:该下多大尺寸
搞懂原理后,最实用的就是按自己的硬件对号入座,选一个绝不卡死的尺寸。
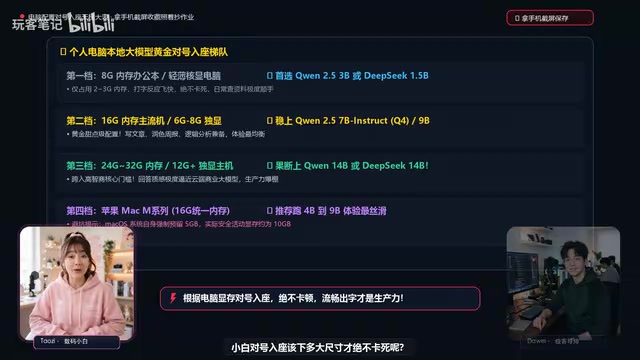
- 核显轻薄本:选 Qwen 2B 或 4B 的小尺寸模型
- 6G 显存:可上 7B 模型
- 8G 显存:放心上 9B
- 12G 以上大显存:果断上 14B,跨入高智商门槛
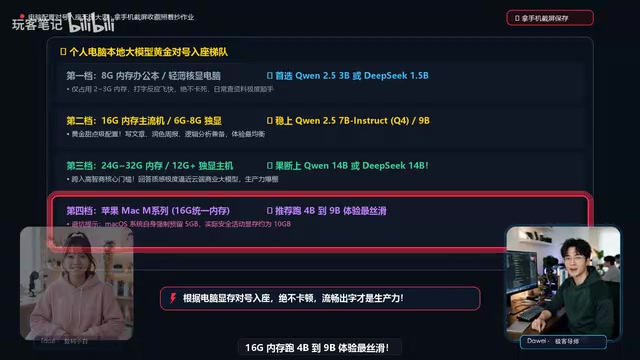
- 苹果 Mac:别忘了预留系统占用,16G 内存跑 4B 到 9B 体验最丝滑
核心原则是:在自己电脑上能流畅出字的小模型,远比卡死的大模型有用 100 倍。 与其追求参数虚荣,不如追求实际体验。
零代码部署:不用碰命令行
完全不会写代码,是不是还得折腾黑色命令行和复杂的 Python 环境?
好消息是完全不用。现在的本地部署工具已经做到了图形化、傻瓜式:
- 纯小白首选 LM Studio:界面像应用商店,模型一键搜索下载,还自带显存「红绿灯」仪表盘,帮你判断某个模型能不能跑得动,绝不卡死。
- 喜欢高颜值对话框:可以用 Cherry Studio 搭配 Ollama,界面更美观,功能也更灵活。
- Mac 用户:还能用专属的 MLX 方案,三分钟无脑开跑。
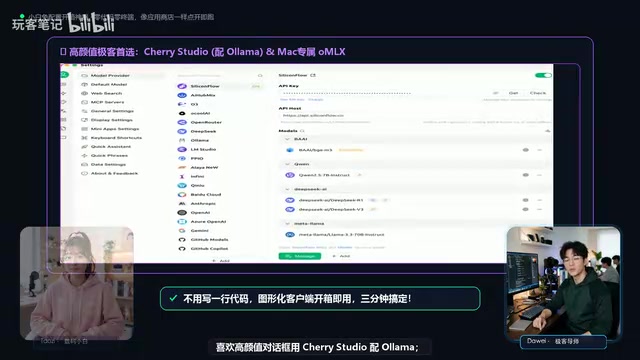
Ollama 是目前最流行的本地大模型运行时之一,本质上是一个在本地运行的后台服务,负责模型的下载、加载与推理调度,并对外暴露与 OpenAI API 格式兼容的接口。这意味着任何支持自定义 API 地址的前端工具(如 Cherry Studio、Open WebUI 等)都可以直接接入,无需额外适配。MLX 则是苹果专为 Apple Silicon(M系列芯片)设计的机器学习框架,能充分利用 Mac 的统一内存架构(CPU 与 GPU 共享同一块内存),使大内存 Mac 在本地推理上具有显著优势——16G 统一内存实际可用于模型的显存远大于同容量的 PC 独立显卡。LM Studio 内部同样集成了 llama.cpp 作为推理引擎,图形界面只是在其之上封装了更友好的操作体验。
一个容易被忽略的细节:硬盘
最后有个常被忽视的提醒:模型文件一定要保存在**高速固态硬盘(SSD)**里,千万别塞进机械硬盘。机械硬盘读取慢,加载模型时会慢吞吞卡半天,严重影响体验。
把这些要点串起来——选对模型(Qwen 日常、DeepSeek 推理)、匹配显存尺寸、认准 Q4 量化、用图形化工具部署、存到固态硬盘——普通人也能轻松拥有一个断网可用、数据私密的本地 AI 助手。
相关推荐
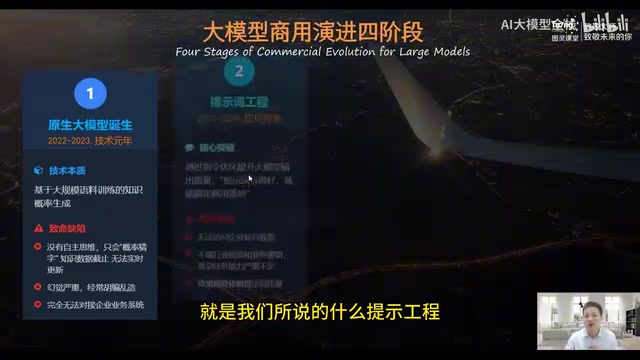
AI Agent实战入门:从大模型演进看智能体的价值与落地
从原生大模型、提示工程、RAG到AI Agent智能体,系统梳理大模型商业落地的四个阶段,解析Agent的翻译官、工具达人、记忆管家、任务管家四大核心能力,并给出企业级Agent入门的三个实战项目路线。
AI Agent智能体系统学习路径拆解:从原理到实战的完整框架
AI Agent智能体系统学习路径拆解:从Agent原理、Prompt工程、RAG知识库到多Agent协作与工具调用,再到个人知识库助手、智能客服等实战项目,帮零基础学习者打通从入门到落地的完整链条。
AI Agent智能体入门:大脑、记忆与工具三要素详解
从零理解AI Agent智能体:详解大脑、记忆、工具三大核心组件,梳理大模型从原生模型、提示工程、RAG到Agent的四阶段演进,帮你搞懂Agent到底解决了什么问题以及为何值得学习。