本地跑DeepSeek大模型:256GB显存六条路线成本解析

本地跑大模型的关键不是显存GB数,而是能跑多少位量化;256GB机器在争3-bit线。
文章以B站UP主Kai的视频为线索,探讨本地运行大模型时显存容量与量化精度的关系。核心观点是:决定体验的不是显存GB数,而是“bits per weight”,即每个权重用多少位存储。256GB机器本质上是在争夺3-bit量化这条线。文章对比了六条现实路线:Mac Studio、双DGX Spark、Strix Halo双机、RTX 3090加DDR4服务器内存、八卡堆叠、二手V100/MI50,逐一分析其成本、速度、升级路径与隐藏代价。其中3090加DDR4路线因利用MoE稀疏性和DDR4价格优势,以约6000美元实现26 tokens/s,且4-bit升级仅需798美元,成为最被低估的方案。文章最后以“第四位的价格”为框架,给出分场景建议,并指出API在多数情况下更具经济性,本地部署的真正价值在于数据隐私。
本地运行大模型的门槛,从来不是显存数字本身,而是"你的显存能装下多少位精度的模型"。这是B站UP主Kai在一期深度视频里反复强调的观点,也是理解当前本地AI硬件选购的核心线索。
UP主在视频开头描绘了一个很多人都经历过的场景:开着十几个标签页翻规格表、逛二手服务器内存、看论坛里为几个bit吵得不可开交,最后发现自己真正想解决的问题只有一个——本地跑一个足够好的模型,为什么这么难?
问题的起点:为什么大家都在盯256GB
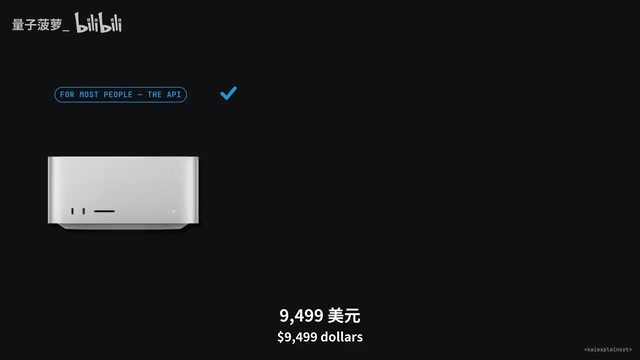
视频的观察起点是Apple的定价策略。256GB版Mac Studio售价9,499美元,512GB版售价22,299美元。简单一减就会发现,两台256GB加起来比一台512GB还便宜701美元。这种定价直接引爆了社区讨论:既然双机总价更低,256GB这个数字自然成了所有人讨论的中心。
接下来是模型侧。DeepSeek广告 v4.1 Flash总参数5520亿,另有一个名为Ngram的查找表包含1960亿参数,完整下载约510GB。表面上这个体积对256GB机器毫无希望。但关键在于,Ngram表每个token只读取少数几行,不需要常驻高速内存。像Dwarfstar这类新引擎会把189GB的查找表留在SSD上按需读取。剥掉这部分后,核心模型的2-bit构建只需要152GB,256GB机器还能剩近100GB余量。
真正决定体验的指标:bits per weight
UP主用音频压缩做了个很贴切的类比:128kbps听起来没问题,64kbps开始丢失高频细节,32kbps就像地下室打来的电话。模型的每个权重都用固定位数存储,位数越低,数值被压到越粗的网格上,模型行为偏离训练时的程度就越大。
Ansloth团队做过实际测量:把不同量化版本和DeepSeek原始模型对比,统计下一个token选择的一致率。2-bit一致率91.2%,大约每11个token错一次;3-bit是95.1%,每20个token一次;4-bit是98.5%,每67个token一次。对应的内存需求:2-bit约165-200GB,3-bit约234-262GB,4-bit约298GB。
这张表解释了整期视频的框架——256GB机器本质上是在争夺3-bit这条线,而4-bit在不同路线上的代价差别巨大。
量化(Quantization)是将模型权重从高精度(如16-bit浮点)映射到低精度(如2/3/4-bit整数)的过程,本质是用更少的比特表示每个数值,从而大幅压缩模型体积和内存占用。常见的后训练量化方法如GPTQ、AWQ,会在少量校准数据上最小化量化误差;而像Unsloth的1-bit构建则采用更激进的二值化或三值化策略。量化位数越低,权重被舍入到的网格越粗,模型输出分布偏离原始模型的程度越大,表现为生成质量下降、逻辑错误增多。文中提到的“下一个token一致率”正是衡量这种偏离的实用指标:它统计量化模型与原始模型在每一步预测中选中相同token的比例,比困惑度更直观地反映实际使用中的行为差异。
六条现实路线,代价各不相同
Mac Studio:最省心,但有一个隐藏开关
256GB M5 Ultra基础版9,499美元,80核GPU版10,799美元,内存带宽1.2TB/s,一根电源线、近乎静音。有两个问题:一是发货周期长达13到17周;二是macOS默认只给GPU约四分之三的内存,也就是约192GB。这意味着出厂状态下新机只能跑2-bit模型,而3-bit的能力就锁在一条终端命令后面。设置GPU内存上限到248GB后3-bit就能装下,但这个设置每次重启都会重置,需要写进启动脚本。
速度方面,引擎的影响远超硬件差异。TensorFold构建在80核芯片上跑混合2/3-bit模型,写入70-105 tokens/s;更常见的MLX路线在64核上写入26-29 tokens/s,读取不到500,两者读取速度差了近五倍,而这差距几乎全部来自引擎和构建方式,不是GPU核心数。
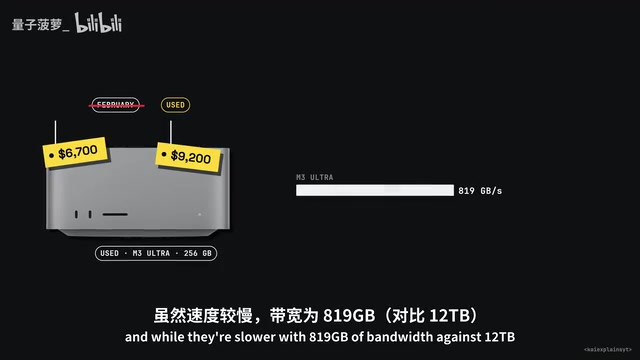
二手市场上,256GB M3 Ultra在Swappa上曾卖到6,700至9,200美元,带宽819GB/s,比新款慢,但能立刻拿到。
macOS的GPU内存分配机制与Linux不同。在Apple Silicon的统一内存架构下,CPU和GPU共享同一块物理内存,但系统默认会为GPU保留约75%的可用内存作为“推荐最大工作集”(recommendedMaxWorkingSetSize),以防止系统整体内存压力过大。对于256GB机型,这意味着GPU默认只能使用约192GB,超出部分会触发交换或直接分配失败。通过终端命令sudo sysctl iogpu.wired_limit_mb=248000可以手动提高这一上限,但该设置仅对当前启动会话有效,重启后恢复默认值。因此需要将其写入LaunchDaemon或登录脚本才能持久化。这一限制是macOS内存管理策略的一部分,并非硬件缺陷,但确实构成了本地大模型部署时容易被忽视的软件门槛。
双DGX Spark:CUDA兼容性与最快预填充
单台Spark 128GB,两台用200Gb线缆相连构成256GB方案。NVIDIA官方定价每台6,950美元,比发布时的3,999美元涨了将近一倍,两台合计13,900美元,而且各大渠道都缺货。
每台Spark让GPU使用约121GB,两台约260GB可用,能过3-bit线并给上下文留出空间。社区已经摸索出2.9-bit构建,跨两台占用约196GB。据Mia AI Lab的测量,预填充约2,100 tokens/s,在128K上下文长度下也能基本保持;但128K提示词的首次等待约63秒。写入方面单台带宽273GB/s,有用户实测无draft模型时31 tokens/s,开启DeepSeek的DraftHead后代码场景87、结构化输出131 tokens/s。
需要注意的坑:引擎占用超过约92%内存会崩溃,最后几GB实际上用不了;三台Spark对这个模型来说切分形状很别扭,认真跑的人都直接上四台,那就需要交换机或环形组网,等于把数据中心那套搬进书房。
Strix Halo双机:社区分歧最大的一条路
AMD Ryzen AI Max Plus 395(Strix Halo)单机128GB,Framework桌面版3,449美元,Minisforum MS-S1 Max促销3,639美元(原价4,549),GMK Tech Evo X2约3,650美元。两台大约6,900到7,800美元,比Mac便宜,而且是两台能各干各活的机器。
但论坛对这条路的效果存在明显分歧。Windows下GPU默认96GB,新驱动更新后可到约110GB,两台给GPU 192-220GB,属于2-bit级别。Linux下通过内核设置每台可推到约120GB,纸面上刚好过3-bit线,但实际尝试过的用户描述模型加载后几乎不剩空间,过程中还有几次崩溃。机器之间的USB4标称40或80Gbps,有用户实测40Gbps链路只跑出约9.2Gbps。有引擎开发者在双机上跑DeepSeek,写入约27 tokens/s,预填充700-750 tokens/s;也有开发者分析第二台机器只带来短提示下约23%的写入提升,全新长提示读取反而慢13%。
值得关注的是AMD更新的Gorgon Halo芯片,单机192GB,Minisforum版本7,399美元,已有用户在其上完整内存运行2-bit DeepSeek。另外有开发者在一台128GB Strix Halo上跑1-bit构建,预填充1,000 tokens/s、写入23-28 tokens/s,代价是Unsloth的1-bit构建大约每8到9个token错一次。
RTX 3090加DDR4服务器内存:最被低估的路线
这是UP主说"最让他惊讶"的方案,也是他认为几乎没人在256GB讨论里算过账的路线。DeepSeek每个token只用到5520亿参数中的约160亿,而且不同token激活的是不同切片。新引擎的思路是把每个token都会用到的"热"部分放在GPU上,其余放在便宜得多的普通服务器内存里。
开发者0x0做了这个构建:一张RTX 3090(2020年发布的24GB卡),配256GB DDR4内存和200GB SSD,跑DeepSeek v4.1 Flash单用户26 tokens/s、四用户并发41 tokens/s,预填充600-800 tokens/s,支持262K上下文,构建者估算总成本约6,000美元。
真正的关键在于内存价格差。DDR5服务器内存被AI基建需求大量消耗,最便宜的报价约每GB 29.37美元;而2019年前后AMD EPYC服务器主板用的64GB DDR4条全新399美元,折合每GB 6.23美元,便宜近五倍。256GB DDR5要约7,500美元,几乎是一台Mac Studio的价格;DDR4只要约1,600美元。这也让4-bit在这里成为唯一负担得起的升级:再加两根64GB条花798美元,如果主板有空槽,就能达到4-bit所需的约300GB。目前还没有人公开发布过这个确切构建,但路径存在,价格真实。
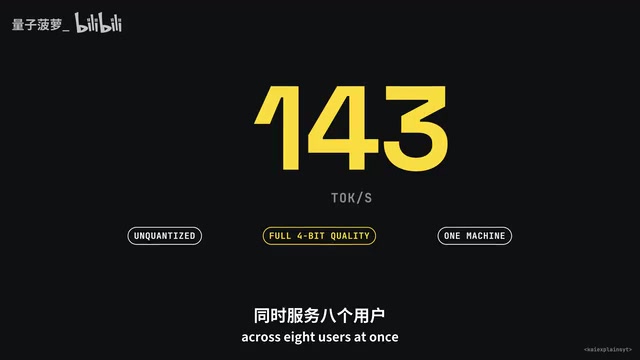
更极端的验证是:有开发者在一张96GB RTX Pro 6000加512GB DDR4上跑了完全未量化的DeepSeek,用掉显卡89GB、内存346GB,单用户65 tokens/s、八用户143 tokens/s。代价是旧服务器的一切——比Mac吵、软件分支每周都在变、干的都是服务器的事而不是消费级的事。
MoE(混合专家)架构是DeepSeek系列模型的核心设计。以DeepSeek v4.1 Flash为例,总参数5520亿,但每个token只激活其中约160亿参数,即路由网络根据输入动态选择少数“专家”子网络参与计算。这种稀疏激活机制使得模型的实际计算量和内存带宽需求远低于总参数量所暗示的水平。然而,所有专家的权重仍需存储在某个地方,传统做法是全部放入GPU显存,导致显存需求极高。文中3090加DDR4的方案正是利用了MoE的稀疏性:将频繁激活的“热”专家留在GPU显存,冷门专家放在普通DDR4内存中,按需通过PCIe加载。由于每个token只触碰少量专家,PCIe带宽压力可控,从而用极低成本的服务器内存替代了昂贵的高速显存。
八卡堆叠:纸面最强,现实最贵
八张32GB显卡装进一台机器,真实VRAM、无USB、无第二台机器。问题是卡价。AMD Radeon AI Pro R9700发布价1,299美元,有人在Micro Center看到卖1,680至1,700美元;Intel Arc Pro B70发布价949美元,现在1,280至1,700美元。八张任意一款,光卡就要10,240至13,600美元,还不算主板、电源和PCIe转接线。八张RTX 5090按近期转售价格约38,000美元,四张72GB的RTX Pro 5000到288GB约40,000美元。
有一个亮点数据:四张R9700跑Qwen 3.8 Flash在一位用户的基准里达到236 tokens/s。但八卡R9700或八卡B70上的DeepSeek v4.1 Flash数据至今无人发布,等于要花13,000美元买卡却看不到最想看的那个数字。而且八槽占满没有第九张的位置,4-bit不是加798美元内存,而是换整批卡——四张96GB RTX Pro 6000按官方标价每张16,000美元,升级成本64,000美元。
二手V100/MI50:每GB最便宜,软件生态在抛弃它
8卡V100服务器(每卡32GB、NVLink互联)在eBay标价5,899美元,RepoChad发现有一台成交价不到3,000美元,折合每GB约23美元,是整个对比里最便宜的高速内存。但V100是2017年的芯片,CUDA 13已经放弃它,vLLM 0.20也放弃了,变通方案真实存在且有人做出成果——比如四张16GB V100跑Qwen 3.8的4-bit压缩权重,跑到约219 tokens/s,追平单张RTX 5090。但具体到DeepSeek,有人跨三张V100加DDR4跑通,也有V100用户形容"慢得离谱",结果非常分化。
AMD的对应物是MI50,同样32GB、NVLink互联,官方软件也已放弃,但有用户说ROCm社区预览版能在四张卡上跑2-bit DeepSeek,写入50 tokens/s、读取275 tokens/s。两条路的共同代价是服务器的功耗、噪音和散热,一位V100用户警告封闭房间里的服务器温度会超过60度。
被内存算术掩盖的成本:KV缓存与首次预填充
DeepSeek v4.1 Flash的KV缓存约每token 890字节,百万token上下文约0.93GB,在256GB机器上确实可以忽略。真正不免费的是首次处理长上下文——模型写出第一个字之前必须读完整个提示词。Mac上TensorFold处理百万token提示词用了740秒,约12分钟;双Spark上47.9万token提示词280秒,推算百万token约10分钟;Strix Halo双机按实测速度至少23分钟;3090加DDR4构建要22到29分钟。相比之下,DeepSeek官方API处理同样百万token,非高峰时段收15美分。
好消息是引擎会缓存已读内容,同一会话的后续消息只处理新增token。一位Mac用户实测已缓存上下文上新增轮次约350 tokens/s,几千token的新增只花几秒。所以12分钟是一次会话开头的等待,不是每条消息之间。
回到那个数字:第四位的价格
UP主最后给出的框架很清晰——记住的不是GB数,而是"第四位的价格",即从3-bit DeepSeek升到4-bit在每条路线上的代价:3090加DDR4构建是两根内存798美元;Strix Halo双机是一到两台迷你主机,3,639到7,800美元;Mac是跳到512GB版加11,500美元,或者再买一台256GB用雷雳5互联(苹果理论上支持,但没人发布过双M5 Ultra跑DeepSeek v4.1 Flash的数据,而且第二台要等到二月);双Spark再加两台13,900美元外加交换机;八卡堆叠和旧服务器卡没有空槽,只能整批换卡,四张96GB RTX Pro 6000官方价合计64,000美元。而API这一侧,第四位是白送的,因为出厂就是那样。
那台盒子到底值不值
视频里算了一笔诚实的账。9,499美元的256GB Mac Studio,按DeepSeek非高峰输出价能买约158亿输出token。Mac以35 tokens/s全天候运行一年约产出11亿token,回本要14年,还没算电费;开DraftHead推到80 tokens/s约需6年,API高峰价下这两个数字大致减半。租算力也接近:RunPod上两台共282GB的H200约每小时10.58美元,Mac大约900小时使用后打平。
API唯一覆盖不了的买家,是数据必须物理留在自己机器上的人。视频提到一条高赞评论:一位会计师客户的资料不允许上云、不允许调用API。对这个人群,盒子的价格不是可选项,而是工作开展的前提。而当一台机器全天候为团队跑agent时,经济账会完全反转——盒子越忙越划算。
最后的结论没有站队,而是给了分场景建议:需要真正的隐私,就是买盒子,问题只剩买哪台;3-bit够用且希望持续获得软件更新,最便宜的是DDR4构建,6,000美元、单用户26 tokens/s、有清晰的4-bit升级路径;要最省心的维护体验,Mac是答案,一条终端命令之后它安静、能用、会持续获得软件支持;要CUDA兼容和同价位最快的预填充,双Spark是路线,前提是清楚13,900美元买的是3-bit,第四位还要再花13,900;愿意折腾迷你主机栈,Linux下的Strix Halo双机很有意思,而192GB单机的Gorgon Halo值得持续关注。
先选bit,再找能到达那个bit、并且能持续获得软件支持的最便宜盒子。如果这些现在都不值得,API已经以每百万token不到一美元的价格跑着完整的四位模型——有时候不性感的答案就是答案。
相关推荐

Ollama选模型完全指南:从配置到量化避坑
Ollama选模型完全指南:从查看电脑配置到逛官方模型库,详解Tools、Thinking、Vision、Decision等标签含义,以及参数规模、量化精度与上下文缓存的取舍策略,助你避开卡死闪退的坑。

Ollama默认安全吗?显卡被白嫖的真相与自查指南
Ollama 默认只绑回环地址,但改一句环境变量或照抄 Docker 命令就可能让显卡暴露。本文解析显卡被白嫖的原理、扫描规模与 DNS 重绑定路径,并给出自查与修复的三层方案。

Cherry Studio+MCP实战:搭建自动化AI智能体与本地知识库
基于B站Cherry Studio教程,详解如何配置MCP环境、搭建网页抓取与报告生成等自动化AI智能体,并用Ollama+千问3搭建本地知识库,附实际操作中的踩坑经验。