本地运行AI模型全指南:从原理到四种实操方式
拆解本地AI四大核心模块,演示四种从零门槛到纯代码的本地运行方式。
本文系统拆解了本地运行AI的底层逻辑,将其归结为"模型文件+推理引擎"两个本质要素,并逐一讲解模型参数量、量化压缩、推理引擎(llama.cpp)和硬件内存这四个核心模块。文章进一步演示了四种运行方式:面向普通用户的LM Studio桌面应用、开发者首选的Ollama命令行工具、适合部署场景的Docker Model Runner,以及直接调用llama.cpp的纯代码方案。硬件层面,内存容量决定能加载的模型大小,内存速度决定推理吞吐,140亿至350亿参数区间是性能与体验的甜点区。文章最终结论是:本地AI门槛远低于想象,理解底层构建块后,选择适合自己场景的工具即可上手。
很多人都在谈论"本地运行AI",却几乎没人把它说清楚——那些视频里满屏的量化、GGUF、推理引擎术语,让不少人误以为需要博士学位加一台上万美元的机器才能尝试,最终还是乖乖为云端订阅买单。
其实本地AI的核心可以用一句话概括:它就是你电脑上的一个模型文件,加上一个能运行它的程序。 没有云端、没有API密钥、不需要联网、没有订阅,其余一切都是细节。这篇文章会拆解本地AI真正的底层模块,并演示四种从零门槛到纯代码的运行方式。
云端AI与本地AI的本质区别
当你使用ChatGPT、Gemini这类工具时,你输入的消息会离开电脑,通过互联网传到某个数据中心,由一台你并不拥有的巨型计算机运行超大模型,再把答案流式传回来。你的电脑基本没干活,它只是"别人机器的一扇窗户"。
本地AI彻底反转了这个过程:包含全部"智能"的模型文件被下载到你的电脑,提问时是你自己的CPU或GPU在做计算,没有任何数据离开本机。这带来三个实实在在的好处:
- 隐私:数据永远留在本地,不去任何地方
- 免费:没有订阅费,也没有按Token计费的成本
- 离线可用:在飞机上、WiFi糟糕的咖啡店都能跑
代价也要如实说:你在家能跑的模型比Claude、OpenAI那样的前沿模型小很多。但过去几年它们进步惊人,对于大量日常任务甚至编码任务已经绰绰有余。
拆解本地AI的四个核心模块
模型:本质就是一个大文件
模型不是什么魔法黑盒,它就是一个大文件,里面装满了训练时"烘焙"进去的数十亿个权重数字。它不思考、不运行,只是像普通文件一样躺在磁盘上。Meta、Google、阿里巴巴、Mistral等公司会免费发布这些文件,也就是你常听到的Llama、Gemma、Qwen、DeepSeek广告等开源模型。
模型名字里的"B"代表十亿(Billion),指参数数量,也就是文件内部数字的个数。规则很简单:参数越多通常越智能,但文件更大、运行时占用的内存和算力也更多。 一个80亿参数模型可能只有几GB,而770亿参数的文件极大,多数笔记本根本无法加载。
量化:让普通电脑跑得动大模型的关键技巧
量化听起来吓人,其实和压缩照片是一个道理——用更低的精度存储那数十亿个数字,让文件大幅缩小而质量几乎无损。一个原本需要60GB内存的模型,量化后可能只要5、6、7GB。
当你看到 GGUF 这个词,它基本就是这些压缩模型的标准文件格式。所以听到"量化模型"时,把它理解成"为了更好运行而压缩过的模型"就对了。量化级别用Q4、Q6、Q8等标注,数字越低压缩越狠、文件越小,Q8会明显比Q4大得多。
量化的原理是将模型权重从高精度浮点数(如32位或16位浮点,即FP32/FP16)降低到更少位数的整数表示(如8位、4位甚至更低)。以Q4为例,每个权重只用4个比特存储,相比FP16节省了约75%的空间。这种精度损失在实际使用中对绝大多数任务影响极小,人类几乎察觉不到回复质量的下降,但内存占用却能缩小到原来的四分之一甚至更少。
GGUF格式由llama.cpp项目定义,已成为本地模型分发的事实标准。它的一大优点是支持"部分GPU卸载"——当显存不足以装下整个模型时,可以把部分层放在显存里、剩余层放在系统内存里运行,只是速度会有所下降。Hugging Face等平台上发布的模型文件名通常直接注明量化级别,比如 model-Q4_K_M.gguf,其中 K_M 代表具体的量化算法变体,_M 表示"中等质量",是在文件大小和精度之间较均衡的选择。
推理引擎:让文件真正跑起来的程序
模型只是充满数字的文件,文件自己不会运行。你需要一个程序把这些数字加载进内存、进行实际计算、预测下一个词元——这个程序就是推理引擎。目前最著名的是 llama.cpp。
这里有个关键秘密:后面要演示的LM Studio、Ollama、Docker Model Runner这些工具,本质上大多都是这类引擎的封装。引擎干活,工具只是让使用更方便。
llama.cpp 由开发者 Georgi Gerganov 于2023年初发布,最初仅为在苹果M1芯片上运行Meta的Llama模型而编写,代码用纯C/C++实现,不依赖任何深度学习框架。这个设计让它极其轻量,能在几乎所有平台运行,包括Windows、macOS、Linux,甚至树莓派和安卓设备。它通过调用CPU的SIMD指令集(如AVX2)以及各平台的GPU加速接口(CUDA、Metal、Vulkan等)充分压榨硬件性能。
正是因为llama.cpp的广泛底层支持,LM Studio、Ollama等上层工具才得以快速崛起——它们并不需要自己实现复杂的矩阵运算,只需在llama.cpp之上构建易用的界面和API。这也意味着这些工具在性能上通常相差不大,选择它们的理由主要是用户体验和生态整合,而非运算效率本身。
硬件:内存容量和速度决定一切
真正决定你能跑什么模型的,只有一个问题:你的电脑有多少内存,以及这些内存有多快。
- 带独立显卡的PC看显存(VRAM),比如NVIDIA的RTX系列
- 现代Mac(M系列)由于统一内存架构,看的是整机内存容量
经验法则很简单——模型文件必须能装进内存并留有余量:
| 内存 | 可运行参数量 |
|---|---|
| 8GB | 30-40亿 |
| 16GB | 70-80亿 |
| 32GB | 140-300亿 |
还要注意内存速度。128GB统一内存的Mac虽然能跑更大的模型,但推理速度会比专用GPU慢得多。作者的RTX 4090有24GB显存,运行某些模型能达到每秒200个Token;同样的大模型在Mac上就慢得多,因为内存带宽显著较低。内存容量决定模型大小,内存速度决定每秒Token数。 140亿到350亿参数区间通常是性能与体验俱佳的"甜点区"。
四种运行本地模型的方式
不管用哪种方式,你都要做三个决定:选哪个模型、选适合内存的大小和量化级别、以及决定交互方式(聊天还是代码)。 记住这点,所有工具就都讲得通了。作者按控制程度由高到低分为四层。
LM Studio:最简单的桌面应用
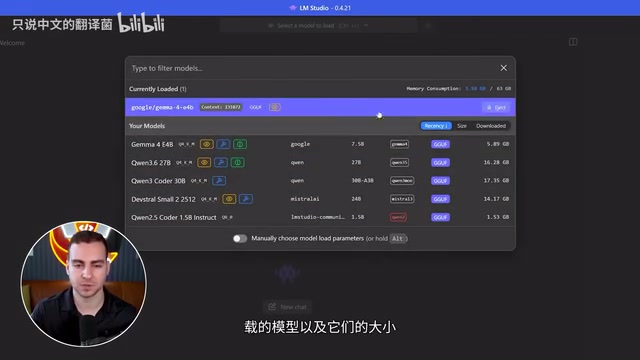
如果你只想聊天、不碰终端,LM Studio是最佳选择之一。下载免费,界面里可以直接搜索并下载模型,还会根据你的硬件给出提示,标注哪个量化级别适合你、能否全GPU卸载。
加载模型后即可在聊天窗口对话。有一项设置要注意——上下文大小,设得越大占用的内存越多,因为所有上下文数据都要放进GPU显存。作者演示中运行小尺寸的Gemma模型,凭借专用GPU的高带宽,每秒能生成约120个Token。它还能同时加载多个模型,并以服务器形式暴露API供开发调用。
Ollama:开发者最爱的命令行方案
Ollama在开发者中更受欢迎,功能与LM Studio类似但可视化更弱、控制更少。安装后它作为终端命令可用:ollama list 查看已下载模型,ollama pull 模型ID 拉取,ollama run 模型ID 运行并直接对话。模型仓库在Ollama Hub,可以搜索心仪模型再拉取。
关键在于Ollama会在后台默认端口(约11434)暴露一个 OpenAI兼容API,只要它在运行,其他工具就能以与调用ChatGPT相同的格式发送请求,且会自动加载所需模型。这也是作者本人最常用的方案。
OpenAI兼容API指的是Ollama对外暴露的HTTP接口与OpenAI官方API的请求和响应格式保持一致,包括 /v1/chat/completions 等端点结构、消息格式(role/content 字段)以及流式响应的SSE格式。这意味着任何已经支持OpenAI SDK的应用或代码库,只需将 base_url 从 https://api.openai.com 改为 http://localhost:11434、并将API密钥设为任意字符串(Ollama不校验),即可无缝切换到本地模型运行,无需修改业务逻辑。这种设计极大降低了从云端迁移到本地的成本,也让LangChain、LlamaIndex等主流AI应用框架天然兼容Ollama。
Docker Model Runner:把模型当容器
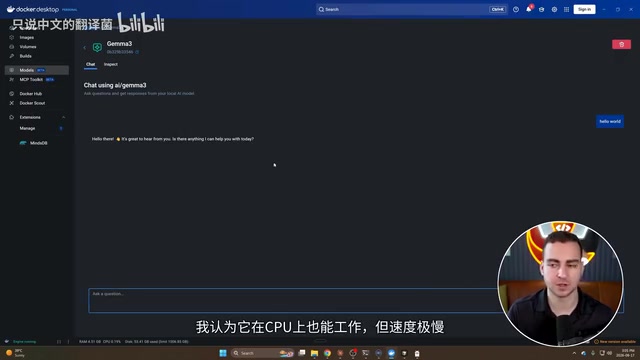
Docker Model Runner目前作为Docker Desktop的实验性功能提供,在Linux加NVIDIA硬件上表现很好(CPU也能跑但极慢)。启用后可从Docker Hub拉取模型直接对话,同样会暴露REST API(端口约12434)。
它最有意思的地方在于把模型视为容器——你可以写Dockerfile、Compose文件,让模型随应用一起分发并作为依赖暴露。如果你本就生活在Docker生态里、要做部署,这是非常好的生产环境方案。
纯代码:自己引入推理引擎
最底层的方式是只用代码运行模型,自己引入推理引擎——通常就是 llama.cpp(也正是前面几乎所有工具背后的引擎)。作者在本地下载了一个Qwen模型文件,用几行Python加载并生成响应。除了直接调用,代码也可以对接已运行的Ollama后端服务,指定已下载的模型进行对话。
多数开发者的实际做法是:用Ollama管理和托管模型,再在代码里通过API调用它,而不是每次都手动加载。
到底该用哪一种?
作者给出的选择建议清晰实用:
- 只想聊天、不看终端 → LM Studio,最简单、功能最全
- 开发者需要脚本或应用与模型通信 → Ollama,本地运行表现优秀
- 已经在用Docker、要做部署 → Docker Model Runner,生产环境可靠
- 想理解每一个环节、追求最高效率 → 纯代码 + llama.cpp
无论用哪种,它们最终都建立在相同的构建块上:一个模型文件(一堆数字)、一个推理引擎,再加上层层封装的花哨功能。理解了这一点,你就理解了本地AI——它从来不需要博士学位,也不需要上万美元的机器。
相关推荐
Vibe Coding实战:培养产品思维,用AI把日常需求变成能变现的APP
Vibe Coding系列教程第二篇,讲解独立开发者如何培养产品思维、从模仿与生活痛点中发现需求,并用AI Agent自动化调研流程,快速判断一个APP创意是否值得投入开发与变现。
OpenAI Codex 上手指南:用AI代理构建并部署应用
OpenAI Codex 速成课中文整理:从安装、价格套餐、插件与自动化,到 Plan/Go 命令、技能系统,并实战演示用声控 Flappy Bird 游戏走通构建与部署全流程,帮你真正上手这款自主 AI 编码代理。
ICLR投稿量突破5万:AI顶会为何持续爆炸式增长
ICLR 投稿编号逼近 5.1 万引发 Reddit 热议。本文分析 AI 顶会投稿量爆炸式增长的原因、对评审系统的压力,以及数字背后的行业信号与反思。