Block推出Dessa AI模型:像笨拙新朋友一样对话
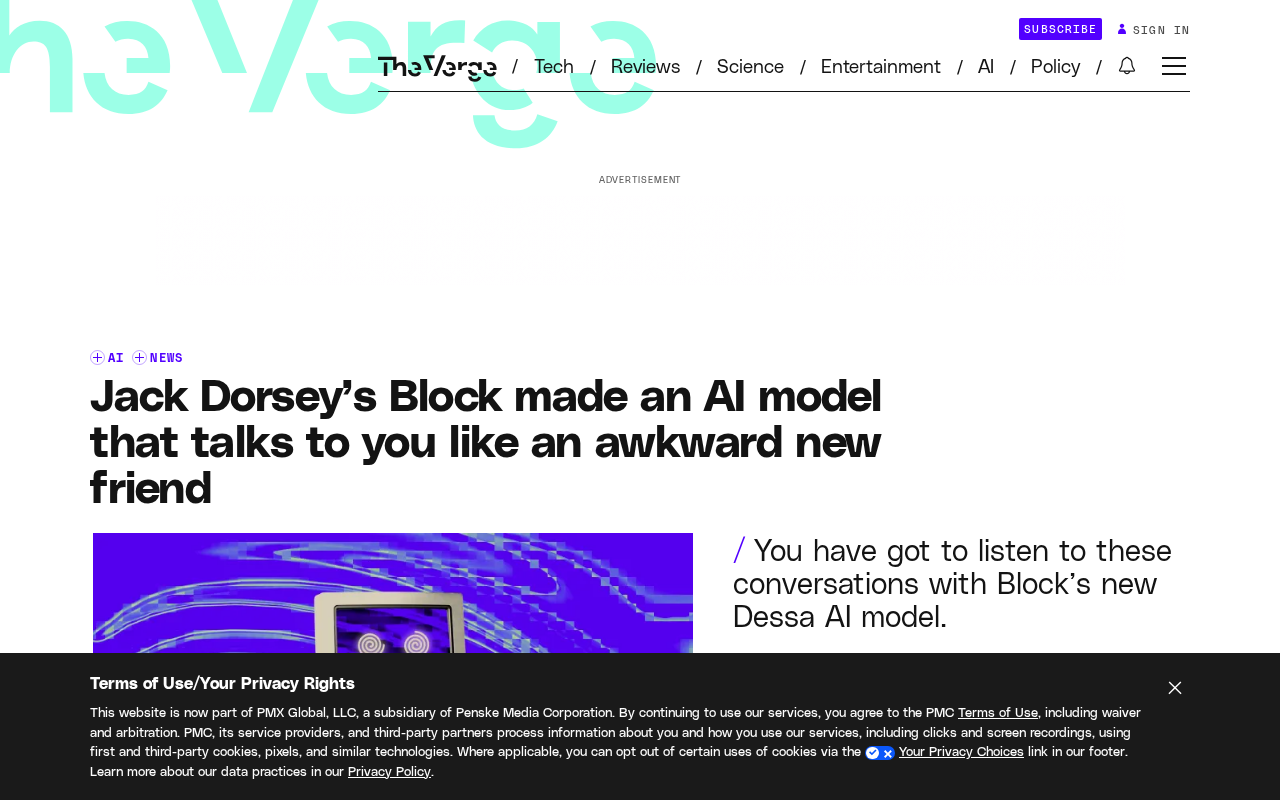
Block推出纯对话数据从零训练的Dessa模型,定位社交陪伴而非通用助手。
Block发布了AI模型Dessa,其最大特点是完全基于人类对话数据从零训练,不依赖网页文本、书籍或代码,也不基于现有开源模型微调。官方展示的对话显示,Dessa回应自然但偶尔笨拙,呈现出“新朋友”式的交流风格。这种路径旨在让模型专注社交语用,如轮次转换和情感回应,同时规避互联网文本带来的版权与偏见问题,但代价是知识广度受限,事实性问答能力可能较弱。Block未公布模型参数量和训练数据规模,应用场景尚不明确。Dessa更像一次社交实验,探索当AI只学会聊天时能走多远,而非追求生产力工具的全能表现。
Block(由Jack Dorsey领导)最近发布了一款名为Dessa的AI模型,它号称“完全基于人类对话数据从零训练”,目标不是成为无所不知的助手,而是模拟一种更自然、甚至有点笨拙的社交对话体验。官方分享的聊天记录显示,Dessa的回应时而亲切、时而略显尴尬,呈现出一种“新朋友”式的交流风格。
从零训练:Dessa的技术路径
与主流大模型依赖海量网页文本、书籍和代码不同,Dessa的训练数据仅包含人类对话。据Dessa负责人Ragavan Thurairatnam介绍,这种“纯对话”训练方式旨在让模型更专注于社交语用——比如轮次转换、情感回应和日常话题的延续。Block并未公布模型参数量、训练数据规模等细节,但强调“从零开始”意味着不基于现有开源模型微调,而是独立构建。
这种路径的潜在优势在于减少对互联网文本的依赖,从而规避部分版权和偏见问题。但挑战也很明显:缺乏广泛知识,模型在事实性问答上可能表现较弱。Block似乎并不追求通用能力,而是将Dessa定位为“对话陪伴”或“社交模拟”工具。
“从零训练”与“微调”是当前构建大语言模型的两种主要路径。微调指在已有预训练模型(如Llama、GPT系列)基础上,用特定领域数据继续训练,以较低成本获得领域能力;而从零训练(from scratch)意味着模型的架构、参数和训练数据全部从头构建,不继承任何现有模型的权重。从零训练的优势是数据来源、模型行为完全可控,便于规避版权与偏见风险;代价是算力成本极高、周期长,且需要自行解决分词器、优化器、分布式训练等工程问题。Block强调Dessa“从零开始”,意在突出其独立性与数据纯净度,但也意味着该模型难以借助开源社区的规模效应快速迭代。
对话风格:有意为之的笨拙感
Block分享的示例对话中,Dessa的回复有时显得过于字面化或缺乏上下文衔接,例如在对方表达情绪时给出略显机械的安慰。这种“awkward”特质被官方描述为“像和一个新朋友聊天”,带有探索性和不确定性。
从产品角度看,这种风格可能降低用户对AI“完美助手”的预期,转而营造一种更轻松、低压力的互动氛围。但也可能让部分用户感到困惑——毕竟多数AI产品都在追求流畅和准确。Dessa的定位更接近社交实验,而非生产力工具。
“轮次转换”(turn-taking)是对话系统研究中的核心概念,指对话参与者交替发言、判断何时该自己说话、何时该倾听的机制。在人类对话中,轮次转换依赖语调、停顿、眼神等线索,自然且几乎无意识;而在文本对话模型中,它体现为模型需要判断用户是否说完、自己该回复多长、如何接续话题而不抢话或冷场。纯对话数据训练能让模型更密集地接触这种交替模式,从而学习到更自然的回应节奏。与之相对,以网页文本为主训练的模型更擅长单轮问答或长文生成,却可能在多轮闲聊中出现“答非所问”或“过度输出”的问题。Dessa的“笨拙感”部分正源于轮次转换策略尚未完全成熟。
行业背景:对话AI的另类探索
Block并非第一家尝试“纯对话”模型的公司。此前已有研究关注用对话数据训练社交智能体,但多数仍混合其他语料。Dessa的独特之处在于完全舍弃非对话数据,这使其在知识广度上天然受限,却可能在对话自然度上获得优势。
目前Dessa的公开信息有限,Block未说明其应用场景和开放计划。但可以推测,该模型可能用于Block内部的社交产品实验,或作为研究项目探索对话AI的边界。对于关注AI交互体验的开发者而言,Dessa提供了一个值得观察的样本:当模型只学会“聊天”,它能走多远?
社交智能体(social agent)是对话AI的一个研究方向,目标是让AI具备社交语用能力,包括理解情感、维持话题、遵守社交规范等。早期代表性工作包括Facebook AI的PersonaChat数据集和BlenderBot系列,它们通过混合对话数据与通用语料来平衡社交能力与知识广度。另一类研究则使用强化学习或人类反馈来优化对话的自然度。Dessa的差异在于彻底放弃非对话语料,这使其在社交语用上可能更聚焦,但也意味着它无法像混合训练模型那样在事实性问答中调用广泛知识。这一取舍反映了对话AI领域的一个根本张力:知识广度与社交自然度往往难以兼得,而产品定位决定了优先项。
小结
Block的Dessa模型选择了一条不同于主流大模型的路径——专注人类对话,接受笨拙感,不追求全能。这种实验性探索能否转化为实际产品价值,尚待时间验证,但它提醒我们:AI对话不一定非要像专家,也可以像朋友。
相关推荐

64G内存笔记本跑大模型,实际可用仅46.7G
华硕ProArt创16实测:64G内存标称值下模型可用仅46.7G,128G版官方上限1200亿参数。本文拆解9000元内存差价、统一内存占用真相、续航表现,并给出三步自查方法,帮你判断本地跑大模型该买多大内存。
Ollama零基础教程:本地部署大模型入门指南
Ollama零基础入门教程:了解Ollama是什么、核心特点与本地部署大模型的价值。涵盖开源免费、跨平台、CPU/GPU调度、API集成等关键信息,助你快速上手本地大模型管理工具。

LangGraph 实战:开发者真实工作流与技术栈剖析
从 Reddit 开发者提问切入,剖析 LangGraph 在实际生产中的工作流设计、技术栈组合、图结构模式与调试痛点,总结从教程走向落地的关键实践与可观测性需求。