布局感知PDF解析器实战:破解RAG分块难题
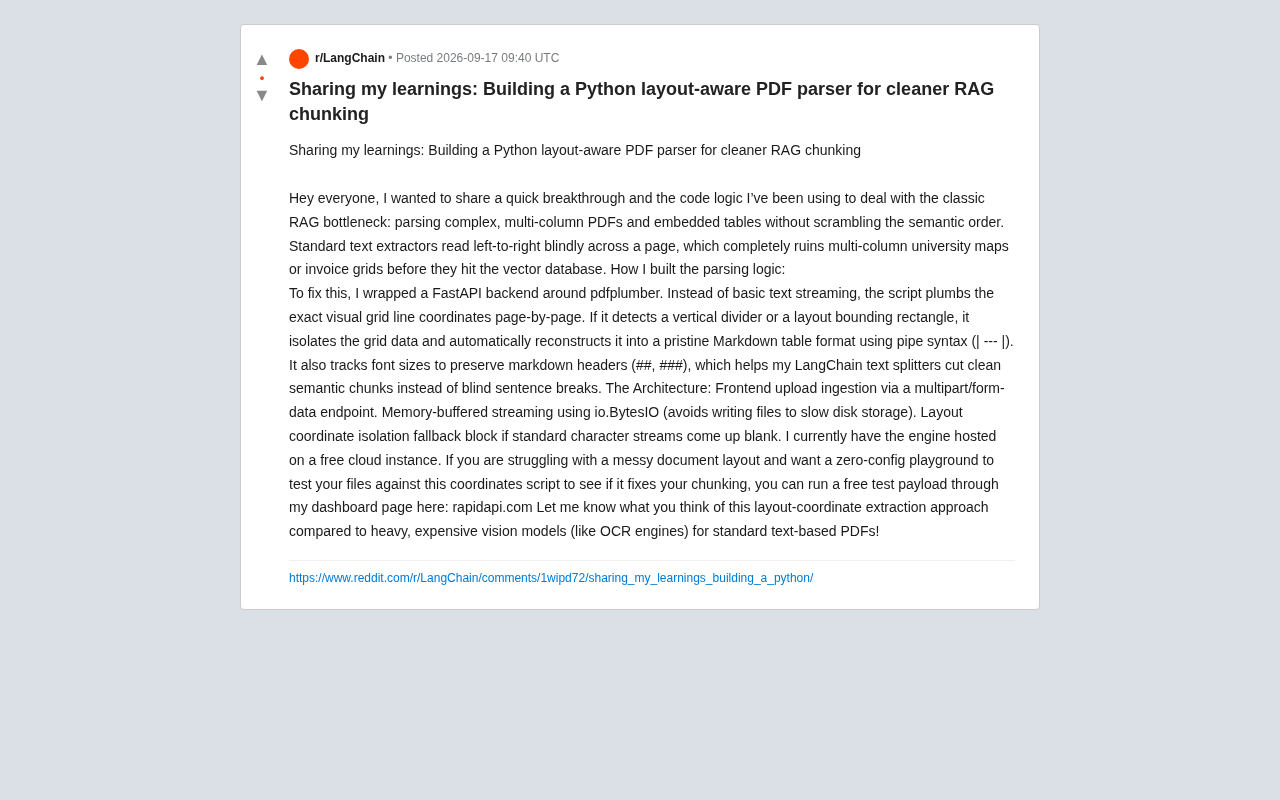
用pdfplumber坐标探测重建多栏PDF布局,低成本解决RAG数据入库前的语义错乱问题。
这篇文章介绍了一位开发者为RAG系统构建的轻量级布局感知PDF解析器。标准文本提取器按左右顺序盲目拼接字符,会将多栏排版和表格内容的语义顺序彻底打乱,导致向量化质量低下——这是RAG系统中常被忽视的隐形瓶颈。该方案以pdfplumber为核心,通过逐页探测视觉网格线坐标识别表格结构,将其重建为Markdown管道格式,同时追踪字体大小还原标题层级,从而让LangChain等分割器实现语义级切分。工程上采用FastAPI接收文件、io.BytesIO内存流处理避免磁盘I/O,并设有字符流为空时触发坐标隔离的兜底机制。文章最后指出,对数字原生PDF而言,坐标提取比重型OCR/视觉模型更高效低成本,RAG质量的竞争往往在数据进入向量库之前就已经决定。
在检索增强生成(RAG)系统落地过程中,PDF解析往往是被低估却极为关键的一环。一位开发者在Reddit上分享了他构建的Python布局感知PDF解析器,专门解决多栏排版和嵌入式表格导致的语义错乱问题。本文梳理其技术思路与架构设计,并探讨这种基于坐标的轻量方案与重型视觉模型之间的取舍。
RAG的隐形瓶颈:PDF解析
多数RAG项目把注意力放在向量数据库选型和检索策略上,却忽视了数据入库前的解析质量。问题的根源在于标准文本提取器的工作方式——它们只会盲目地从左到右、从上到下读取整页文本。
对于单栏简单文档,这种方式尚可应付。但一旦遇到多栏排版的大学课程表、发票网格或复杂的财报表格,麻烦就来了。原作者形象地指出,标准提取器会"在文本进入向量数据库之前就彻底打乱多栏文档或发票网格的语义顺序"。想象一张两栏表格,提取器把左栏第一行和右栏第一行拼在一起,语义关系瞬间崩塌,后续的检索质量自然无从谈起。
换句话说,垃圾进、垃圾出。如果分块(chunking)阶段拿到的就是错乱的文本,再强大的嵌入模型和检索算法也难以挽回。
从技术层面看,主流的PDF文本提取库(如PyMuPDF、pdfminer)在处理多栏布局时问题的根源在于PDF格式本身的设计:PDF规范中并不存在"栏"这一概念,文字对象只是按绝对坐标散布在页面上。标准提取器通常按照Y轴从上到下、X轴从左到右的顺序对文字对象排序后拼接,这对单栏文档天然有效,但遇到两栏并排的内容时,提取器会把左栏第一行(X坐标较小)和右栏第一行(X坐标较大)的文字混排在一起,而不是先读完左栏再读右栏。RAG系统中的嵌入模型对输入文本的顺序高度敏感,乱序文本产生的向量表示会偏离原始语义,直接导致召回结果与用户问题之间的语义距离计算失准。
核心思路:从字符流到坐标网格
原作者的解决方案并没有依赖昂贵的OCR或视觉大模型,而是选择了一条更轻量的路径——基于视觉坐标的布局重建。
技术栈上,他在 pdfplumber 外层包裹了一个 FastAPI 后端。关键区别在于:脚本不再进行基础的文本流式读取,而是逐页探测精确的视觉网格线坐标。
具体逻辑分几步走:
- 检测布局分隔线:当脚本识别到垂直分隔线或布局边界矩形时,判定这里存在表格结构。
- 隔离与重建表格:将网格数据单独提取出来,自动重构为规范的 Markdown 表格格式,使用管道语法(
| --- |)呈现。 - 保留标题层级:通过追踪字体大小,还原 Markdown 标题(
##、###),让文档的结构层次得以保留。
这一步对下游至关重要。原作者提到,保留标题结构后,他的 LangChain 文本分割器能够按照语义边界进行"干净的切割",而不是简单地在句子处盲目断开。对RAG而言,这意味着每个chunk都更接近一个完整的语义单元。
pdfplumber 是基于 pdfminer.six 构建的高层封装库,其核心优势在于将PDF页面中的每一个字符、矩形、线条对象都暴露为带有精确坐标属性(x0、y0、x1、y1)的Python对象,而不仅仅是拼接后的字符串。正是这种坐标级别的访问能力,使得检测垂直分隔线、判断文字是否落在某个矩形区域内成为可能。与 PyMuPDF(fitz)相比,pdfplumber 在表格边线检测方面提供了更高层的抽象(page.find_tables()),可以通过配置边线识别策略(显式线条、文字对齐边界等)来适配不同的表格样式,减少手动坐标计算的工作量。
架构设计中的工程细节
除了核心解析逻辑,这套系统在工程实现上也有几处值得借鉴的考量。
文件摄取方式:前端通过 multipart/form-data 端点上传文件,符合标准的文件传输规范。
内存缓冲流处理:使用 io.BytesIO 进行内存缓冲流式处理,避免将文件写入速度较慢的磁盘存储。对于需要处理大量文档的解析服务来说,绕开磁盘I/O能显著提升吞吐效率,也减少了临时文件清理的负担。
兜底机制:当标准字符流返回空白时,触发布局坐标隔离的降级方案。这种 fallback 设计体现了对真实场景的考量——不是所有PDF都规规矩矩,有些页面标准提取会直接失败,此时坐标级别的解析就成了最后的保障。
目前该引擎部署在一个免费云实例上,作者也在 RapidAPI 上提供了零配置的测试入口,供有类似痛点的开发者上传自己的文档验证效果。
坐标提取 vs 视觉模型:如何取舍
这套方案抛出了一个值得讨论的问题:对于以文本为主的PDF,基于布局坐标的提取是否比重型视觉模型更划算?
视觉模型(如OCR引擎)的优势在于通用性强,能处理扫描件、图片型PDF乃至手写内容。但代价也很明显——计算成本高、延迟大、部署复杂,对于本身就是数字原生、包含可提取文本层的PDF而言,动用视觉模型有些"杀鸡用牛刀"。
坐标提取方案则针对性地解决了标准文本PDF的排版错乱问题,成本低、速度快、可在轻量实例上运行。它的局限同样清晰:面对纯图像扫描件或没有清晰网格线的复杂版式,坐标探测会力不从心。
实践中的合理策略或许是分层处理:优先用坐标级解析处理数字原生PDF,当字符流为空时再降级到OCR或视觉模型。原作者的 fallback 设计其实已经隐含了这种思路,只是把视觉模型环节换成了坐标隔离。
在工程选型中,"数字原生PDF"与"图像型PDF"是决策的核心分叉点。数字原生PDF(由Word、LaTeX、InDesign等软件直接导出)内部包含可寻址的文本层,字符坐标信息完整,坐标提取方案完全适用。图像型PDF通常来源于扫描仪或打印后再拍照,页面内容本质上是位图,没有文本层,必须借助OCR(Optical Character Recognition,光学字符识别)引擎(如Tesseract、PaddleOCR、或云端的Google Document AI)先将图像转为文字再处理。判断一个PDF是否包含文本层,最简单的方法是尝试用任意PDF库提取文本:若返回空字符串或乱码,基本可以确认是图像型PDF,需要走OCR流程。实际企业文档库中两类PDF往往混杂,因此分层处理策略(先尝试坐标提取,失败则降级OCR)是兼顾成本与覆盖率的务实选择。
对RAG开发者的启示
这个案例的价值不在于某个具体工具,而在于它提醒开发者:RAG的质量竞争往往在数据进入向量库之前就已经决定。
与其在检索端反复调参,不如回头审视解析和分块环节是否忠实保留了文档的原始语义结构。表格是否被重建为可读格式?标题层级是否得以保留?多栏内容是否按正确顺序拼接?这些看似琐碎的细节,恰恰决定了RAG系统的上限。
对于正在被混乱文档布局困扰的团队,这种以 pdfplumber 坐标探测为核心、以 Markdown 结构化输出为目标的轻量方案,提供了一个值得尝试的低成本起点。
相关推荐
Comp AI获3400万美元A轮融资,押注智能体化安全合规
网络安全合规创业公司Comp AI宣布完成3400万美元A轮融资,由Roo Capital和Grand Ventures领投,押注「持续智能体化」的安全与合规自动化未来。本文解析其技术愿景与市场竞争格局。
vLLM v0.30.0rc1发布:修复FlashInfer BF16自动调优隔离问题
vLLM 发布 v0.30.0rc1 候选版本,核心修复为隔离 FlashInfer BF16 自动调优逻辑(PR #57285)。本文解读该修复的技术背景、FlashInfer 与 BF16 调优机制及对推理部署的实际影响。
MIT科技评论:35岁以下气候科技创新者名单解读
《麻省理工科技评论》最新一期「35岁以下创新者」榜单聚焦气候科技,收录全球九位年轻研究者与发明家,解读这份名单的背景、意义与对气候科技未来的启示。