B站超细RAG企业知识库搭建教程:四阶段从入门到实战

拆解B站RAG企业知识库四阶段学习路线,评估其适用性与工程缺口。
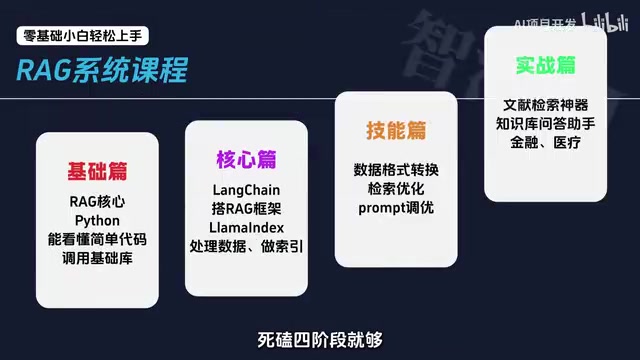
文章基于B站一套被称为“最全最细”的RAG企业知识库搭建教程,拆解其四阶段学习路线:第一阶段理解RAG核心逻辑并掌握基础Python;第二阶段学会LangChain与LlamaIndex两个核心工具;第三阶段对标岗位需求,练习数据格式转换、检索优化与Chunk调优;第四阶段通过文献检索神器和职场知识问答助手两个实战项目检验成果。作者肯定了该路线将庞杂知识压缩为可执行顺序的价值,同时提醒这是一条面向入门与基础岗位的路线,真实企业知识库还涉及文档权限、更新同步、评测体系等工程问题,需在学完后继续补课。
企业数据安全与内部文档散乱难找,是很多团队落地AI时遇到的第一道坎。金融、医疗、客服等行业已经开始用RAG(检索增强生成)搭建私有知识库来解决这类问题。B站上有一套被观众称为“最全最细”的RAG企业知识库搭建教程,主打零基础、不啃论文、每天一到两小时,死磕四个阶段即可独立搭建私有知识库。本文基于该教程的路线设计,拆解每个阶段的目标、工具与练习方法,并补充一些实操层面的判断,帮你判断这条路线是否适合自己。
第一阶段:打基础,理解RAG到底在做什么
教程把入门底线定得很明确:先搞懂RAG的核心逻辑——把自己的外部数据喂给大模型,让它基于这些数据给出专属答案,而不是通用内容。这个定义看似简单,却决定了后续所有工作的方向:RAG不是训练模型,而是给模型外挂一个可检索的知识源。
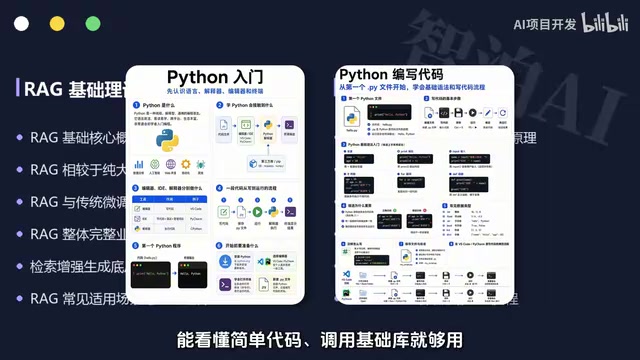
配套的技能要求是基础Python,不用学太深,能看懂简单代码、会用基础库就够。教程在这里特意提醒“别偷懒”,因为后面LangChain和LlamaIndex的示例代码都建立在Python读写能力之上。对于完全没有编程经验的读者,这一阶段可能需要比“一到两小时”更长的适应期,但门槛确实不高。
RAG与模型微调的区别:RAG(检索增强生成)和微调(Fine-tuning)是让大模型使用私有数据的两种主流路径,理解两者的差异有助于明确学习方向。微调是通过额外训练把知识“写进”模型参数,成本高、周期长,且知识更新时需要重新训练;而RAG是在推理时动态检索外部知识库,把相关片段作为上下文喂给模型,知识更新只需更新文档库,无需改动模型本身。RAG的优势在于可溯源(能给出引用来源)、易更新、成本低,劣势是效果高度依赖检索质量。对于企业内部文档频繁变动的场景,RAG通常是更务实的选择,这也是教程将其作为切入点的原因。
第二阶段:吃透LangChain与LlamaIndex两个核心工具
这一阶段的重点是两个做RAG的“神器”:LangChain和LlamaIndex。教程给新手的定位很务实——不用懂底层原理,先会用就好。分工上,LangChain负责搭RAG框架,LlamaIndex负责处理数据、做索引。
跟教程练三到五遍,基本就能上手。这个“练几遍”的建议值得重视:RAG工具链的坑大多不在概念,而在配置和接口调用细节,重复练习能把这些细节变成肌肉记忆。需要提醒的是,两个框架迭代都很快,学习时优先关注官方文档中当前版本的写法,避免照抄过时的示例。
Chunk(文本切块)的基本概念:Chunk指将长文档切分成适合检索和输入大模型的小段文本。切块粒度直接影响RAG效果:块太大,检索时容易混入无关信息、超出模型上下文窗口;块太小,则可能丢失上下文、语义不完整。常见策略包括按固定字符数切分并设置重叠(overlap)、按段落或标题等语义边界切分,以及针对表格、代码等特殊格式单独处理。教程第三阶段将Chunk调优列为核心技能,正是因为不同问答场景(如条款查询与摘要问答)对切块粒度的要求不同,需要通过实验找到平衡点。
第三阶段:对标岗位需求,练三项核心技能
教程把这一阶段直接对标AI岗位需求,列出三个重点:数据格式转换、检索优化、Chunk(教程中写作Trunked)调优。这三项恰好覆盖了RAG效果好坏的关键环节——数据能不能顺利进入流水线、检索能不能召回正确片段、切块粒度是否匹配问答场景。
练习方式是每天练一到两个小案例,慢慢找感觉。这种小步高频的节奏比集中啃大项目更适合新手,因为RAG的调优高度依赖对具体数据的直觉,而直觉只能靠案例量堆出来。
检索优化中的向量检索与重排序:检索优化的核心是让系统从知识库中召回最相关的片段。常见做法是向量检索:用嵌入模型(Embedding Model)把文本转成向量,再按语义相似度查找。但单纯向量检索在关键词精确匹配、专有名词等场景下可能失灵,因此实践中常采用混合检索(向量检索+关键词检索)提升召回率。召回多个候选片段后,还会用重排序模型(Reranker)对结果重新打分排序,把最相关的片段排在前面。理解这一流程有助于在第三阶段练习时判断问题出在嵌入模型、检索策略还是重排序环节。
第四阶段:用两三个实战项目检验成果
教程强调“别光看不动手”,做两到三个简单项目才算真学会,并给出两个方向:文献检索神器、职场知识库问答助手。做完这两个项目,就能应对大部分RAG基础工作。
从企业落地的角度看,这两个项目选得比较有代表性:文献检索偏重长文档切分与引用溯源,职场问答偏重多格式文档入库与权限边界,正好对应私有知识库最常见的两类需求。
这条路线适合谁,需要注意什么
四阶段路线的最大价值在于把庞杂的RAG知识压缩成一条可执行的顺序:先理解目标,再掌握工具,然后练关键技能,最后用项目收尾。每天一到两小时、不偷懒不放弃,是教程反复强调的节奏。
需要冷静看待的是,这是一条面向入门与基础岗位的路线。真实企业知识库还会涉及文档权限、更新同步、评测体系等工程问题,教程并未展开。把它当作起点而非终点,学完后继续在真实数据上迭代,才能把“能搭起来”变成“用得住”。教程末尾也提到,找不到教程案例可以留言索取RAG学习资料,对自学者来说是一个可用的补充渠道。
企业级RAG的工程化考量:教程未展开的工程问题,恰恰是私有知识库从“能搭起来”到“用得住”的关键。文档权限方面,需要确保不同角色只能检索到授权范围内的内容,通常要在检索层做权限过滤;更新同步方面,文档增删改后需触发索引重建或增量更新,避免知识库与源文档脱节;评测体系方面,需要建立召回率、答案准确率等指标,用标注问答集持续评估效果。此外还涉及敏感信息脱敏、检索日志审计、并发性能等。建议在完成教程项目后,优先补齐权限与评测两块,它们对实际落地的影响最大。
相关推荐

腾讯WorkBuddy实测:AI Agent如何碾压传统聊天助手
腾讯WorkBuddy实测对比豆包:AI Agent如何直接操作电脑完成PPT转PDF、文件归档等任务。从安装门槛、国内生态、价格、插件市场四方面分析WorkBuddy优势,并给出AI Agent选择建议。

奥特曼称个人PC囤RAM“相当糟糕”,数据中心利用率更高
OpenAI CEO萨姆·奥特曼在Reddit引发热议的表态中称,个人PC配备大量RAM是“相当糟糕”的资源利用方式,数据中心凭借集中调度能实现更高内存利用率。本文解析这一观点背后的技术逻辑与行业信号。

付费5美元教AI说话:一场关于AI训练本质的社会实验
一位开发者搭建了运行真实语言模型的「假AI实验室」,用户支付5美元即可教模型一句话。这个社会实验揭示了AI训练中数据成本、用户参与和话语权的深层关系。