B站最全Agent应用开发路线图:五步从零到工程级
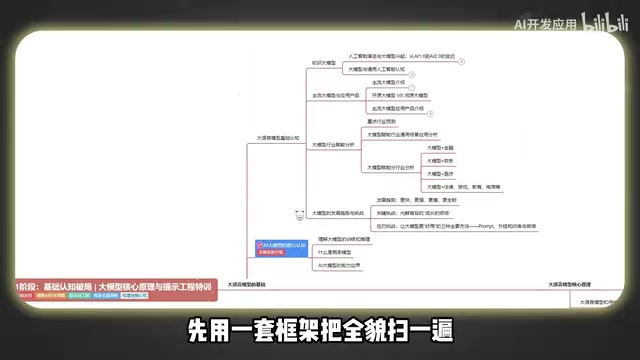
B站748集Agent教程给出普通程序员的五阶段AI工程学习路线图
该文介绍了一套B站全748集的Agent应用开发教程,其核心主张是普通程序员应聚焦「工程档」而非入门或研究档,目标是能改、能调、能做RAG、微调和Agent。教程将学习路径拆成五个阶段:数学最低配置、深度学习基本盘(各三天)、核心模型扫盲、LLM工程三板斧、Agent实战,强调先快跑一遍再按需补,其中Transformer最值得花时间。文章同时指出最坑的学习法是只刷内容不做实验,建议把GPT当24小时老师并搭最小demo逐行排错。最后坦承该路线牺牲理论深度换上手速度,适合想转AI工程岗的开发者,「七天成神」是标题党。
AI正在以比互联网快十倍的速度吞噬几乎所有行业。对于普通程序员来说,问题早已不是"要不要学AI",而是"怎么从零开始,真正做到能上手做AI项目"。B站一套号称全748集的Agent应用开发教程,试图用一条五阶段路线回答这个问题。它的核心逻辑很简单:先拿到一张航海图,再自己划船——路线不清,才是没开始的最大原因。
为什么普通程序员必须走"工程档"
这套教程把学习目标分成三档:入门、工程、研究。它明确建议绝大多数人只盯第二档——工程档。理由很直接:这一档的能力要求是"能改、能调、能做RAG、微调、Agent",对应的是企业里真实存在的岗位需求,而不是发论文。
入门档停留在调API、跑demo,研究档需要扎实的数学和实验能力,投入产出比对普通开发者并不友好。工程档卡在中间,恰好是当前AI落地最缺人的位置:既不需要推导反向传播,也不能只会复制粘贴。
教程反复强调一个判断:犹豫和观望是这个时代最大的成本。AI知识在指数级膨胀,拖的每一天,补课成本都在变高。这话有贩卖焦虑的成分,但对已经决定要学的人,先扫全貌再深入,确实是更省时间的路径。
Agent(智能体) 是让大模型从「被动回答问题」升级为「主动完成任务」的形态。教程给出的公式是「LLM + 工具 + 规划」:LLM 提供理解与决策能力,工具让模型能真正读文件、查数据库、发请求、操作浏览器,规划则让模型把一个大目标拆解成多步并逐步执行。典型的 Agent 循环是「观察 → 思考 → 行动 → 再观察」,比如接到「帮我整理这份销售数据」的任务后,模型会自己决定先读文件、再调用计算工具、最后生成报告。与普通对话机器人相比,Agent 的关键差别在于它能调用外部工具并根据结果调整下一步,因此能处理需要多步协作的真实任务,这也是当前 AI 应用开发最热、岗位需求增长最快的方向。
五阶段路线:从数学到Agent实战
整条路线被拆成五个阶段,教程的建议是"先快跑一遍,再按需回头补",而不是在一个阶段死磕到完美。
阶段一与二:数学和深度学习基本盘(各三天)
数学只学够用的:矩阵、梯度下降的直觉、概率与噪声。目标是建立直觉,不是刷题。深度学习基本盘同样压缩到三天,抓三件事——神经网络的本质、训练循环、一个最小CNN。这种"最低配置"思路贯穿全程:先能跑,再理解。
阶段三:核心模型扫盲
这一阶段覆盖CNN、RNN、Transformer、Diffusion。教程明确指出,Transformer是LLM的股价,最值得花时间。换句话说,前面几个模型了解即可,Transformer必须吃透,因为它直接决定你后面能不能看懂大模型的行为。
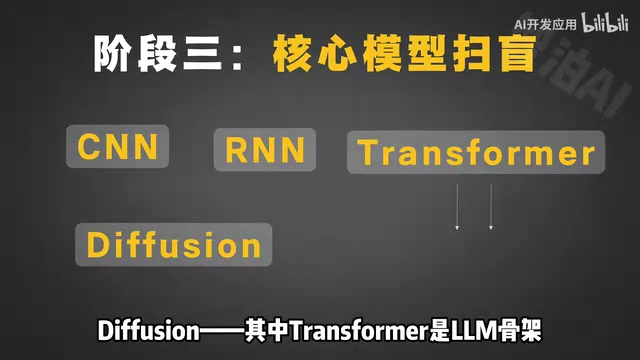
Transformer 是 2017 年论文《Attention Is All You Need》提出的架构,它用自注意力机制取代了 RNN 的循环结构,让模型可以并行处理整段序列并捕捉任意位置之间的依赖关系。当前几乎所有主流大语言模型(GPT、Claude、DeepSeek广告、Llama 等)都以它为基础架构,因此教程说「Transformer 是 LLM 的股价」。理解它至少要抓住三个概念:注意力(给序列中不同位置分配权重)、多头(从多个子空间并行关注不同模式)、位置编码(把顺序信息注入模型)。除此之外,还要区分编码器、解码器、编解码器三种变体,以及它为什么能随参数量和数据量增长而持续提升性能。吃透这些,后面看大模型的上下文、注意力窗口、涌现能力等行为才不会一头雾水。
阶段四:LLM工程三板斧
这是整个路线里最硬核的部分,也是工程档的核心竞争力。
- 微调:让模型偏向你的风格和数据
- RAG:让模型知道公司的事,教程称80%的企业问答用它就够了
- 推理部署:跨入工程级的门口
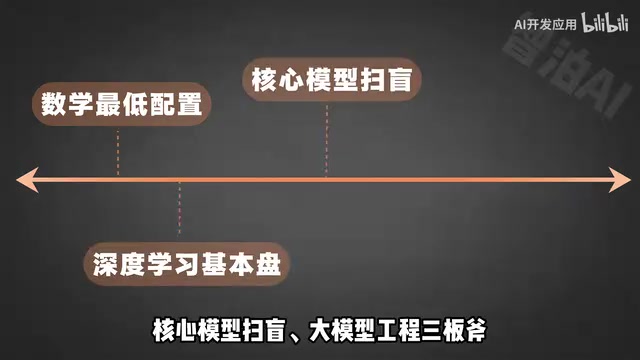
这三项对应的是企业里最常见的三类需求:定制化输出、私有知识问答、可上线的服务。掌握它们,基本就具备了做真实AI项目的入场券。
RAG(检索增强生成) 是指在调用大模型之前,先从企业私有知识库(文档、数据库、工单等)中检索出与问题相关的片段,把这些片段拼进提示词里一并交给模型,让模型基于真实资料作答。它的价值在于:无需重新训练模型,就能让模型回答它原本不知道的私有信息,同时降低幻觉。典型流程是「文档切块 → 向量化入库 → 用户提问向量化 → 相似度检索 → 拼接上下文 → 生成回答」。相比微调,RAG 更新知识只需替换索引,成本低、可溯源,因此在企业问答、客服、内部知识助手等场景中覆盖面最广,这也是教程称其能覆盖 80% 企业问答需求的原因。
推理部署 指的是把训练或微调好的模型真正跑起来对外提供服务,涉及模型量化、显存优化、并发调度、批处理、延迟与吞吐权衡等工程问题。它和「本地跑个 demo」是两回事:demo 只关心结果对不对,部署要关心每秒能服务多少请求、单次响应多快、成本多少、服务挂了怎么办。常用的推理框架包括 vLLM、TensorRT-LLM、Ollama 等,量化则常用 INT8、INT4 等手段压缩模型体积。对工程岗来说,能把模型稳定、经济地跑在生产环境,往往比会调 API 更稀缺,这也是教程把它列为跨入工程级门口的原因。
阶段五:Agent实战
Agent的公式被简化成一句话:LLM加工具加规划,让模型不只会说,而是会去做。这是当前AI应用开发最热的方向,也是这套教程标题里"Agent应用开发"的落脚点。前面的模型扫盲和工程三板斧,都是为这一步做铺垫。
最坑的学习法:只刷内容,不做实验
教程里最直接的一句警告是:不装PyTorch、不写代码,等于没学AI。它点名了最坑的学习法——只刷视频、只收藏教程、只看别人总结,从不自己动手跑一遍。
配套的方法论也很具体:
- 别自己硬看DeepSeek或GPT,它就是你的七乘二十四小时老师
- 教不会,就让它讲人话
- 搭一个最小demo,逐行看报错
- 提问越具体,进步越快
这套思路的本质是把AI当成学习工具本身,而不是学习对象。遇到看不懂的代码、报错、概念,直接让模型解释、改写、举例,比翻文档快得多。前提是你得先动手,让问题具体到可以提问。
这套路线适合谁,不适合谁
坦率地说,这条路线有明显的取舍。它牺牲了数学和理论的深度,换来上手速度,适合已经在写代码、想尽快转AI工程岗的开发者。如果你目标是读论文、做研究,三天数学显然不够。
另外,"七天从小白到大神"是典型的标题党。五阶段快速扫一遍可能只需要几周,但每一阶段的"工程级"能力,都需要在真实项目里反复打磨。路线图能解决"不知道学什么"的问题,解决不了"练得够不够"的问题。
真正值得记住的判断来自教程结尾:这波不是每个人都能赚钱,但认真投入的人都会被推着往前走。方向清楚了,剩下的就是划船。
相关推荐
打开n8n之前,先用Claude定义你的AI智能体
在打开n8n搭建AI智能体之前,先用Claude定义智能体的处理范围、数据需求和人工升级机制。本文以电商客服场景为例,解析先定义后构建的AI工作流方法论。
n8n + GoHighLevel + AI:自动化销售线索分发实战
用n8n、GoHighLevel和AI搭建自动化线索分发系统:表单提交后自动查重联系人、AI分类路由到销售或合作伙伴团队、创建机会并发送Slack通知,全程1.5秒内完成。
n8n内容自动化工作流:一次创作全平台分发
n8n内容自动化工作流可在一下午搭建完成,自动完成跨平台改写、配图生成与整周排期,每周节省约六小时运营时间,适合小型企业以工具优势对冲团队规模劣势。