Canto语音模型:为真实世界场景打造的语音AI
Canto是一款主打真实环境鲁棒性的语音模型,强调工程实用性优于学术刷榜。
Canto是近期在Hacker News上曝光的一款语音模型,其核心定位是"为真实世界打造",直接回应了语音AI领域长期存在的痛点——大多数模型在干净测试集上表现优异,却在噪声、口音、延迟等真实环境中显著退化。文章指出,对于构建语音助手、客服系统或实时转录工具的团队,模型的鲁棒性、低延迟和灵活部署能力,远比标准数据集上的准确率更具实际价值。目前Canto仍处于早期传播阶段,社区关注焦点集中在开源授权、语言覆盖、推理成本及与Whisper等主流方案的差异化优势上。文章以此为切口,梳理了评估一款面向真实场景语音模型的四大维度:鲁棒性、实时延迟、部署灵活性与语言覆盖。
Canto:面向真实场景的语音模型
近日,一款名为 Canto 的语音模型在 Hacker News 上引发讨论。其定位十分明确——为真实世界的应用场景而设计。这一定位本身就点出了当前语音 AI 领域一个长期存在的痛点:许多在实验室基准测试中表现出色的模型,一旦进入嘈杂、多变、口音各异的真实环境,性能便大幅衰退。
从产品命名到宣传口号("built for the real world"),Canto 试图将自己与那些追求刷榜分数的学术型模型区分开来,强调在实际部署中的鲁棒性与可用性。
为什么"真实世界"是语音AI的核心挑战
语音识别与语音生成技术近年来进步显著,但真实环境与受控测试环境之间的差距,始终是工程落地的最大障碍之一。
真实世界意味着背景噪声、多人交谈、方言口音、专业术语、网络延迟以及不完整或被打断的语句。一个只在干净录音室数据上训练的模型,往往难以应对这些复杂性。Canto 将"real world"写进产品定位,实际上是在回应开发者社区对实用性优先的呼声。
对于构建语音助手、客服系统、实时转录、无障碍工具等应用的团队而言,模型在恶劣条件下的稳定性,往往比在标准数据集上高出几个百分点的准确率更重要。
社区反响与讨论
目前 Canto 在 Hacker News 上获得了 14 个 points 和 5 条评论,属于早期曝光阶段。这样的热度虽不算爆发式,但技术社区对新语音模型的关注通常集中在几个务实的问题上:
- 模型是否开源,授权协议如何
- 支持哪些语言与方言
- 推理成本与本地部署的可行性
- 与现有主流方案(如 Whisper 等)相比的差异化优势
这些问题共同构成了开发者评估一款语音模型是否"可用于生产"的标准。Canto 若要在竞争激烈的语音 AI 赛道站稳脚跟,需要在这些维度给出令人信服的答案。
Whisper 是 OpenAI 于2022年开源的语音识别模型,凭借在多语言识别和噪声鲁棒性上的出色表现,迅速成为开发者社区的基准参照。它采用大规模弱监督训练,在68万小时的多语言音频上预训练,覆盖99种语言。Whisper 的开源策略极大降低了语音识别的门槛,但其推理速度较慢、实时性有限,在流式场景下需要额外的工程优化。此后涌现的 faster-whisper、WhisperX 等社区衍生项目正是为了弥补这一缺陷。新入场的语音模型若要获得开发者认可,通常需要在"与 Whisper 相比有何优势"这一问题上给出清晰答案——无论是更低延迟、更好的方言支持,还是更轻量的部署体积。
语音模型落地的关键考量
从更宏观的角度看,Canto 的出现反映了语音 AI 从"能识别"到"可靠识别"的演进趋势。评估一款面向真实场景的语音模型,可以从以下几个方面入手:
鲁棒性
在噪声、混响、多说话人场景下的表现,是衡量"真实世界"能力的核心指标。
语音识别领域常用信噪比(SNR)和词错误率(WER)来量化鲁棒性。词错误率衡量模型输出与真实转录之间的编辑距离比例,是最核心的准确率指标;而在不同信噪比条件下 WER 的变化曲线,则直接反映模型对噪声的抗干扰能力。混响(Reverberation)是另一个常被忽视的挑战——声音在室内反射叠加后,会使语音特征产生严重失真,对仅在近场干净录音上训练的模型影响尤为明显。业界常用 CHiME、REVERB 等标准化噪声数据集对模型进行评测,但这些基准与真实部署环境仍存在差距,这也是为何"真实世界测试"比实验室跑分更受工程团队重视。
延迟与实时性
实时对话、直播字幕等场景对端到端延迟极为敏感,批处理准确率高但延迟大的模型难以满足需求。
部署灵活性
能否在边缘设备或本地服务器运行,直接决定了成本结构与数据隐私合规性。
语言覆盖
多语言与方言支持范围,决定了模型的适用市场广度。
结语
Canto 目前仍处于早期传播阶段,公开信息有限。但它以"为真实世界打造"作为核心卖点,切中了语音 AI 领域从学术指标向工程实用性转变的关键脉络。对于关注语音技术的开发者而言,值得持续观察其在开源程度、鲁棒性表现和部署成本上的后续披露。
真正决定一款语音模型价值的,从来不是它在干净数据上的分数,而是它在混乱现实中的表现。
相关推荐
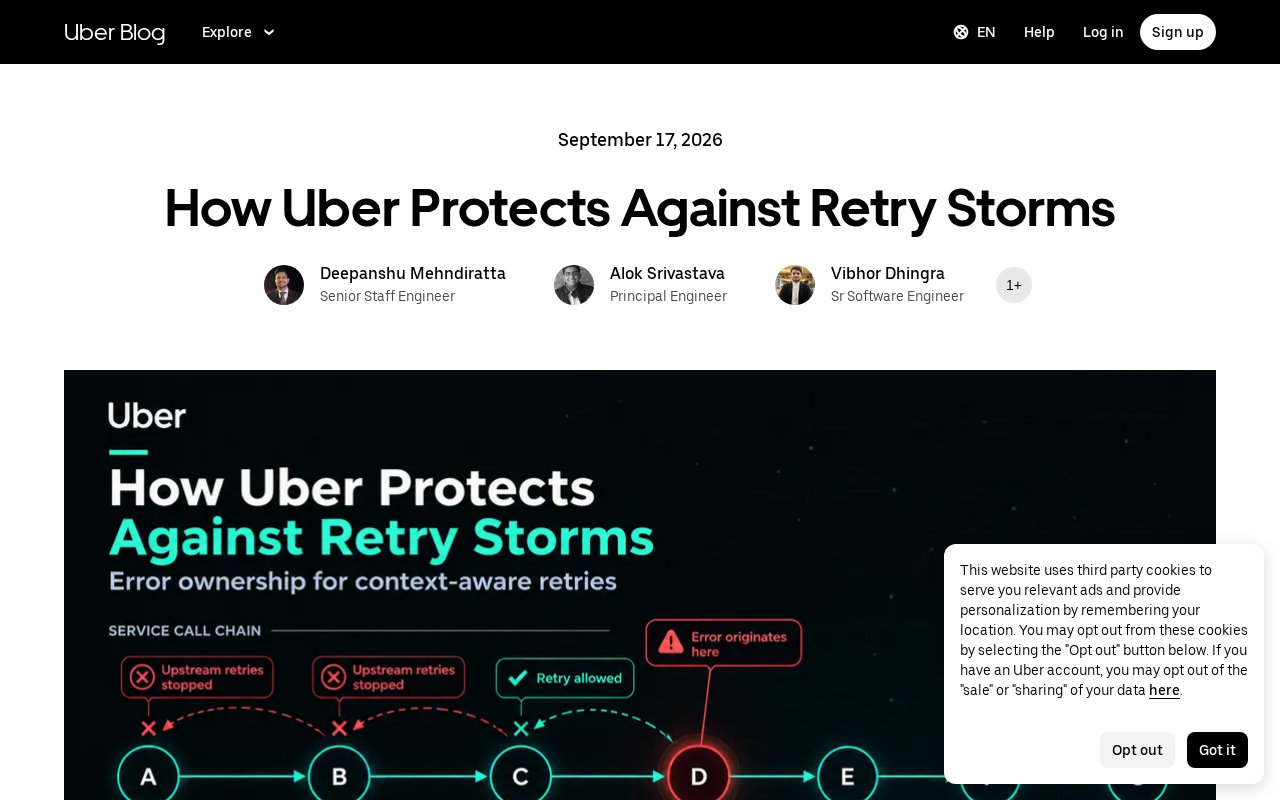
Uber如何防御重试风暴:分布式系统的容错设计
Uber如何防御重试风暴?本文解析分布式系统中重试流量的放大效应,以及重试预算、断路器、指数退避与抖动等容错设计策略,帮助工程团队构建更稳定的弹性系统。
Opus 5的道德边界:从拒绝到"恐怖主题项目"的绕行实验
一位开发者用Claude Opus 5开发果蝇隐喻项目时,因措辞被拒后改称"恐怖主题项目"成功绕行。本文剖析大模型内容审核对表层语义的依赖及其对AI安全与人机协作的启示。
语音AI在真实呼叫中心场景下真的靠谱吗?
语音AI真的能应对真实呼叫中心的抢话、改口和噪音吗?本文从技术边界、演示陷阱和人机协同角度,分析Voice AI在真实压力场景下的可靠性与评估方法。