Claude Fable 5.2 与 Mythos 5.2 发布:同款模型的双重安全策略
Anthropic 以同一底层模型推出安全等级不同的 Fable 5.2 与 Mythos 5.2。
Anthropic 发布 Claude Fable 5.2 与 Claude Mythos 5.2,两者本质是同一底层模型,差异仅在安全防护等级,这种“同模双版”策略在主流厂商中并不常见。Fable 5.2 在 FrontierCode 2.0 上得分 49.1%,定价为每百万 token 输入 8 美元、输出 40 美元,提供 100 万 token 上下文窗口;Mythos 5.2 则面向需要更严格安全边界的场景。文章认为,把安全作为产品分层维度,回应了监管压力与企业采购需求,使客户可在不更换底层模型的前提下按场景选择合规级别。但 Mythos 5.2 的具体安全差异、定价与基准表现均未公开,安全护栏是否损害输出质量仍是关键未知数。
一次发布,两个名字:Anthropic 的新玩法
Anthropic 发布了 Claude Fable 5.2 和 Claude Mythos 5.2 两款模型。有趣的是,它们本质上是同一个底层模型,区别仅在于安全防护(safeguard)的等级不同。这种“同模双版”的发布策略,在主流大模型厂商中并不常见。
据 MarkTechPost 报道,Fable 5.2 在 FrontierCode 2.0 基准上得分 49.1%,定价为每百万 token 输入 8 美元、输出 40 美元,并提供 100 万 token 的上下文窗口。Mythos 5.2 则面向需要更严格安全边界的场景。
命名背后的产品逻辑
“Fable”(寓言)与“Mythos”(神话)这两个名字本身带有隐喻色彩。从公开信息看,Anthropic 并未将它们定位为不同能力档位的模型,而是将安全策略作为产品差异化的主轴。
这种做法的好处很直接:企业客户可以在不更换底层模型的前提下,根据业务场景选择不同的合规与安全级别。对于需要处理敏感数据、面向公众服务或受监管行业的企业,Mythos 5.2 提供了更保守的默认行为;而 Fable 5.2 则更适合追求模型原始能力、愿意自行承担更多安全责任的开发团队。
与行业惯例的对比
主流厂商通常通过模型尺寸(如 Pro/Flash/Lite)或能力层级(如不同参数规模)来区隔产品线。Anthropic 把“安全”单独拎出来作为一个产品维度,反映出监管压力与企业采购需求正在重塑大模型的商业形态。同一个模型、两套安全护栏,本质上是在回答一个问题:安全策略应该由厂商一刀切,还是由客户按场景选择?
安全防护(safeguard)的具体构成
在大模型产品语境中,safeguard 通常是一组分层机制的总称:训练阶段的对齐微调与拒答行为塑造、推理阶段的内容分类器与风险阈值、输出端的过滤与审核层,以及针对特定领域(如金融、医疗)的合规策略配置。不同等级的安全防护可能表现为更保守的拒答边界、更严格的双用途信息限制、额外的输出复核环节或更细粒度的审计日志。这些机制往往以牺牲部分回答完整度或增加推理延迟为代价换取更低的风险暴露,因此“同模双版”在体验上的差异,本质上取决于这些护栏的触发频率与拦截粒度。
关键参数解读
定价: Fable 5.2 的输入价格为每百万 token 8 美元,输出为 40 美元。输出价格是输入的 5 倍,这一比例与当前主流大模型的定价结构大致相符,反映出长文本生成仍是成本大头。
上下文窗口: 100 万 token 的上下文容量,意味着可以一次性处理超长文档、大型代码库或多轮长对话历史。这一规格在当前的旗舰模型中属于第一梯队。
基准成绩: FrontierCode 2.0 上 49.1% 的得分,说明该模型在代码相关任务上具备一定竞争力。需要说明的是,单一基准的分数并不能完整反映模型的实际表现,具体效果还需结合真实业务场景验证。
基准测试与 FrontierCode 2.0
FrontierCode 2.0 是一个面向代码生成与程序理解的评测基准,通常包含多语言编程题、真实仓库级任务和单元测试验证环节,用以衡量模型在函数补全、缺陷修复、跨文件推理等方面的能力。49.1% 的得分需放在具体基准的难度分布中理解:若该基准的通过率整体偏低(如多数模型在 30%–50% 区间),则 49.1% 属于有竞争力的水平;但单一基准的分数受提示词设计、采样策略和评测集污染等因素影响,不能直接等同于生产环境表现。业界通常还会参考 HumanEval、SWE-bench 等互补基准,并结合真实业务回归测试来综合判断模型能力。
上下文窗口与百万 token 的实际含义
上下文窗口指模型单次推理能够接收并关注的 token 总量,涵盖系统提示、对话历史、检索文档与待生成内容。100 万 token 大致相当于数十万汉字或数万行代码,使模型能够一次性消化大型代码库、长篇合同或长会议记录,而无需依赖外部分块与检索拼接。但需注意,有效上下文并不等于名义上下文:随着输入增长,模型对中段信息的召回可能下降(即“长上下文中间遗忘”现象),且推理成本与延迟随 token 数线性甚至超线性上升。因此百万级窗口更适合作为减少工程复杂度的能力储备,而非无条件全量灌入。
双重安全策略意味着什么
从产品设计角度看,Fable 5.2 与 Mythos 5.2 的并行存在,可能会带来几个连锁影响。
其一,企业采购的决策链条会发生变化。安全团队和合规部门将更早介入模型选型,而不再只是技术团队拍板。其二,同一模型的两个安全版本,意味着客户可以在开发测试阶段使用 Fable 5.2 获得更完整的模型行为,在生产环境切换到 Mythos 5.2 以满足合规要求。这种灵活性对金融、医疗、教育等受监管行业尤其有吸引力。
不过,目前公开信息尚未披露 Mythos 5.2 在安全策略上的具体差异——例如是更严格的拒答阈值、更保守的内容过滤,还是额外的输出审核层。这一细节的缺失,让外界难以评估两个版本在实际使用中的体验差距。
值得关注的开放问题
Mythos 5.2 的定价是否与 Fable 5.2 一致,目前没有明确信息。如果安全加固带来了额外的推理开销,价格可能出现差异。此外,两个版本在 FrontierCode 2.0 上的成绩是否相同,报道中只给出了 Fable 5.2 的 49.1%,Mythos 5.2 的基准表现仍是未知数。
对于开发者而言,更实际的问题是:安全策略的差异会不会影响模型在编程、推理等任务上的输出质量?如果 Mythos 5.2 因为更严格的护栏而频繁拒答或降低回答完整度,那么“同款模型”的说法在实际体验中就要打折扣。
Anthropic 此举能否被市场接受,取决于企业客户是否真的愿意为“可切换的安全等级”买单。在模型能力日趋同质化的竞争格局下,把安全做成产品分层,至少提供了一种新的思路。
相关推荐

Claude Code进阶指南:10个技巧告别手动审批
基于The Benmore Brief的Claude Code进阶教程,整理10个实用技巧:从自动模式、努力等级、旁支聊天到手机远程控制和定时任务,帮助初学者摆脱逐项审批,让AI在你不在场时也能推进工作。

字节扣子为何突然失声?AI工作流过时与内部布局摇摆
字节扣子从AI必学工具到声音渐弱,B站UP主分析其工作流模式过时、编程转型不力,以及字节在Workbody竞争压力下对豆包、飞书、Tree Work的资源重新权衡,扣子团队或面临合并解散。
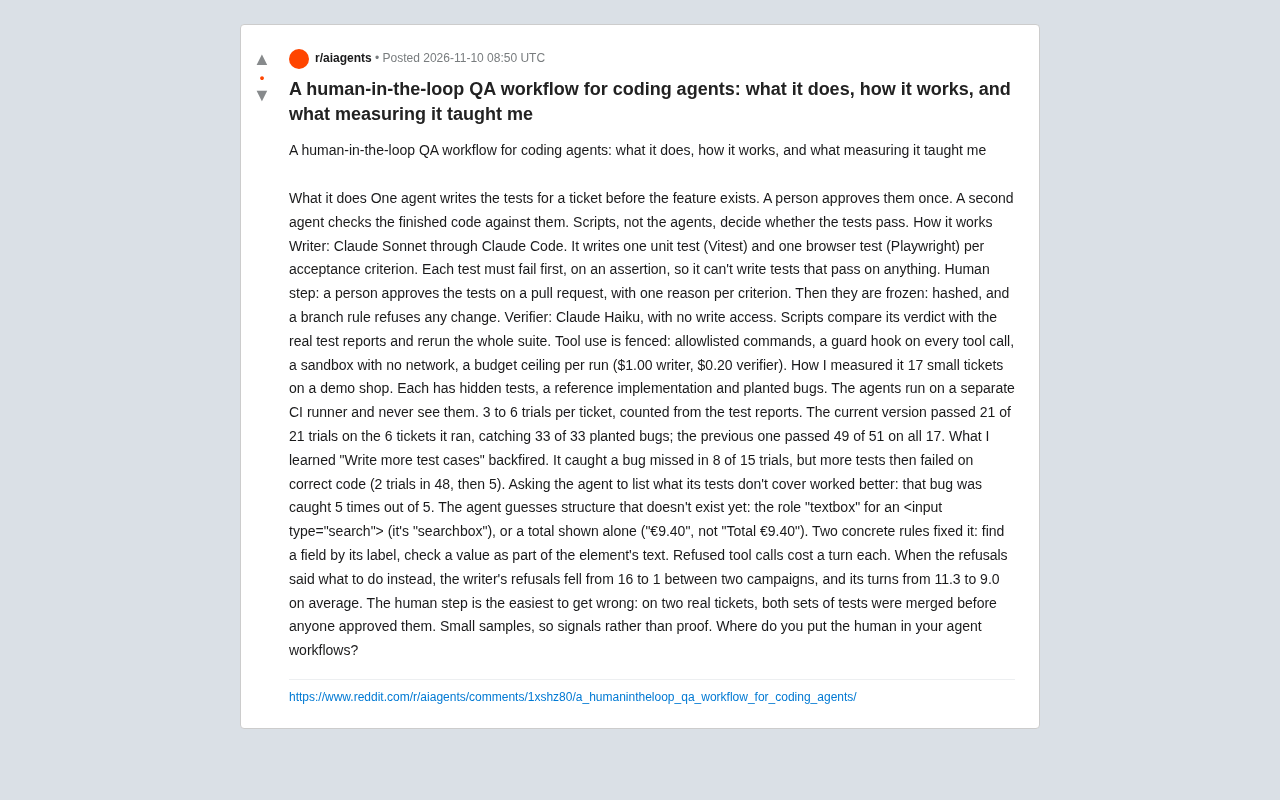
人类在环QA工作流:为编码智能体加上测试门禁
Reddit开发者分享编码智能体的人类在环QA工作流:智能体先写测试、人工审批冻结、脚本裁决结果。实测17个工单,发现多写测试反而增加误报,让智能体列出未覆盖范围更有效。