Claude Fable 5.2实测:智商登顶但贵得离谱
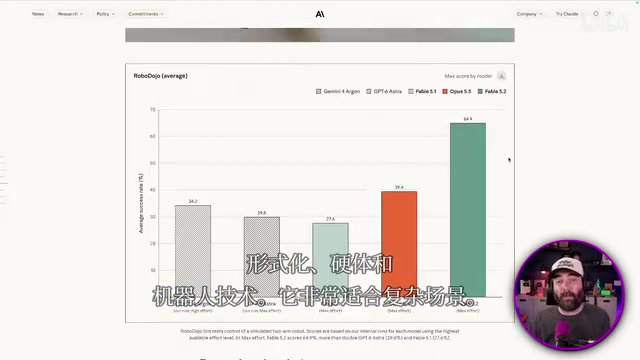
Anthropic 发布 Fable 5.2 与 Mythos 5.2:硬核任务大幅跃升,日常编码提升有限,max 档反而不划算。
Anthropic 同时发布 Fable 5.2 和 Mythos 5.2,二者本质是同一模型,前者面向普通用户并加了更严格的网络安全护栏,后者面向安全测试人员。Fable 5.2 在 agentic 科学研究等硬核基准上大幅刷新 SOTA,从 Opus 5.5 的 58.7 升至 74.6,但日常编码提升温和,商业工作流还落后 Gemini Carbon 两个百分点。实测显示 max 推理档收益递减,extra high 档反而得分更高、成本更低。游戏生成机制一次成型但美术略逊,硬件设计可输出完整零件清单、固件与 3D 打印文件。API 定价为每百万 token 输入 8 美元、输出 40 美元,是 Opus 5.5 的两倍。官方建议日常任务用 Opus 5.5,Fable 5.2 适合作为顾问或编排者处理硬问题。
Anthropic 同时发布了两款新模型:Fable 5.2 和 Mythos 5.2。二者本质上是同一个模型,Mythos 5.2 面向网络安全测试人员,加了更少的护栏;普通用户能用的是 Fable 5.2,它在网络安全方面有更严格的限制。据 B 站 UP 主实测,这是近期少有的、能实际用到且提升幅度明显的模型——Google 的 Carbon 虽然已经公布,但尚未向公众开放。
基准测试:硬核任务大幅跃升,日常编码提升有限
Fable 5.2 在多数基准上刷新了 SOTA。最显眼的是 agentic 科学研究一项,从 Opus 5.5 的 58.7 一路涨到 74.6,中间 Astra 为 68.1、Carbon 为 64.8。相比之下,agentic coding 的进步就温和得多:Frontier code 从 Opus 5 的 45.5% 升到 49.1%,Frontier SWE v2 提升约 7 个百分点。商业工作流方向,Gemini Carbon 反而领先两个百分点。
一个反直觉的发现是:让模型「想更久」不一定更好。在 Frontier code 2.0 上,Fable 5.2 在 extra high 档的得分高于 max 档——max 模式思考更久、花费更高,表现却更差。另一组对比更有意思:Fable 5.2 在 high 档的表现大致等于 Opus 5.5 在 max 档,但成本更低。
人工分析(Artificial Analysis)的综合智能评分中,Fable 5.2 登顶,甚至超过了尚未全面开放的 Gemini 4 Carbon。但代价不菲:max 推理模式下平均每个任务成本约 26.54 美元,是所有模型里最贵的。不过它的输出 token 消耗量低于 Sonnet 5.5,说明单次任务用的 token 反而更少。
agentic 基准指让模型在模拟或真实环境中自主完成多步骤任务(而非单轮问答)的评测方式,例如自主调用工具、编写并运行代码、检索资料、根据反馈迭代。与静态问答基准相比,它更贴近实际工作流,也更难刷分,因此分数差距往往被放大解读。文中出现的 agentic 科学研究、agentic coding、Frontier SWE v2 都属于此类。
SWE 基准(Software Engineering 基准)以真实开源仓库的 issue 为题目,要求模型定位并修改代码、通过仓库自带的测试。Frontier SWE v2 是该类基准的较新版本,难度更高。它衡量的是端到端修复能力,而不只是代码补全的准确率。
实测游戏:机制一次成型,美术略逊 Opus
UP 主用经典的「克隆 Mega Bonk」提示词做了测试。Anthropic 近期调整了策略,模型不再直接克隆现有游戏,但也没有拒绝——它会先声明「不会复刻 Mega Bonk 本身」,然后构建一个同类型的原创游戏。
生成的作品名为《Shard Storm》,第三人称、生存 roguelite、自动开火、XP 宝石、升级选择,机制全部正常:冲刺消耗体力、升级获得二段跳、音效按预期触发。16 分钟生成完毕,一次跑通。UP 主的评价是「机制完美,但画面不如 Opus 5.5」——他推测部分原因是自己只开了 medium 推理档。
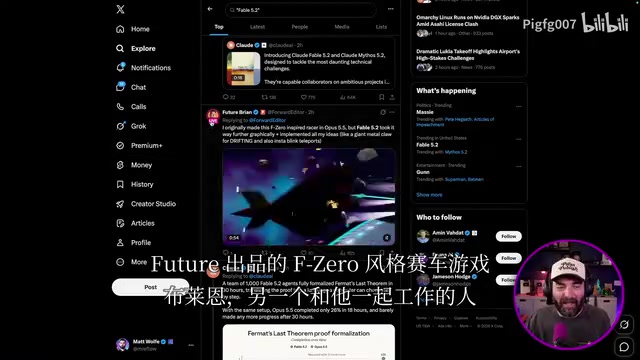
社区里拿到早期访问权的开发者展示了更高上限:Matt Berman 团队的 Gears of War 克隆画质惊艳,Alex 在两小时 demo 里做出了 Zelda 复刻、Halo 风格游戏、Iron Man 游戏、Photoshop 克隆、Premiere 克隆和变声器,一天内跑了 23 个 demo。Peter Yang 则让它纯用代码生成了一段 20 秒的秋季神社旅行广告,音乐、美术、动画全部由代码驱动。另一位开发者 Matt Schumer 做出了实时映射真实地球的开放世界游戏,可破坏场景、实时天气,虽然偶尔出现穿模和人物冻结的 bug。
推理档位(如 medium、high、extra high、max)是这类模型提供的「思考预算」开关:档位越高,模型在给出答案前生成的内部推理 token 越多,耗时和费用也越高。业界通常假设档位越高效果越好,但文中 Frontier code 2.0 的结果表明这种假设并不总成立——过长的推理可能引入过度探索或偏离目标,反而不如中等档位。因此在实践中应按任务类型和成本敏感度选择档位,而不是无脑开 max。
硬件设计:从零件清单到 3D 打印外壳
UP 主给了一个现实世界的任务:设计一个手持桌面小装置,按下按钮时像素风的 Gary Busey 会有反应,要求给出规格、选型、固件代码、可 3D 打印的外壳和接线说明。
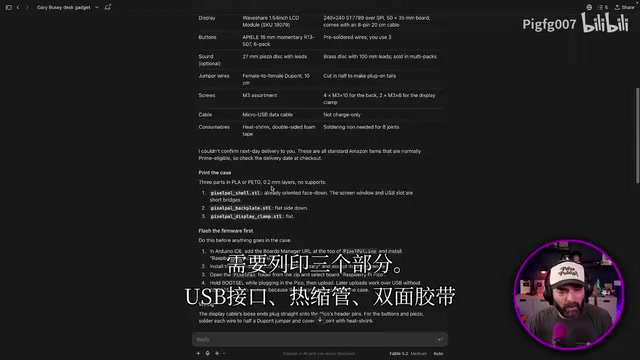
模型给出了完整方案:Raspberry Pi Pico H 主控、显示屏、按钮、跳线、螺丝、热缩管等采购清单,四个 STL 打印文件,Python 固件,以及分步装配手册。护栏在这里也起了作用——它拒绝使用真人肖像,把角色换成了原创机器人。UP 主追加要求「带图片的详细装配手册」并开到 high 档,约 15 分钟后拿到了一份逐层拆解的图文指南,他表示打算真的动手把这个装置做出来。
Anthropic 官方给的案例更夸张:一位工程师让 Fable 5.2 从空文件夹开始设计一个原型操作系统,模型协调超过 1000 个子 agent 连续工作八天,产出了一个能在笔记本上启动的系统,包含驱动、永久文件存储、窗口、登录界面和安装器。它还用两个开源蛋白质折叠模型,找到了准确预测完整衣壳结构的新方法。硬件方面,一段话的提示词就让三个带电路板、3D 打印外壳和软件的电子设备成型。
子 agent 编排指主模型把一个大目标拆成多个子任务,分别派发给独立的模型实例并行或串行执行,再由主模型汇总结果、检查一致性并继续推进。文中「协调超过 1000 个子 agent 连续工作八天」即属此类:它考验的不只是单个模型的能力,还包括任务分解、上下文传递、错误恢复和长时程状态管理。这也是「编排者」使用模式的极端形态。
定价与使用建议:日常用 Opus,硬仗才上 Fable
API 价格是每百万 token 输入 8 美元、输出 40 美元,是 Opus 5.5 的两倍,但比上一代 Fable 5.1 的 10/50 便宜,也略低于通过 OpenAI 使用的 Astra(10/50)——而且多数基准上更聪明。所有付费 Claude 计划(Pro 每月 17 美元起、Max Ultra 等)都能在模型下拉菜单里看到 Fable 5.2,免费用户无法使用。发布首周有额外的使用额度和周用量折扣。
Anthropic 自己的建议很直接:大多数编码和知识任务从 Opus 5.5 起步,需要时再切换到 Fable。Fable 5.2 更适合两种角色——顾问,由它指导 Haiku、Sonnet、Opus 干活;或者编排者,它把握全局,把简单任务分派给更小的模型。
至于那个所有基准里最重要的「Busey Bench」——生成 Gary Busey 的 SVG 版本——UP 主花了 19 分 50 秒、122248 个 token、接近 5 美元,结果在 LLM 评委排名里只排第六,落后于所有 GPT 模型和 Gemini 4 Argon。
顾问模式与编排者模式是两种不同的模型分工思路。顾问模式下,强模型不直接产出最终结果,而是给出方案、评审或纠错意见,由小模型执行,从而用少量高价值 token 换取整体质量提升;编排者模式下,强模型负责全局规划与任务分派,把简单子任务交给更便宜的模型,自身只处理难点。两者的共同点是让小模型承担大部分 token 消耗,以缓解强模型单价高的问题。
一句话结论
这是为硬问题准备的模型:理论物理、蛋白质折叠、数学形式化、硬件与机器人。如果你只是做日常研究和中小型编码项目,Opus 5.5 足够;如果你要做游戏、找深藏 bug、设计实体装置,Fable 5.2 是目前能摸到的最强工具之一,只是别轻易开 max 档。
相关推荐
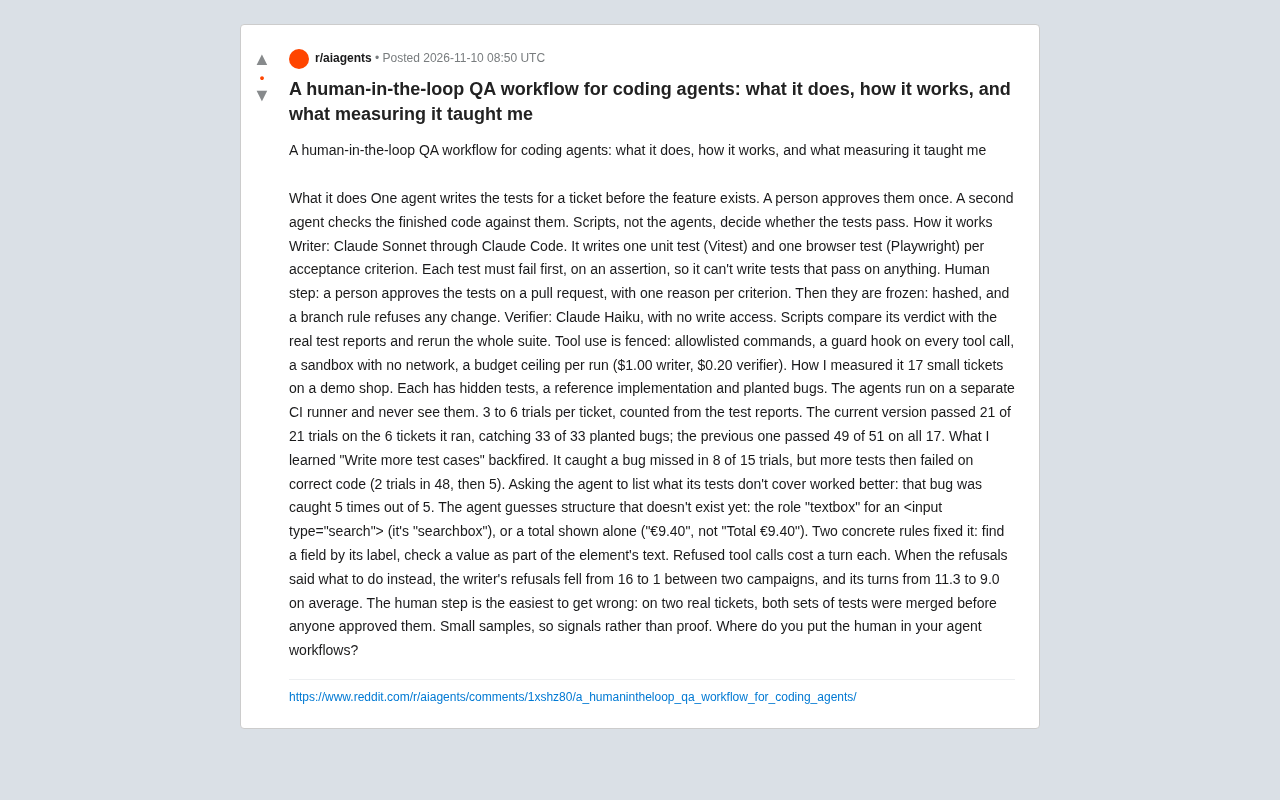
人类在环QA工作流:为编码智能体加上测试门禁
Reddit开发者分享编码智能体的人类在环QA工作流:智能体先写测试、人工审批冻结、脚本裁决结果。实测17个工单,发现多写测试反而增加误报,让智能体列出未覆盖范围更有效。
MiniMax开源H3-Image:基于H3的开放权重图像模型
MiniMax发布开放权重图像模型H3-Image,基于H3视频模型构建。社区关注其图像编辑能力、文生图质量及32B文本编码器带来的部署负担,有望与Qwen Image 2.1等模型展开竞争。
Claude Fable 5.2 与 Mythos 5.2 发布:同款模型的双重安全策略
Anthropic 发布 Claude Fable 5.2 与 Mythos 5.2,同一底层模型搭配不同安全防护等级。Fable 5.2 在 FrontierCode 2.0 得分 49.1%,输入输出定价每百万 token 8/40 美元,支持 100 万 token 上下文窗口。