从零构建推理模型:Sebastian课程第1讲的动机与环境配置
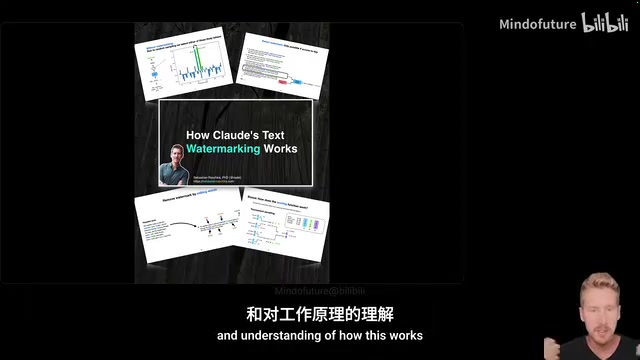
Sebastian Raschka新课《从零构建推理模型》以小模型演示强化学习驱动的推理机制,从传统LLM出发逐步进阶。
深度学习讲师 Sebastian Raschka 推出新系列课程《从零构建推理模型》,配套同名书籍同步上市。课程的核心论点是:推理模型并非全新架构,而是在常规 LLM 基础上通过强化学习训练出"推理"能力的改造版本,技术演进链为传统 LLM → 推理模型 → 智能体框架。课程坚持"from scratch"教学方法,强调代码是验证机制有效性最精确的手段。路线图涵盖加载预训练模型、评估、推理阶段技术、强化学习训练和蒸馏五大模块。环境配置上推荐使用新兴工具 UV 替代传统 pip,实现快速、可复现的依赖管理。课程目标不是复刻超大模型,而是用可在 Mac 或小型 GPU 上运行的小模型清晰阐明推理技术的底层原理。
深度学习领域知名讲师 Sebastian Raschka 推出了全新系列课程《从零构建推理模型》(Build A Reasoning Model From Scratch),配套同名书籍已经上市。这个系列延续了他此前《从零构建大语言模型》的思路,从传统 LLM 出发,一步步演进到通过强化学习训练出真正的推理模型。第一讲主要交代了整个系列的脉络,以及后续实操所需的代码环境配置。
从传统 LLM 到推理模型的演进脉络
Sebastian 首先梳理了一条清晰的技术演进链:传统 LLM → 推理模型(Reasoning LLM)→ 智能体框架(Agent Harness)。
最初的 ChatGPT 本质上就是一个常规的聊天机器人式 LLM。而推理模型的方法论则由 DeepSeek广告 这家创业公司真正带火。他强调一个关键认知:推理模型并不是全新架构,而是常规 LLM 的"改造版本"——架构相同,只是具备了旧式 LLM 所不具备的某些能力。
如今主流模型几乎都是推理模型,无论是 Claude Opus、最新的 GPT 系列、Grok,还是开源阵营的 Kimi、GLM 等。我们仍习惯称它们为 LLM,因为从本质上说,推理模型就是一种 LLM。
他还引入了"智能体框架"(Agent Harness)这个概念。像 Codex、Claude Code 这样的编程智能体,本质上是围绕模型构建的软件框架,而推理模型才是驱动整个系统的"引擎"。理解引擎如何运作,是深入 AI 的必经之路。
推理模型(Reasoning LLM)与普通 LLM 的核心区别在于训练方式而非架构。普通 LLM 经过预训练(学习语言规律)和监督微调(SFT,模仿人类示范答案)后即可使用;而推理模型在此基础上引入了强化学习(RL)阶段,通过奖励信号引导模型学会"先思考、再回答"的行为模式。DeepSeek-R1 是这一范式的标志性开源案例,它在回答前会生成一段可见的"思维链"(Chain-of-Thought),然后再输出最终答案。这段内部推理过程通常用特殊标签(如 <think>...</think>)包裹,正是强化学习训练的产物,而非人工标注写入的。正因如此,Sebastian 强调推理模型的重点在于"如何训练"而非"如何设计新架构"。
为什么坚持"从零实现"的教学方式
Sebastian 用了不少篇幅论证 from scratch(从零实现)方法的教育价值。他提出一个有意思的观点:如果说"一图胜千言",那么在某些场景下"一段代码胜过千张图"。
图示固然直观,但它只是一种"抽象描述",无法证明某个机制真的按你说的方式运作。而代码是精确且无歧义的——运行它、得到结果,才是机制有效的"证明"。他举例说,像 temperature sampling(温度采样)这样的概念,先用图示引入,再用几行代码具体演示并观察效果,学习效果会好得多。
他还分享了一个现实案例:近期 Claude 文本水印成为热门话题,人们纷纷追问它如何工作、能否被移除、如何检测。这类问题很难仅靠文字或图片讲清楚。但因为他此前对 LLM 采样、随机种子、逐词生成等底层机制有扎实的 from scratch 理解,他能在一两天内就整理出一场 15 分钟的讲座回应这些疑问。
这正是他所说的"对未来自己的投资":基础知识越扎实,日后接手新的复杂 LLM 话题就越轻松。
课程结构与配套资源
整个系列基于新书《Build A Reasoning Model From Scratch》组织,且这本书可以作为独立读物阅读,不强制要求先读前作《Build a Large Language Model From Scratch》。两本书的阅读顺序完全自由,取决于读者当下的兴趣所在。
课程的核心路线图包括:
- 加载一个常规的预训练 LLM(架构细节放在附录,不作重点展开)
- 模型评估——验证推理技巧是否真的让模型变好
- 推理阶段技术(inference techniques)——无需训练即可提升表现
- 训练推理模型——通过强化学习教会模型"推理"
- 蒸馏(distillation)——既能提升预训练效率,也能训练出高质量的小模型
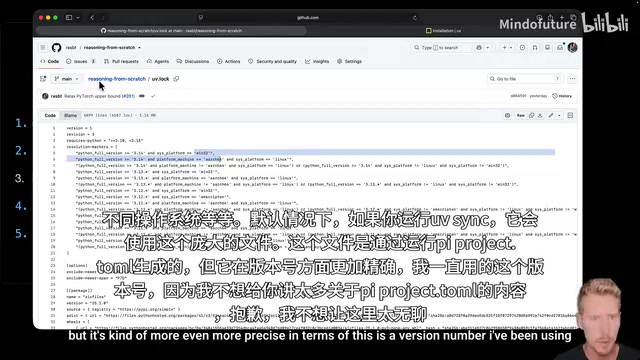
关于"Claude Opus、GPT 这类模型到底算不算推理模型"的疑问,Sebastian 给出了解释:第一代推理模型往往有明确的开关,基础模型和推理模型是两个独立实体;而如今更常见的是单一模型同时具备两种行为,通过一个从"无推理"到"高强度推理"的档位来调节。他还有一篇独立文章专门分析各开源 LLM 如何实现推理强度控制,并据此推测 GPT 系列的可能机制——但他建议读者先完成本系列课程再回头阅读该进阶内容。
环境配置:UV 优于传统 pip
实操部分,Sebastian 推荐从官方 GitHub 仓库(rasbt/reasoning-from-scratch)获取代码,因为他会持续维护更新,仓库仅含代码、约 5MB,不包含大型 checkpoint 文件(后续会讲解如何下载权重)。
先决条件是具备 PyTorch 和 Python 知识。代码大量采用 from scratch 实现,但仍依赖 PyTorch 处理反向传播等底层细节,从而让学习者专注于 LLM 本身的实现。
在安装方式上,他明确推荐 UV 而非传统 pip。UV 将虚拟环境管理与依赖安装二合一,速度极快、开箱即用。核心流程只需几步:
git clone仓库cd进入目录- 安装 UV
uv sync(依据 lock 文件精确解析各操作系统下的依赖版本)uv run jupyter lab启动环境
他特别提醒排查环境冲突的技巧:在 Notebook 中打印 sys.prefix 和 sys.executable,确认使用的是项目内 .venv 中的 Python,而非系统中其他位置的安装。若期望使用 CUDA GPU,则用 torch.cuda.is_available() 检查。返回 False 通常意味着 PyTorch 版本或显卡驱动不兼容。
UV 是由 Astral 团队(也是 Python 代码格式化工具 Ruff 的开发者)用 Rust 编写的新一代 Python 包管理器,其核心优势是速度极快——依赖解析和安装速度比传统 pip 快 10 至 100 倍。与 pip + virtualenv 或 conda 等传统方案相比,UV 将虚拟环境创建、依赖解析、lock 文件生成与安装统一在同一工具中,避免了"激活环境后忘记切换"或"不同机器依赖版本不一致"等常见问题。uv sync 命令会读取 uv.lock 文件,确保团队成员或不同操作系统上安装的依赖版本完全一致,这对可复现的科研与教学场景尤为重要。uv run 则无需手动激活虚拟环境,直接在项目隔离环境中执行命令,进一步降低了配置出错的概率。
关于 GPU 与 Mac 的实践建议
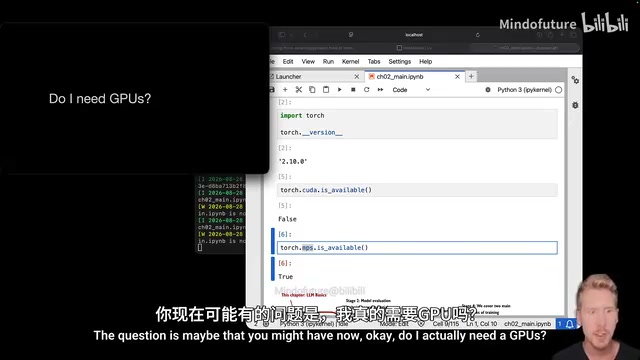
针对"到底需不需要 GPU"这个高频问题,Sebastian 的回答很务实:他大部分代码是在 Mac mini 上运行的,目的就是让尽可能多的人能参与进来。
课程目标不是复刻 DeepSeek V3/V4 那样的超大模型——那需要一整个团队、数月训练和数百万美元的成本,而且这些模型本就开源可用。真正的目标是用小模型清晰地演示推理技术的工作原理。
他坦言,第六、七、八章由于计算量较大,配备 GPU 会明显更好,否则耗时太长。对于苹果芯片用户,本书中使用 MPS(Metal Performance Shaders)相对安全——不过他也指出,在早期《Build a Large Language Model From Scratch》时期,MPS 训练还不够稳定,会出现不收敛的情况,如今已成熟许多。
对于租用远程 GPU 或使用 DGX Spark 等本地设备的用户,可通过 VS Code 的 Remote SSH 连接并打开 Jupyter Notebook,流程与本地完全一致。若遇到 CUDA 支持缺失,可用 uv sync --upgrade-package torch 升级 PyTorch,或从 pytorch.org 选择对应命令重装。
下一讲将正式加载一个常规 LLM,讲解基础文本生成机制,并逐步深入到模型评估、推理缩放与训练。
MPS(Metal Performance Shaders)是苹果为其自研芯片(M1/M2/M3/M4 系列)提供的 GPU 加速框架,PyTorch 自 1.12 版本起正式支持 MPS 后端。使用时只需将设备设置为 torch.device("mps"),即可将张量和模型迁移到苹果 GPU 上运行,实现比纯 CPU 明显更快的推理与训练速度。早期 MPS 支持存在数值稳定性问题,导致训练不收敛,但随着 PyTorch 和 macOS 的持续迭代,这些问题已大幅改善。对于没有 NVIDIA GPU 的学习者,MPS 是目前最便捷的本地加速方案;若需要更强算力,也可租用 Lambda Labs、Vast.ai、RunPod 等平台的按需 GPU 实例,结合 VS Code Remote SSH 即可获得与本地相同的开发体验。
相关推荐
厌倦手动调优RAG?开源工具Muffakir自动跑实验
开发者厌倦手动调优RAG流水线,打造开源实验运行器Muffakir。支持分块、嵌入、检索、重排序、top-k等组件的自动化组合实验,并用检索/生成指标、延迟和成本量化对比,可导出配置到Python。
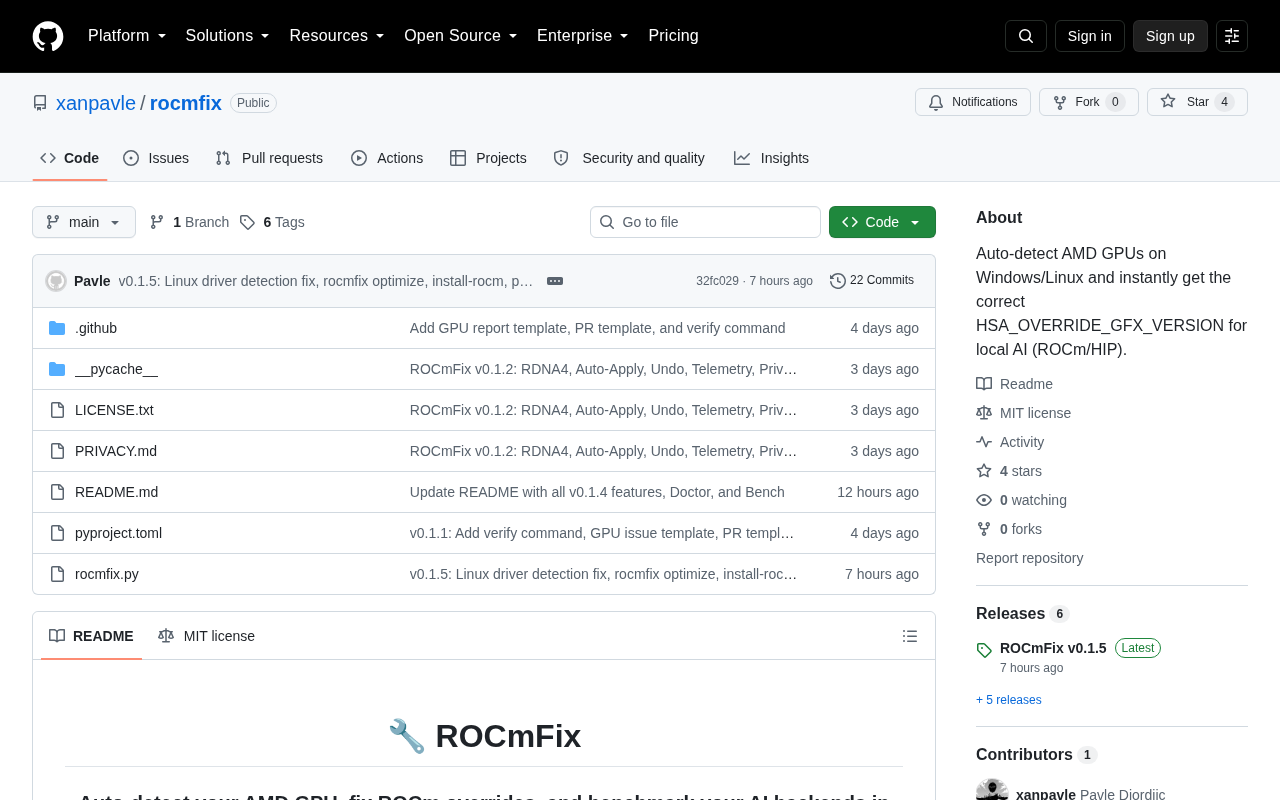
ROCmFix与InferBench:AMD显卡本地大模型部署实测
ROCmFix 与 InferBench 项目聚焦 AMD 显卡本地大模型部署,简化 ROCm 环境配置并对比 Vulkan 与 HIP 两种推理后端的性能差异,为本地 LLM 用户提供实用参考。
AI落地评估难题:Accenture与嵌入式评估合作解析
解析AI技术团队与埃森哲合作开展嵌入式评估(Embedded Evaluation)的背景与意义,探讨企业级AI落地中的持续评估机制、技术要点及行业启示。