大模型推理瓶颈与KV Cache:核心机制与主流优化方案

从自注意力重复计算切入,讲清KV Cache的原理、代价与三大引擎优化思路。
文章从自注意力机制的计算过程出发,指出每生成一个 token 都要重算全序列的 Q、K、V,是推理速度瓶颈的根源。KV Cache 通过缓存已计算的 K、V 矩阵、在 decode 阶段只计算当前 token 的 K、V 并与历史缓存拼接,显著降低了重复计算与显存开销,并由此划分出 prefill 与 decode 两个阶段。但 KV Cache 也带来新代价:无法预知序列长度导致提前申请大块连续空间,产生内部碎片与外部碎片;并行采样、束搜索等场景下 prompt 被重复存储。对此,vLLM 的 PagedAttention、SGLang 的 RadixAttention、LMDeploy 的量化分别从分页管理、前缀共享和精度压缩三个方向应对。文章最后建议优先选择 vLLM,因其通用性、生态成熟度与性能均衡性更优。
大模型推理的速度瓶颈,往往不在于模型权重本身,而在于注意力机制带来的重复计算。本期课程从自注意力机制的计算过程出发,拆解KV Cache如何成为推理加速的核心内存机制,以及它带来的新挑战与不同推理引擎的应对思路。
自注意力计算:推理瓶颈的根源
大模型推理时,每生成一个token,都需要对当前序列重新计算注意力。以输入序列“Aura”为例,处理完prompt后生成下一个token时,模型需要把“Aura”及其后续词元再次计算成Q、K、V矩阵。随着序列不断增长,重复计算量随之升高,显存和计算开销急剧膨胀,推理速度明显变慢。
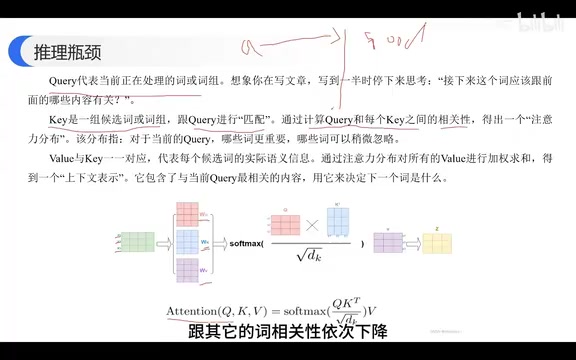
Q、K、V三个矩阵各有分工:Q(Query)代表当前正在处理的词或词组;K(Key)是一组候选词的表示,通过与Q做点积计算相关性;V(Value)则承载每个候选词的实际语义。注意力分数决定了当前词应该重点关注哪些候选词,再对相关性高的V进行加权求和,得到上下文表示,用于预测下一个token。
正是这种“每步都要重算全序列”的机制,构成了推理阶段的主要计算瓶颈。
Q、K、V 的矩阵来源与维度
在 Transformer 中,Q、K、V 并非原始词向量本身,而是由输入序列的隐藏表示分别乘以三个可学习的权重矩阵 $W_Q$、$W_K$、$W_V$ 得到。若隐藏维度为 $d_{model}$、注意力头数为 $h$、每个头的维度为 $d_k = d_{model}/h$,则对于长度为 $L$ 的序列,Q、K、V 的尺寸均为 $L \times d_{model}$(多头拼接后)。注意力分数的计算为 $\text{softmax}(QK^T/\sqrt{d_k})V$,其中 $QK^T$ 的复杂度为 $O(L^2 d_k)$,这是序列增长时计算量呈平方级膨胀的直接原因,也是 KV Cache 要解决的核心矛盾。
KV Cache:用空间换时间的核心机制
KV Cache的思路很直接:把已经计算过的K和V缓存起来,后续生成新token时直接复用,避免重复计算。
具体来说,模型先为KV Cache申请一块空间,在输入序列阶段计算并存入所有K、V矩阵。生成新token时,只需计算当前token的K、V,与缓存中的历史K、V拼接后进行注意力计算,再将新token的K、V追加进缓存。如此循环,序列中已处理的部分无需重新计算,显存和计算开销显著降低。
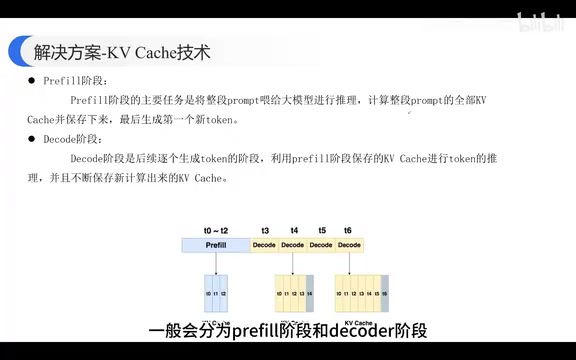
推理过程通常分为两个阶段:prefill阶段将整个prompt喂给模型,保存完整的KV Cache并生成首个新token;decode阶段则逐个生成后续token,每次只计算当前token的K、V,并利用prefill阶段缓存的KV进行推理。这种分工让计算复杂度大幅下降,显存资源利用率更高,推理速度更快。
prefill 与 decode 的计算特征差异
prefill 阶段一次性处理整个 prompt,所有 token 可并行计算,属于计算密集型(compute-bound)操作,GPU 算力利用率高;decode 阶段每次只生成一个 token,矩阵乘退化为向量乘矩阵,属于访存密集型(memory-bound)操作,性能主要受限于从显存读取模型权重和 KV Cache 的带宽,而非浮点算力。这一差异解释了为何 decode 阶段的优化重点往往落在显存带宽与 KV Cache 布局上,也解释了为何量化 KV Cache(减少读取字节数)能直接提升 decode 吞吐。
KV Cache的代价:显存碎片与重复存储
KV Cache并非没有成本。由于无法预知序列的最终长度,系统必须提前申请一块足够大的连续空间。随着序列增长,这块空间会不断膨胀,在显存占用中占比可观——课程图示中KV Cache占据了30%以上的空间,与模型权重、中间值缓存等争夺有限的显存资源。
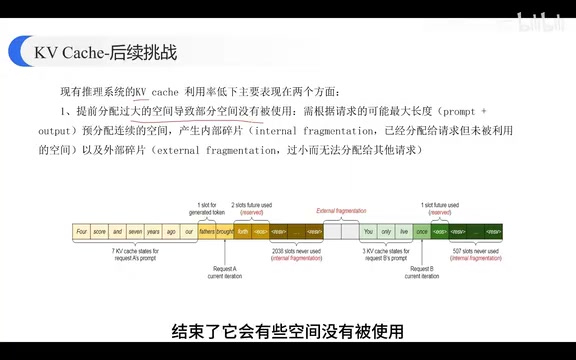
空间浪费主要来自两方面。内部碎片:提前申请的大块空间中,序列因EOS提前结束而未用满,剩余部分被浪费。外部碎片:申请大块连续空间后,剩下的小块不连续空间难以被下一个prompt利用,造成显存闲置。
另一个问题是重复存储。在并行采样、束搜索等解码算法中,一个prompt会生成多个输出结果,而每个结果都需要存储“prompt+结果”的完整序列,导致prompt被重复存储多次,显存利用率进一步下降。
PagedAttention 的分页映射原理
PagedAttention 将 KV Cache 切分为固定大小的块(block),每个块存放若干 token 的 K、V,逻辑上连续的序列通过块表(block table)映射到物理上可以不连续的显存块。这样新 token 到来时只需追加新块,无需预留连续大空间,内部碎片被限制在最后一个未填满的块内;不同序列还可以通过块表指向同一物理块实现共享,从而消除并行采样时 prompt 的重复存储。块表的作用类似操作系统的页表,使显存分配从“连续预留”转为“按需映射”。
主流推理引擎的优化路径
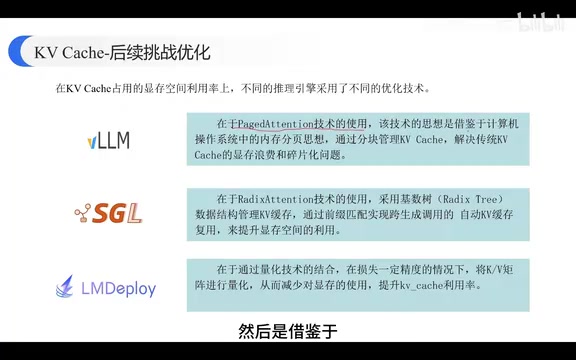
evLLM基于PagedAttention,借鉴操作系统内存分页思想,将物理显存分块管理,用多少映射多少,直接针对碎片化问题。SGLang采用RadixAttention,以树形数据结构管理KV缓存,通过前缀匹配实现共享复用,提升空间利用率。LMDeploy则结合量化技术,将KV Cache的数据类型从float量化为int,在损失一定精度的情况下压缩占用空间。
课程给出的选型建议是优先考虑vLLM。其通用性最强,对主流模型和硬件平台的支持范围远高于另外两者,多数通用推理需求无需针对特定架构改造;生态成熟,集成了在线/离线测试、单kernel性能测试、profiler性能分析以及量化工具;社区活跃,对新模型的支持响应迅速。在吞吐量、延迟、硬件兼容性等维度上表现均衡,适合高并发API服务和通用模型推理场景。
从注意力机制的计算瓶颈,到KV Cache的缓存复用,再到显存碎片与引擎级优化,这条链路构成了理解大模型推理系统的核心线索。掌握KV Cache,也就掌握了推理性能优化的起点。
相关推荐

MiniMax H3开源工作流:低显存也能打造呼吸感皮肤
本文介绍B站UP主分享的MiniMax H3双采样工作流,通过融合模型、破线LoRA和低显存节点,解决AI人物面部油腻问题,并让12G显存设备也能运行。包含模型搭配、双采样逻辑与参数设置详解。

手机本地大模型+ESP32:自制热量提醒器
B站UP主开源了一个热量摄入提醒器项目:手机APP用miniCPM开源模型本地拍照识别食物并估算热量,ESP32小屏幕同步数据,用绿黄红圆环展示摄入状态,可磁吸在冰箱门上随时提醒。

12GB显卡跑125B MoE?Strata三级协同引擎解析
开源C++引擎Strata让12GB-16GB家用显卡本地跑125B MoE模型,生成速度达40-95 Token/s。本文拆解其显存、内存、固态三级协同原理,说明模型选型前提、硬件配置门槛与启动方式。