大模型应用开发实战:函数调用与工具集成环境搭建
本文手把手讲解大模型应用开发第五阶段的项目环境搭建,覆盖虚拟环境、数据库、密钥配置到前后端启动的完整流程。
本文面向想从函数调用与工具集成阶段切入大模型应用开发的开发者,以 B站 UP 主"花菜编程"的教学实录为蓝本,系统梳理了第五阶段项目的完整环境搭建步骤。核心流程包括:在 PyCharm 中将虚拟环境建在 `fastAPI` 后端目录下、修改 `.env` 中的数据库名/MySQL 密码/智谱 API 密钥、运行 SQL 脚本初始化 8 张数据表、前后端依赖并行拉取,以及按"先后端后前端"顺序启动并用 admin 账号验证功能。文章同时指出三个高频踩坑点——虚拟环境路径错位、密钥未替换、PyCharm 目录缓存未刷新,帮助开发者在进入真正有趣的工具集成实战之前稳固打好基础。
大模型应用开发进入第五阶段,内容逐渐从基础铺垫转向实战开发。这一阶段的核心主题是函数调用(Function Calling)与工具集成,为后续的 MCP、RAG、Agent 乃至多 Agent 协同打下基础。本文基于 B站 UP 主(花菜编程)的教学实录,梳理从源码获取到前后端启动的完整环境搭建流程,帮助想从第五阶段切入的开发者快速跑通项目。
阶段定位:从枯燥铺垫到有趣实战
在整个大模型应用开发的学习路线中,前四个阶段多为基础搭建,内容相对枯燥。进入第五阶段后,项目开始真正具备「智能体」的雏形——通过函数调用让大模型能够主动调用外部工具,例如天气查询、时间获取等。
按照作者规划,后续还将涉及 MCP(Model Context Protocol)、RAG(检索增强生成)、Agent 与多 Agent 协同等更高阶的主题。可以理解为,函数调用是让模型「长出手脚」的第一步,它决定了模型能否跳出纯文本对话,去操作真实世界的工具和数据。
对于已经跟完第四阶段的开发者,可直接延续现有代码进入下一步;而想从第五阶段起步的读者,则需要先获取上一阶段结束时的源码(对应教程中的 057 结束源码或 058 起始源码)作为基线。
函数调用(Function Calling) 是大语言模型的一项关键能力扩展:开发者预先定义好若干"工具函数"(如查询天气、获取当前时间、搜索数据库),并将这些函数的名称、参数格式和用途描述一并传给模型。当用户提问触发对应需求时,模型不会直接生成答案,而是输出一段结构化的"调用指令",告知应用层应该调用哪个函数、传入哪些参数。应用层执行函数后,将结果返回给模型,模型再基于真实数据生成最终回复。这一机制打破了纯文本对话的局限,使模型能够与外部 API、数据库乃至操作系统进行实时交互,是构建 Agent(智能体)的核心底层能力。MCP(Model Context Protocol)是 Anthropic 推出的开放协议,旨在标准化模型与外部工具/数据源之间的连接方式,可以理解为函数调用的"标准化接口层";RAG(Retrieval-Augmented Generation,检索增强生成)则通过在推理时动态检索外部知识库来弥补模型知识截止的不足,两者与函数调用共同构成现代 AI 应用的三大基础支柱。
创建虚拟环境:解释器路径是关键
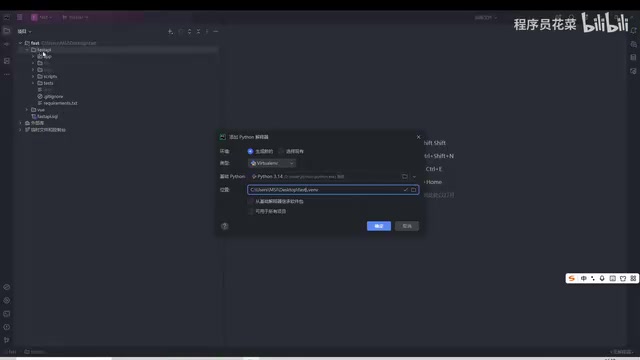
下载源码并解压后,将项目拖入 PyCharm 打开。后端位于 fastAPI 目录下,首要任务是创建独立的虚拟环境。
当 PyCharm 右下角显示「无解释器」时,点击添加新的解释器,选择本地解释器。这里有一个容易踩坑的细节:虚拟环境的位置必须放在后端路径(即 fastAPI 目录)下,需要手动浏览并定位到该文件夹,再在路径后追加 -venv。
确认后等待进度条跑完,正常情况下 fastAPI 目录下会生成 -venv 文件夹。如果没有立即出现,往往是 PyCharm 的缓存刷新问题——关闭项目再重新打开,或多刷新几次目录即可解决。这类卡顿在配置较低的电脑上较为常见,并非配置错误。
Python 虚拟环境(Virtual Environment)的作用是为每个项目创建一套独立的包依赖空间,避免不同项目之间的库版本冲突。PyCharm 会在指定目录下生成一个包含独立 Python 解释器和 site-packages 的文件夹(此处命名为 -venv),项目运行时优先使用该目录内的解释器和依赖,而非系统全局环境。将虚拟环境建在 fastAPI 后端目录下而非项目根目录,是因为前后端分离架构中,后端 Python 依赖与前端 Node.js 依赖完全独立管理——PyCharm 的 Python 解释器只需感知后端目录,这样 requirements 文件的解析和包下载都会自动对应到正确的虚拟环境,不会误将前端目录纳入作用域。
配置数据库与密钥:改成自己的
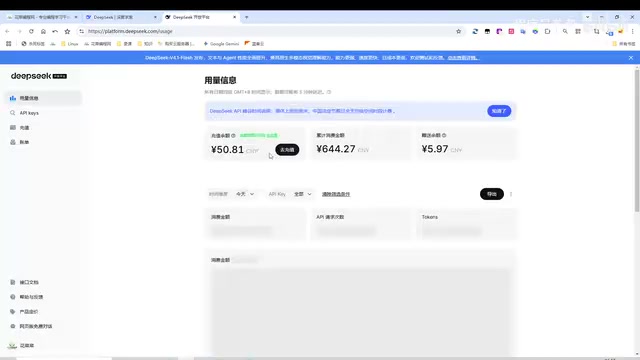
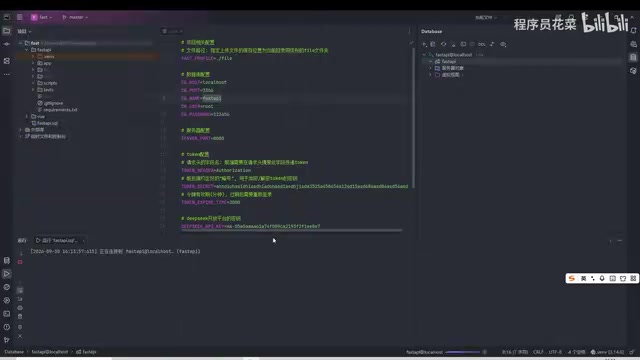
环境就绪后,下一步是准备数据库和 API 密钥。打开 .env 文件,其中包含三个需要修改的关键项:数据库名称(fastAPI)、MySQL 密码,以及智谱(GLM)开放平台的 API 密钥。
密钥获取方式很直接:访问智谱开放平台,充值少量费用后,在 API Keys 页面创建一个新的 Key,复制粘贴到 .env 对应位置即可。作者特别强调,教程中演示的密钥会被删除或替换,读者必须使用自己的密钥,这既是出于安全考虑,也避免调用额度被占用。
接着在 PyCharm 的 Database 面板新建 MySQL 数据源,使用最高权限账号和本机密码,测试连接成功后应用。然后右键新建架构(Schema),命名为 fastAPI,排序规则选择 utf8mb4 系列。最后将数据源的默认数据库指向 fastAPI,再次测试连接确认成功。
初始化数据表与依赖拉取
数据库建好后,需要运行项目自带的 SQL 脚本初始化表结构。在 PyCharm 中右键 fastAPI.sql,选择「运行 SQL 脚本」,定位到解压后的脚本文件执行。运行完成后数据库中应出现 8 张表,这是前几个阶段累积下来的数据模型。
表结构就绪后,进入依赖拉取环节。这里可以并行操作以节省时间:
- 后端依赖:通过 PyCharm 对
requirements/pyproject的可视化方案一键下载 - 前端依赖:在
vue包目录下打开终端,执行npm i(即npm install简写)
两边同时进行,等待进度条跑完即可。前后端依赖分别管理是全栈项目的常规做法,互不干扰。
npm i(即 npm install)会读取前端 vue 目录下的 package.json 文件,将其中声明的所有依赖包下载到本地 node_modules 文件夹。首次拉取时下载量较大(Vue 生态项目通常有数百个间接依赖),在网络条件一般的环境下可能耗时几分钟,与后端 Python 依赖并行下载可有效缩短整体等待时间。如果遇到 npm 下载缓慢的问题,可以在执行前先将 npm 源切换为国内镜像:npm config set registry https://registry.npmmirror.com,之后再运行 npm i 速度会有明显提升。
启动验证:先后端再前端
启动顺序必须是先后端、再前端。在 fastAPI 目录下打开终端,执行启动指令,回车后若终端提示启动成功,可通过 Ctrl + 鼠标左键访问后端地址。看到「你好,恭喜你成功启动了后端」的响应,即代表后端正常运行。
验证通过后,后端终端无需保持可视化访问(返回的 404 多为 favicon.ico 图标请求,可忽略),即可切换到前端启动。在 vue 包目录下执行 npm run dev,浏览器会自动打开登录页。
使用数据库 user 表中的超级管理员账号(用户名 admin,密码 admin123)登录后,用户管理、角色管理、菜单管理、AI 助手聊天等模块应全部可用。在 AI 助手中输入消息(Ctrl + 回车发送),能快速收到「我是花菜编程网的 AI 助手」的回复,说明大模型接口也已正常打通。
小结:为工具集成做好准备
至此,第五阶段的项目环境已完整跑通。这一阶段的搭建虽然仍属「准备工作」,但它是函数调用与工具集成的前提——只有后端服务、数据库和大模型接口三者都稳定运行,才能在后续课程中为模型接入天气工具、时间工具等外部能力。
整个流程中最容易出问题的三个点值得再次提醒:虚拟环境必须建在后端目录下、.env 中的密钥务必替换成自己的、以及 PyCharm 目录不刷新时的缓存处理。把这些细节处理好,就能顺利迈入真正有趣的工具集成实战。
相关推荐
MCP联合创造者:智能体需要的是连接性,而非更强模型
MCP联合创造者David Soria Parra在演讲中指出,决定智能体未来的是连接性与开放标准,而非更强的模型。本文梳理模型能力演进、编程Agent落地逻辑、MCP的无状态改造及Tasks、Skills、身份授权等未来路线图。
SageMaker新技能上线:为编码智能体赋能生成式AI推理优化
Amazon SageMaker 推出 aws-ai-ml 新技能,通过 Agent Toolkit for AWS 为 Kiro、Claude Code、Codex 等编码智能体注入生成式AI推理优化专长,支持自然语言生成可执行的 SageMaker Python SDK v3 代码完成基准测试、推荐与对比。
Claude Code 登陆 AWS GovCloud:合规监管工作负载的 AI 编程新选择
Anthropic Claude Opus 5.5 与 Sonnet 5.5 登陆 Amazon Bedrock 的 AWS GovCloud (US) 区域,支持 Claude Code 智能体编程,为 ITAR 等受监管工作负载提供合规对齐的 AI 辅助开发能力。