datasette-llm 0.1a11 发布:接入任意 OpenAI 兼容本地模型

datasette-llm 0.1a11 支持 OpenAI 兼容端点,可接入本地模型驱动 Datasette Agent。
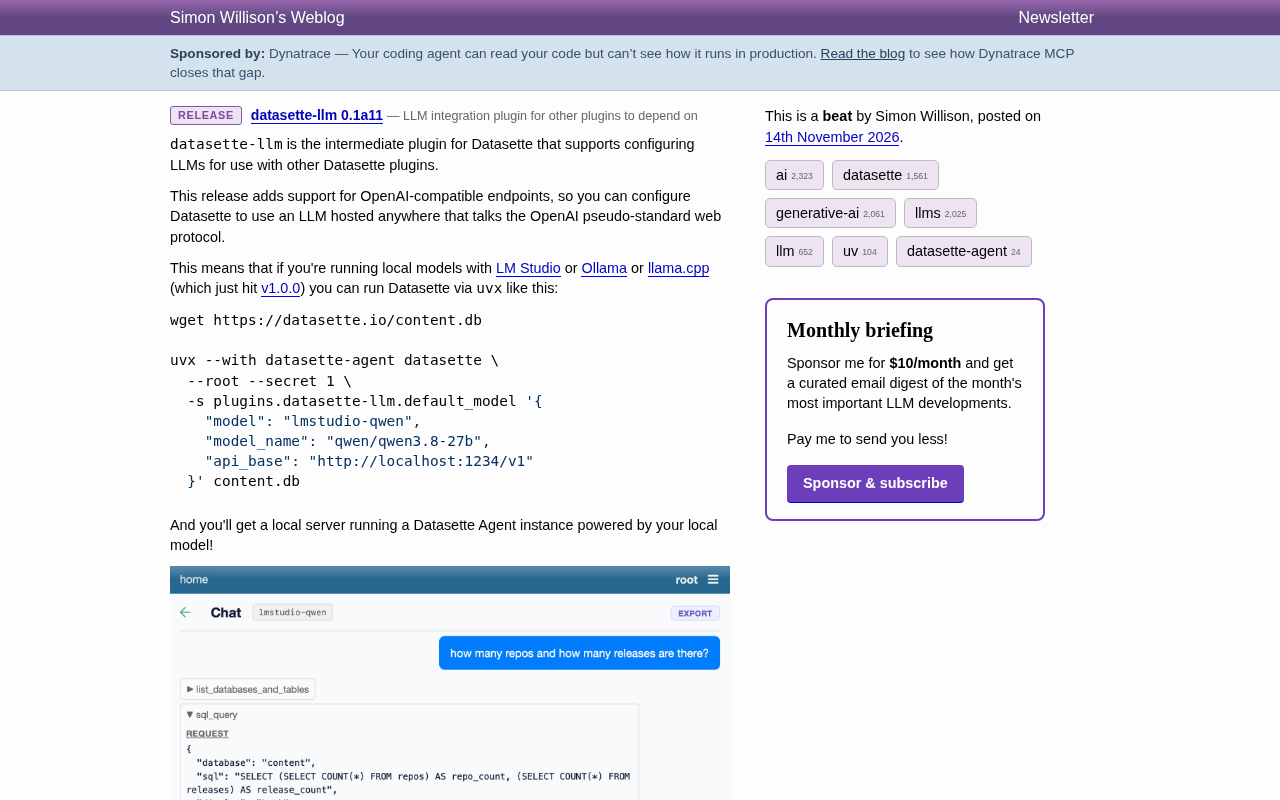
datasette-llm 是 Datasette 生态中的中间层插件,统一为上层插件配置 LLM,本身不提供对话界面。0.1a11 版本新增对 OpenAI 兼容端点的支持,意味着任何实现该协议的模型服务都能作为 Datasette 的后端,包括 LM Studio、Ollama 和 llama.cpp 上运行的本地模型。官方示例用一条 uvx 命令完成安装、配置与启动,通过 default_model 设置指定模型别名、实际模型标识与本地 api_base 地址。截图显示 datasette-agent 借助工具调用先探索 schema 再生成 SQL,直接回答数据库统计问题,用户无需手写 SQL。这一改动的意义在于把模型选择权扩展到整个本地推理生态,兼顾数据隐私与成本,同时保持上层插件交互逻辑不变。
一次小版本更新,打通本地模型与 Datasette 的最后一公里
datasette-llm 是 Datasette 生态中的中间层插件,负责为其他 Datasette 插件统一配置 LLM。它的定位很明确:不直接面向最终用户提供对话界面,而是作为「模型配置中枢」,让上层插件(例如 datasette-agent)能够复用同一套模型设置。
0.1a11 这个版本的核心变化只有一个,但影响面不小:新增对 OpenAI 兼容端点的支持。换句话说,只要某个服务实现了 OpenAI 那套「伪标准」的 Web 协议,Datasette 就能把它配置为后端模型。官方博文明确指出,这意味着你可以把 LM Studio、Ollama 或 llama.cpp 上运行的本地模型接进 Datasette。
为什么 OpenAI 兼容协议值得单独支持
过去,Datasette 接入模型往往依赖特定厂商的 SDK 或直连 API。而 OpenAI 的聊天补全接口事实上已经成为本地推理工具的通用语言——LM Studio、Ollama、llama.cpp 都提供 /v1 风格的兼容层。datasette-llm 支持这类端点后,用户不再需要等待插件为每个推理框架单独适配,只要工具说「OpenAI 协议」,就能被 Datasette 识别。
这也降低了隐私与成本方面的顾虑:模型跑在本机,数据不出本地,同时省去云端 API 的调用费用。对于需要把数据库内容交给模型分析、又不愿外传数据的场景,这一点尤其关键。
OpenAI 兼容端点指的是某个服务仿照 OpenAI 的 /v1/chat/completions 等 HTTP 接口所实现的 Web 协议,请求体与响应体沿用 OpenAI 的 JSON 结构(如 messages 数组、choices 返回项、role/content 字段)。由于 OpenAI 早期接口被大量工具链采纳,这套格式逐渐成为事实上的通用方言,业界常称之为「伪标准」——它并非正式规范,但因为生态惯性而被广泛实现。LM Studio、Ollama、llama.cpp 的 server 模式都内置了这一兼容层,因此一个客户端只要按此协议发请求,就能在不改动代码的前提下切换后端模型。
对插件开发者而言,支持兼容端点的收益是适配成本从「N 个框架各写一套」降为「只写一套」。代价则是兼容层往往只覆盖核心字段,流式响应、工具调用(tool/function calling)、结构化输出等高级能力在不同实现间可能存在细微差异,接入时需以实际推理框架的文档为准。
一条 uvx 命令跑起本地 Agent
官方给出的示例非常直接:先下载示例数据库,然后用 uvx 拉起 Datasette,并通过插件设置传入模型配置。
wget https://datasette.io/content.db

uvx --with datasette-agent datasette \
  --root --secret 1 \
  -s plugins.datasette-llm.default_model '{
    "model": "lmstudio-qwen",
    "model_name": "qwen/qwen3.8-27b",
    "api_base": "http://localhost:1234/v1"
  }' content.db
配置项里有三个关键字段:model 是本地给这个模型起的别名,model_name 对应推理框架中的实际模型标识,api_base 指向本地服务的 OpenAI 兼容地址(示例中是 LM Studio 默认的 1234 端口)。启动后,Datasette Agent 就会用这个本地模型驱动对话。
对习惯命令行的开发者来说,这套流程几乎没有学习成本:不用改配置文件,不用写 Python 代码,一条 uvx 命令即可完成从安装到运行的闭环。
uvx 是 Python 包管理工具 uv 提供的命令,作用类似 pipx run:它会在隔离的临时环境中解析并安装指定包及其依赖,然后直接执行入口命令,无需事先 pip install,也不会污染当前项目的虚拟环境。示例中的 --with datasette-agent 表示在同一个临时环境里额外装入 datasette-agent 插件,使 Datasette 启动时能加载它。
-s plugins.datasette-llm.default_model 则是 Datasette 的设置覆盖语法:-s(即 --setting)按点分路径写入配置,等号后是 JSON 值,从而在不修改配置文件的情况下把默认模型指向本地端点。--secret 1 用于提供签名密钥,--root 授予全部权限,二者都是让 Agent 正常读写数据库与执行工具调用的前提。这种「命令行即配置」的方式便于快速试用,但生产环境更建议写入配置文件或使用环境变量。
实际效果:自然语言直接查询 SQLite
官方附带的截图展示了这个组合的工作方式。界面是一个聊天窗口,顶部标注当前模型为 lmstudio-qwen。用户提问「how many repos and how many releases are there?」,Agent 先折叠展示了一次 list_databases_and_tables 工具调用,随后展开 sql_query 调用,REQUEST 部分可以看到它针对 content 数据库生成了带子查询的 SQL,分别统计 repos 与 releases 的数量。
RESPONSE 返回两列结果,最终表格显示 repo_count 为 200、release_count 为 1889,助手据此回答「content 数据库中有 200 个仓库和 1,889 个发布」。整个过程里,用户没有手写任何 SQL,模型通过工具调用完成 schema 探索、查询生成和结果解读。
这个例子说明 datasette-llm 的价值不只在「能连模型」,而在于它让 datasette-agent 这类上层插件具备了可替换的推理后端。换模型只需改一行配置,交互逻辑和工具链保持不变。
截图里出现的 list_databases_and_tables 与 sql_query 属于**工具调用(tool calling / function calling)**机制:模型并不直接执行代码,而是先输出一个结构化的「我要调用某工具、参数是什么」的意图,由宿主程序(这里是 datasette-agent)负责实际执行,再把结果作为一条新消息回传给模型。
这种「模型提议、程序执行」的分工有几个好处:数据库访问受宿主控制,可以施加只读、行数限制等安全策略;执行结果可被记录与审计;模型也不必具备直接访问文件系统的能力。代价是流程变成多轮往返,一次回答可能触发多次工具调用,延迟与 token 消耗随之上升。示例中 Agent 先探索 schema 再生成 SQL,正是典型的「先看表结构、再写查询」两段式推理。
对 Datasette 生态的意义
Datasette 一直强调「把数据变成可探索、可发布的东西」,而 LLM 插件层让这种探索多了一种入口:自然语言。datasette-llm 作为中间件,把模型选择权交还给用户——你可以用云端大模型,也可以用本地小模型,取决于数据敏感度和硬件条件。
新增 OpenAI 兼容端点支持,实质上是把这个选择权扩大到了整个本地推理生态。考虑到 llama.cpp 近期发布 v1.0.0、本地模型工具链日趋成熟,这类兼容层支持会越来越成为数据工具的标配能力。对于想把 AI 查询能力嵌入内部数据平台、又受限于合规要求的团队,这个版本提供了一条低门槛的验证路径。
目前该版本仍处于 0.1a 阶段的 alpha 版本,接口和配置方式可能继续调整。但从功能方向看,datasette-llm 正在把「模型可插拔」这件事做得越来越彻底。
相关推荐

Claude Mythos 5.2 与 Fable 5.2 错误率异常升高
Claude Mythos 5.2 和 Claude Fable 5.2 出现请求错误率异常升高,官方状态页已标记为调查中。本文梳理事件概况、对开发者的实际影响及应对建议。

ReAct运行时上下文裁剪:Claude Code为何70%就动手
深入解析ReAct运行时的上下文裁剪机制:为什么Claude Code在上下文使用约70%时就触发压缩,工具调用为何占用最多、为何必须成组丢弃,以及代码库为何不需要RAG。基于B站小福哥《分币不掏,学习AI Agent开发》第17节整理。

AI Agent vs LLM:Cursor和Claude Code如何真正工作
深入解析AI Agent与LLM的本质区别:LLM生成代码建议,Agent则通过工具调用修改文件、运行测试。以Spring Boot Bug修复为例,拆解Cursor和Claude Code的工作流、权限控制与验证机制。