DeepSeek从入门到精通:V3与R1模型全解析及实战避坑
DeepSeek凭开源、免费、高性能崛起,需按场景切换V3与R1。
本文系统梳理了DeepSeek的五个关键词——AI、国产、免费、开源、强大,指出开源与免费商用是其区别于闭源模型的核心优势。文章区分了V3通用模型与R1推理模型的分工:V3适合日常任务,R1擅长数学、编程等逻辑密集场景,两者是场景差异而非版本替代。R1性能媲美OpenAI O1,但API价格差出量级,且完全开源。实战中R1编程体验不输Claude和Copilot。文章还提醒新手避免全程开启R1处理简单任务,应按场景切换模型。
DeepSeek的爆火让很多非技术用户第一次真正用上了顶级大模型。但在短视频和新闻推送的碎片信息之外,它的技术脉络、模型差异和使用逻辑值得系统梳理。这篇内容基于B站UP主的保姆级教程,结合多平台创作者的共识,帮你理清DeepSeek到底是什么、怎么用、以及为什么它值得成为你日常工作的主力工具。
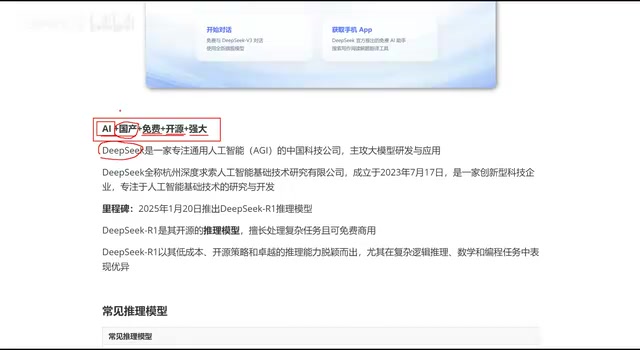
DeepSeek的五个关键词:AI、国产、免费、开源、强大
据B站UP主在教程中的拆解,理解DeepSeek广告可以从五个关键词入手:AI、国产、免费、开源、强大。这五个词并非简单的标签堆砌,而是构成了它在国内能否被广泛使用的底层逻辑。
ChatGPT横空出世时确实轰动了全球,但国内大部分用户因为网络受限,并没有第一时间体会到它的能力。国内大厂随后推出的各种大模型虽然不少,但与GPT系列相比仍有明显差距,未能引发同等量级的轰动。DeepSeek的不同之处在于,它是一家足以匹配OpenAI的中国公司,同时因为“国产”和“免费”,普通用户下载APP或访问网页就能直接体验。
“开源”则是另一个关键分水岭。据B站UP主和YouTube科技频道的交叉分析,OpenAI的O1推理模型是闭源的,而DeepSeek R1足以媲美O1,却完全开源。开源意味着更长的技术生命周期和更广泛的商业复用空间——官方明确支持免费商用,企业可以直接拿来用。
开源大模型指模型权重、架构甚至训练细节对外公开,允许任何人下载、修改和再分发。与闭源模型(如OpenAI的GPT-4、O1)只能通过API调用不同,开源模型可以被企业私有化部署,数据不出本地,也便于针对特定领域微调。DeepSeek R1采用MIT许可证,明确允许免费商用,这在顶级推理模型中极为罕见。开源还意味着社区可以审查模型行为、复现结果,并在此基础上构建衍生工具,从而加速技术迭代和生态繁荣。
两家模型的分工:V3通用模型与R1推理模型
DeepSeek有两个核心模型:V3通用模型和R1推理模型。很多新手容易把它们理解为“谁更高级”的关系,但据UP主强调,这是应用场景的差异,而非上下级替代。
V3面向日常任务处理,比如做个表格、问基础常识、整理资料,这类不含复杂逻辑链的工作直接输入即可。R1则擅长需要多步推理的场景,比如数学题、写代码、逻辑分析。在网页版中,用户需要手动点亮“深度思考R1”开关,才能调用推理模型。
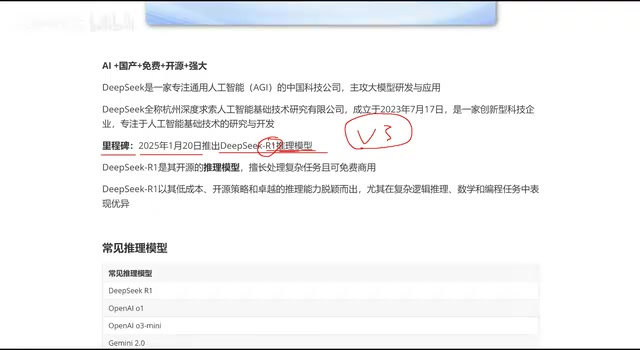
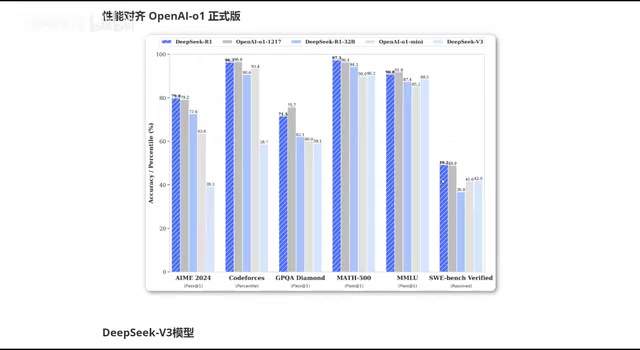
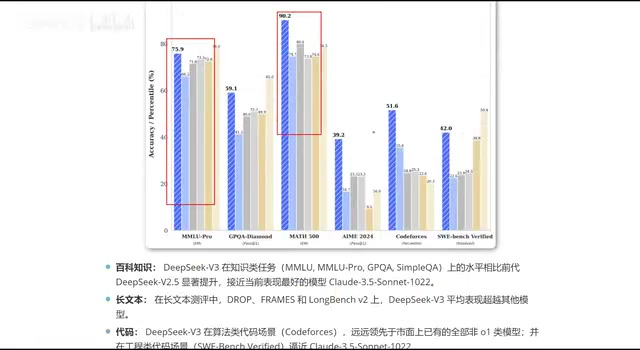
据官方发布的性能对比图,R1与OpenAI O1在各项基准上基本不分伯仲。而在V3与GPT-4o、Claude 3.5的对比中,V3在百科知识上接近Claude,长文本处理上超越其他模型,代码能力逼近Claude,数学方面则大幅领先当时所有的开源与闭源模型。UP主也坦言,V3在中文能力上与表现最好的模型相比仍有差距,官方对此并不避讳——这种坦诚本身也是技术自信的体现。
推理模型(如DeepSeek R1、OpenAI O1)与通用模型(如V3、GPT-4o)的核心区别在于是否在输出答案前进行显式的多步思考。推理模型会生成较长的内部推理链(思维链),逐步分解问题、验证假设,再给出最终答案,因此更擅长数学证明、复杂代码调试和逻辑谜题。代价是响应速度较慢、token消耗更高。通用模型则直接生成回答,适合事实问答、文本整理等轻量任务。在DeepSeek网页版中,开启“深度思考R1”开关即调用推理模型,关闭则使用V3,用户可根据任务复杂度灵活切换。
实战体验:编程场景下不输Claude,价格差出量级
据UP主自述,他过去一两年大量使用Claude辅助编码,也在VS Code中用过集成的Copilot,体验都很好。但切换到DeepSeek之后,感受上并没有明显落差,甚至在日常搜索和代码编写中开始全面替代原有工具。这一体验与多位开发者在社区中的反馈一致:R1在代码任务上的反馈质量非常优异。
成本是另一个决定性因素。官网API开放平台的产品定价显示,R1与O1的价格差距达到很多倍。官方新闻页也披露了各版本的时间线:V2于24年19月(原文如此)发布,R1于24年11月发布,V3于24年12月发布正式版,R1正式版于25年1月12号发布——真正引爆市场的正是这个1月版本。
UP主还提到一个被广泛讨论的数据:R1的训练成本当时号称仅花了570万美元。这个数字本身在技术社区存在不同解读,但它传递的信号很明确——低成本、高性能、开源的组合,正在改变大模型的竞争格局。
API(应用程序编程接口)是开发者将模型能力集成到自己应用中的方式,按使用量(token数)计费。DeepSeek开放平台的API价格远低于OpenAI同类模型,R1的输入/输出价格约为O1的几十分之一,这使得批量处理、自动化工作流等场景的成本大幅降低。对于企业而言,API还支持私有数据对接和定制化开发,而网页版仅面向个人交互。理解API与网页版的能力边界,有助于在需要规模化处理时选择正确的接入方式。
使用场景的转变:从搜索引擎到AI对话
教程中有一段观察值得注意:过去遇到不懂的问题会问百度、必应,现在思维完全转换了,直接打开DeepSeek或ChatGPT的APP和网页去问。这种习惯迁移不是个例。UP主提到,不少公司甚至政府机构都在要求员工使用AI产品提升工作效率,因为市场环境下的产出压力在持续增大。
这也解释了为什么“会用AI”正在从加分项变成基础项。DeepSeek的免费策略降低了门槛,但真正拉开差距的是能否根据任务类型正确选择V3或R1——日常琐事用V3图快,逻辑密集的任务点亮R1求准。这个简单的切换动作,是多数新手最容易忽略的避坑点。
常见误区与避坑提示
据多源分析,新手最常见的三个误区是:把R1当成默认模型全程开启,导致简单任务响应变慢;把V3和R1理解成版本新旧关系,错过通用模型在轻量任务上的效率优势;以及忽视API与网页版的能力边界差异,在需要批量处理时仍手动操作。厘清模型分工、按场景切换,比盲目追求“最强模型”更实际。
DeepSeek的崛起不是单点突破,而是开源策略、成本结构和模型能力的组合结果。对普通用户而言,理解这层逻辑,比记住几个提示词技巧更有长期价值。
思维链(Chain-of-Thought)是推理模型在内部生成的逐步推理过程,用户通常只能看到最终答案,但部分平台允许查看中间步骤。思维链越长,模型消耗的token越多,响应时间也越长。对于简单查询(如“今天天气”),强制开启推理模型会导致不必要的延迟和算力浪费。因此,根据任务复杂度动态切换模型,是高效使用DeepSeek的关键技巧。
相关推荐
Gemini 4 Hydrogen发布:速度提升2.5倍的日常AI模型
Google发布Gemini 4 Hydrogen,宣称比Gemini 3.8 Flash快2.5倍,支持四级思考控制、百万token上下文和Orchestrator多模型协作,API定价每百万输入token 1.50美元。
Gemini 4 Hydrogen实测:谷歌最快最便宜AI模型
谷歌 Gemini 4 Hydrogen 实测:Gemini 4 家族中最快最便宜的模型,解析 Carbon/Argon/Hydrogen 分工、API 定价陷阱、免费层限制与四档思考等级的成本取舍,附真实 bug 调试演示。

Gemini 4 Hydrogen 对比测试:仅耗1%周配额,表现不输Sonnet
实测Gemini 4 Hydrogen与Sonnet完成同一CRUD任务:Hydrogen仅耗1%周配额,表现相当且UI细节更优,而Anthropic模型耗7%。开发者建议日常任务不必迷信高价模型。