Gemini 4 Hydrogen实测:谷歌最快最便宜AI模型
谷歌 Gemini 4 Hydrogen 以最快最便宜定位切入日常编程与智能体任务,思考等级选择直接决定成本与效果。
谷歌悄然上线 Gemini 4 Hydrogen,与 Carbon、Argon 共同构成 Gemini 4 三层架构。Hydrogen 定位最快最便宜,主打日常编程和智能体工作流。第三方榜单 Artificial Analysis 上它得分 51,略超更大的 Argon(50),远高于旧款 Gemini 3.8 Flash(31)。成本方面,thinking tokens 计入输出账单是费用膨胀的主因,可通过自动缓存、批量/Flex 模式和免费层降本,但免费层数据可能被用于产品改进,不适合敏感数据。实测中 Hydrogen 在数十秒内准确定位 Express 登录路由 500 错误的根因。四档思考等级里,x-high 比 high 贵约 70%、耗时近乎翻倍,却在 Terminal Bench 4.0 上与 high 得分相同,编程任务并无额外收益,建议按任务难度选择 low 至 high。
Gemini 4 Hydrogen 实测:谷歌最快最便宜的 AI 模型
谷歌悄悄上线了一款新模型,名字叫 Gemini 4 Hydrogen。多数人可能已经在用而不自知——谷歌搜索面向全球用户,底层跑的就是它。本文从四个维度拆解:它是什么、真实成本多少、哪里能用、以及实测表现如何。
Hydrogen 是什么:Gemini 4 的三层架构
Gemini 4 目前包含三个模型,以元素命名:Carbon、Argon 和 Hydrogen。
Carbon 是谷歌最强的推理模型,面向复杂软件工程、研究和网络安全场景;Argon 是更注重效率的前沿模型;Hydrogen 则是三者中最快、最便宜的一个,谷歌为"日常编程"和"智能体工作流"量身打造。
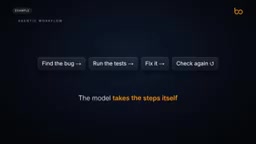
所谓智能体工作流,指的是 AI 不只是回答问题,而是自行推进步骤:找 bug、跑测试、修复、再验证。用一句话概括三者的分工——Carbon 是资深架构师,负责制定计划;Hydrogen 是快速开发者,负责执行计划。
Hydrogen 的上下文窗口支持一次性喂入整个小型代码库或长篇 PDF,输入侧支持文本、图像、音频、视频和 PDF 多模态。
性能:独立榜单上的表现
先看第三方数据。Artificial Analysis 是一家用统一测试横向对比模型的独立网站,在其 Intelligence Index 上,Hydrogen 得分 51,默认设置下的 Argon 得分为 50,旧款 Gemini 3.8 Flash 仅有 31。
谷歌自家的 Terminal Bench 4.1(针对终端内真实编程任务)上,官方也给出了成绩。此外谷歌声称,包含错误事实的回答数量大幅减少——这属于厂商自报数据,建议在自己的任务上实测验证。
对开发者最直接的信号是:Hydrogen 在独立排名中略超谷歌自家更大的 Argon 模型,却便宜得多。
Artificial Analysis Intelligence Index 是一个由独立机构 Artificial Analysis 维护的模型能力综合评分。它并非单一测试,而是将多个标准化基准(覆盖推理、知识、编程、数学等维度)的结果归一化后加权汇总成一个分数,便于跨厂商、跨代际横向比较。该榜单的特点在于同时公布性能与成本数据,包括每次任务的平均费用和耗时,因此常被用来评估"性价比"而非单纯的能力上限。由于各厂商的官方跑分往往选择有利的测试条件,第三方独立榜单的价值在于用统一设置复现测试,减少选择性报告带来的偏差。不过,任何综合指数都会掩盖具体任务上的差异,分数接近时(如 51 与 50)不宜过度解读为绝对优劣,仍应结合自身场景实测。
成本:账单主要花在输出上
API 定价按输出计费。粗略估算,一万次请求的总花费大约在几十美元量级;但有一个关键陷阱:模型内部思考产生的 thinking tokens 同样计入输出账单。如果思考过程让每次输出膨胀到数千 token,总费用会成倍上涨。换句话说,账单主要来自输出而非输入。
有三种方式压成本:
- 缓存:若每次请求携带相同的系统提示词,重复输入部分按极低费率计费,Hydrogen 上的缓存是自动开启的。
- 批量或 Flex 模式:对时效要求不高的任务(比如夜间批量摘要文档),价格直接减半。
- 免费层:AI Studio 中 Hydrogen 提供免费层,Carbon 和 Argon 则没有。
作为对比,Carbon 和 Argon 当前的定价为输入 $2、输出 $10,并且宣布将上调至输入 $4、输出 $20——Hydrogen 的价格优势会进一步拉大。
免费层的代价
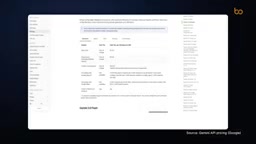
谷歌定价页面明确写着:免费层上你的数据可能被用于改进谷歌产品,付费层则不会。所以免费层适合练习和业余项目,公司代码、API 密钥和用户个人数据不要放进免费层。
thinking tokens(思考 token) 是推理型模型在给出最终答案前生成的内部推理内容所消耗的 token。与普通输出不同,这些 token 通常不被用户直接看到(或仅以折叠形式展示),但 API 计费系统会将其计入输出侧账单。原因在于,模型为了"想清楚"而生成的每一步推理,本质上都是在进行自回归生成,消耗的算力与生成可见回答相同。因此,当模型被设置为较高的思考等级(如 high 或 x-high)时,单次请求的输出 token 数可能从几百膨胀到数千,费用随之成倍增长。不同厂商对 thinking tokens 的计费策略略有差异,有的将其单列为"推理 token",有的直接并入输出 token 计价,但共同点是:它们都不是免费的。控制成本的关键,在于根据任务难度选择合适的思考等级,避免让简单任务触发冗长的内部推理。
缓存(prompt caching) 是一种针对重复输入内容的计费优化机制。当多次 API 请求携带相同的前缀内容(例如固定的系统提示词、长文档、代码库上下文)时,服务商可以将这部分内容的计算结果缓存起来,后续请求命中缓存的部分按远低于正常输入的价格计费,通常可低至原价的十分之一甚至更低。缓存的有效期从几分钟到数小时不等,具体取决于服务商策略。对于智能体工作流尤其有价值:这类任务往往在每轮调用中都重复附带同一套指令和背景资料,缓存能显著压低输入侧开销。需要注意的是,缓存只优化输入,不改变输出侧(含 thinking tokens)的计费逻辑,因此它无法解决输出膨胀带来的成本问题,两者需要配合使用。
在哪里用:搜索、App 与开发工具
即使你不是开发者,也已经在用它:谷歌搜索中所有用户都已切换到该模型;Gemini App 的模型选择器里有它,免费用户会在系统判断"这个提示适合它"时自动选中。
开发者可以在 Gemini API、Google AI Studio、Android Studio 以及 Google Antigravity 中调用。付费的 AI Pro 或 Ultra 订阅用户还能用到一个新的编排器功能:Carbon 负责规划,Hydrogen 像小智能体一样执行并核验结果。按谷歌说法,这一组合能以更低的配额消耗达到接近 Carbon 的成功率。
实测:思考等级怎么选
在 AI Studio 里选择 Gemini 4 Hydrogen(模型 ID 为 gemini-4-hydrogen),右侧可设置思考等级,默认是高。
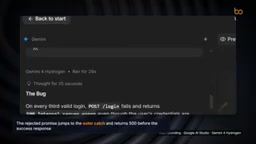
我用一段真实带 bug 的 Express API 代码测试:登录路由偶尔返回 500 错误。提示词很简单——找 bug、解释原因、给出修复代码。模型先思考再作答,在数十秒内给出了答案,并准确指出根因:记录登录指标的异步函数每第三次调用会向 metrics 服务抛超时错误;这个被拒绝的 Promise 让控制流直接跳进外层 catch 块,还没等登录成功的 JSON 响应发出就中断了。
Hydrogen 提供四档思考等级:low、medium、high,以及新增的 x-high。直觉上 x-high 效果最好,但数据不这么说。Artificial Analysis 的测试中,high 得分 51、单项成本 1.87 美分;x-high 得分 54,但成本 3.16 美分,高出约 70%,耗时从 8.4 分钟拉长到 14.8 分钟。而在 Terminal Bench 4.0 的编程测试上,high 和 x-high 得分相同,都是 54%——多花的钱和时间没有换来提升。反观 low:单项任务仅 0.29 美分、1.4 分钟。
我自己用 x-high 跑同一任务,十二秒左右返回,输出约两千 token,结果与 high 相差无几。
实用规则很简单:
- 简单任务(文本分类、抽取 JSON)用 low 或 medium
- 调试和智能体类任务用 high
- x-high 只在你亲自测试确认对任务有帮助时再开
Terminal Bench 是评估模型在真实终端环境中完成编程任务能力的基准测试。与只生成代码片段的传统编程题库不同,Terminal Bench 让模型在模拟的命令行环境里操作:读取文件、运行命令、执行测试、根据报错迭代修复,最终以任务是否真正完成来判定成败。这类测试更贴近智能体工作流的实际形态,因此常被用来衡量模型"动手做事"的能力,而非仅仅"写对代码"。不同版本(如 4.0 与 4.1)在任务集和难度上有所调整,跨版本分数不宜直接比较。文章中提到 high 与 x-high 在 Terminal Bench 4.0 上得分相同,说明在该基准覆盖的任务类型上,更高的思考预算并未转化为更好的完成率,这也是评估思考等级收益时的重要参考。
一句话总结
Hydrogen 是 Gemini 4 家族里最便宜的成员,面向日常编程与智能体任务;一万次聊天机器人请求的成本在几十美元量级,前提是想清楚再选思考等级。建议花二十分钟在 AI Studio 里拿一个带 bug 的函数分别跑 high 和 low,对比 token 计数——哪个等级够用,你的账单会告诉你。
相关推荐
Gemini 4 Hydrogen发布:速度提升2.5倍的日常AI模型
Google发布Gemini 4 Hydrogen,宣称比Gemini 3.8 Flash快2.5倍,支持四级思考控制、百万token上下文和Orchestrator多模型协作,API定价每百万输入token 1.50美元。

Gemini 4 Hydrogen 对比测试:仅耗1%周配额,表现不输Sonnet
实测Gemini 4 Hydrogen与Sonnet完成同一CRUD任务:Hydrogen仅耗1%周配额,表现相当且UI细节更优,而Anthropic模型耗7%。开发者建议日常任务不必迷信高价模型。

Gemini 4 Neon发布:多项基准超越Opus 5.5,谷歌重回第一梯队
谷歌DeepMind发布Gemini 4 Neon,Artificial Analysis智能指数61分排名第三,编程指数登顶第一,多项基准超越Opus 5.5,定价每百万token输入3美元输出15美元,已在Gemini API和AI Studio开放。