Gemini 4 Hydrogen发布:速度提升2.5倍的日常AI模型
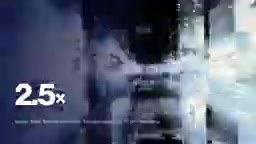
Gemini 4 Hydrogen 以 2.5 倍速度、四级思考控制与 Orchestrator 协作切入日常任务
Gemini 4 Hydrogen 是 Gemini 4 家族中面向日常生产力的快速模型,与负责深度推理的 Carbon、Argon 形成角色分工。官方数据显示,它在默认高思考等级下比 Gemini 3.8 Flash 快约 2.5 倍,在 Terminal Bench 4.1 编码基准上同样达到 2.5 倍速度提升。它提供 low、medium、high、extra-high 四级思考控制,让用户按任务复杂度在速度与推理深度之间取舍,并支持最高一百万 token 的上下文窗口,便于处理大型代码库与长文档。同步推出的 Orchestrator 让 Carbon 负责规划、Hydrogen 负责执行,Google 自评显示成功率接近单用 Carbon,配额消耗减少约 24%、速度提升约 19%。API 定价为每百万输入 token 1.50 美元、输出 7.50 美元。
Google 的 Gemini 4 家族迎来了一位新成员——Gemini 4 Hydrogen。与追求深度推理的旗舰模型不同,Hydrogen 的核心目标只有一个:把日常任务做得更快、更便宜。官方宣称它在默认高思考等级下比 Gemini 3.8 Flash 快约 2.5 倍,并带来了四级思考控制、百万级 token 上下文窗口以及让多个模型协同工作的 Orchestrator 机制。
一个家族,三种角色分工
Gemini 4 家族目前包含三个定位不同的模型:Carbon 是面向复杂推理与规划的前沿模型,Argon 提供另一种高强度工作的选择,而 Hydrogen 则被定位为快速、高效的日常生产力工具。Google 的意图很明确——不是让 Hydrogen 取代 Carbon,而是在写邮件、查表格、修代码错误、准备报告这类"要快不要深"的场景中,给用户一个更轻量的选项。
这种分工思路有点像团队协作:Carbon 负责制定方案,Hydrogen 负责快速执行。用户不必为了挂一幅画而开来一台起重机,这也是四级思考等级设计的出发点。
速度与编码能力的双重提升
Google 公布的性能数据集中在两个维度。其一是整体任务速度:Hydrogen 在默认高思考等级下完成任务的速度约为 Gemini 3.8 Flash 的 2.5 倍。其二是编码基准表现:在 Terminal Bench 4.1 上,Hydrogen 的速度同样达到 Gemini 3.8 Flash 的 2.5 倍。该基准测试模型使用计算机终端完成任务的能力,包括操作文件、运行命令和解决软件问题。
这些数字说明 Hydrogen 不只是"旧模型的加速版",它在复杂任务完成能力上也有可观进步。不过实际表现仍取决于具体任务和所接入的工具,基准成绩不能直接等同于生产环境中的体验。
Terminal Bench 是一个评估 AI 模型在真实终端环境中操作能力的基准测试集,任务涵盖文件系统操作、命令行工具调用、软件包安装与问题排查等。它要求模型通过多轮命令交互逐步推进任务,而不是一次性输出答案,因此既考验推理规划能力,也考验对命令结果的实时纠错能力。基准成绩通常以任务成功率和端到端耗时两个维度呈现,本文所说的 2.5 倍速度即指在相同任务集上的完成时间对比,而非单纯的 token 生成吞吐。
四级思考控制:按需分配算力
Hydrogen 提供 low、medium、high、extra-high 四档思考等级,让用户在速度与推理深度之间自行权衡。写一封简短邮件或总结文档,low 或 medium 通常就够用;分析大型数据集、调试复杂软件或规划多步骤项目时,则可以切到 high 或 extra-high。
这种设计的价值在于避免"一律拉满算力"的浪费。多数日常任务并不需要最深的推理链,按任务复杂度匹配思考等级,既能控制延迟,也能控制成本。
百万 token 上下文:大项目的便利与边界
Hydrogen 支持最高一百万 token 的上下文窗口。对开发者而言,这意味着可以把更多代码文件一次性放进同一个任务里,不必反复拆分;对企业用户来说,则可以一次性审阅长报告、对比多份文档、整合多来源信息。
需要清醒看待的是,上下文窗口大并不等于理解能力强。信息本身的质量、以及模型在长上下文中保持注意力的能力,仍然是决定输出质量的关键因素。
Token 是模型处理文本的基本计量单位,英文中大致 1 个 token 对应 0.75 个单词,中文则通常约 1 至 2 个汉字;代码由于符号和缩进较多,token 消耗往往高于自然语言。一百万 token 大致相当于数千页文本或多达数百个中等规模的源码文件。需要注意的是,上下文窗口描述的是"可同时放入"的上限,而模型在超长输入中检索和利用信息的能力通常随位置变化,位于中部的内容容易被忽略,这也是长上下文仍需配合精确检索与分段策略的原因。
Orchestrator:让 Carbon 和 Hydrogen 组队
与 Hydrogen 一同亮相的还有 Google Anti-Gravity 中的 Orchestrator 功能。它允许不同模型分工协作:Carbon 负责分析需求、制定详细计划,Hydrogen 负责写代码、改文件、跑测试;遇到难题时任务可以交回 Carbon 继续推理,解决后再回到 Hydrogen 执行。
Google 报告的评估数据显示,Orchestrator 方案的任务成功率接近单独使用 Carbon,同时配额消耗减少约 24%、任务完成速度提升约 19%。这些数字来自 Google 自身的评测,并不保证在每个项目中都能复现同样的收益,但它指出了一个方向:按模型强项拆分工作,比让最强模型包办每一步更经济。
Orchestrator 属于模型编排(model orchestration)模式的实践,即由调度层根据任务阶段把子任务分派给不同能力与成本的模型。相比单模型包办全流程,编排的价值在于把高成本的深度推理限制在真正需要的环节,其余执行型工作交给更快更便宜的模型完成。这类方案的关键难点是任务拆分粒度、上下文交接时的信息保真以及失败回退策略,评测中出现约 24% 配额节省和 19% 速度提升,正是拆分得当与回退开销之间取得平衡的结果。
编码与日常业务场景
软件开发是 Hydrogen 的重点方向。它可以检查现有文件、定位问题、做针对性修改,并运行命令验证改动是否生效;还能并行处理多个文件和搜索,在大型代码库中探索时节省时间。快速原型开发也是受益场景——开发者可以先做出早期版本验证想法,再决定是否投入完整开发。当然,结果仍需人工审查。
在编码之外,Hydrogen 也面向日常知识与业务任务:搭建网站、准备报告、分析文档、整理信息、处理多步骤工作流。营销团队可以用它整理活动数据并生成效果报告,企业主可以用它搭建客户入驻流程。
通过支持的工具和 agent 式工作流,Hydrogen 能参与需要多个动作串联的任务,而不只是在聊天窗口里回答问题。涉及财务信息、客户数据或重要业务决策时,人工复核依然不可省略。
价格与获取方式
Hydrogen 的 API 定价为每百万输入 token 1.50 美元、每百万输出 token 7.50 美元,便于开发者估算应用成本。用户可以通过 Gemini 应用、Google AI Studio、Gemini API 和 Google Anti-Gravity 使用它,其中 Anti-Gravity 访问权限面向符合条件的 AI Pro 和 Ultra 订阅用户开放。
Hydrogen 真正价值最终取决于准确性、可靠性和日常使用成本这三项,而不是发布时的基准数字。它能否成为用户全天候使用的默认模型,还要看实际落地后的表现。
Gemini API 采用按 token 计费的方式,输入与输出分开定价,输出通常显著贵于输入,因为生成过程需要逐 token 自回归计算。按文中价格估算,一次消耗 100 万输入 token 与 10 万输出 token 的调用成本约为 1.50 + 0.75 = 2.25 美元。实际应用中,思考等级越高生成的中间推理 token 越多,成本也随之上升,因此四级思考控制同时是一种成本调控手段。Google AI Studio 适合快速试验与提示词调试,Anti-Gravity 则是其面向开发者提供 agent 式编码工作流的平台。
相关推荐
Gemini 4 Hydrogen实测:谷歌最快最便宜AI模型
谷歌 Gemini 4 Hydrogen 实测:Gemini 4 家族中最快最便宜的模型,解析 Carbon/Argon/Hydrogen 分工、API 定价陷阱、免费层限制与四档思考等级的成本取舍,附真实 bug 调试演示。

Gemini 4 Hydrogen 对比测试:仅耗1%周配额,表现不输Sonnet
实测Gemini 4 Hydrogen与Sonnet完成同一CRUD任务:Hydrogen仅耗1%周配额,表现相当且UI细节更优,而Anthropic模型耗7%。开发者建议日常任务不必迷信高价模型。

Gemini 4 Neon发布:多项基准超越Opus 5.5,谷歌重回第一梯队
谷歌DeepMind发布Gemini 4 Neon,Artificial Analysis智能指数61分排名第三,编程指数登顶第一,多项基准超越Opus 5.5,定价每百万token输入3美元输出15美元,已在Gemini API和AI Studio开放。