冻结大模型+双投影头:医疗选择题的System 1快速推理新基线

冻结语言模型仅训练投影头,用单次前向在医学多选题上达到46%准确率的廉价基线。
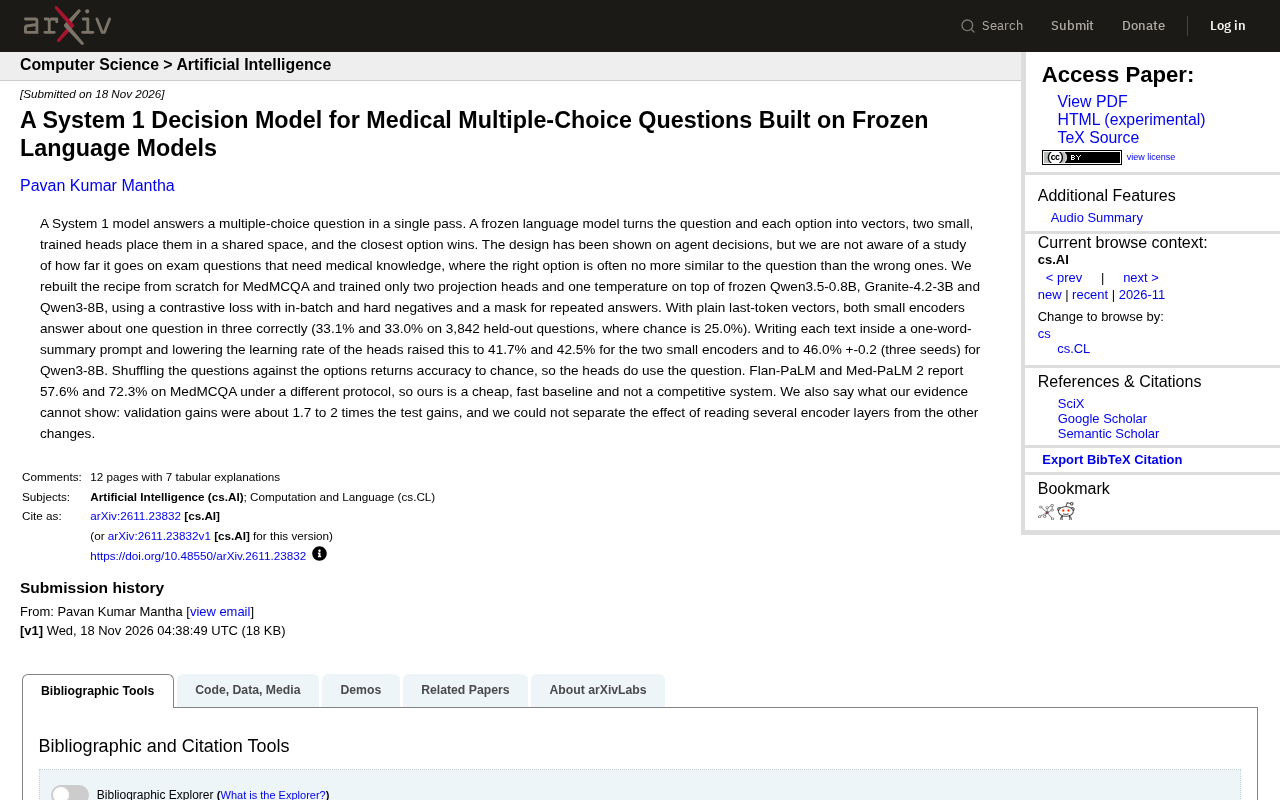
本文介绍了一项来自arXiv的研究,尝试用System 1式「快思考」架构解决医学考试多选题:冻结Qwen3.5-0.8B、Granite-4.2-3B和Qwen3-8B三个编码器,仅训练两个小型投影头和一个可学习温度参数,通过对比损失将问题与选项映射到共享空间,取最近者为答案。在3,842道MedMCQA留出题上,原始末位词元向量准确率约33%,加入「一词总结」提示并降低头学习率后提升至41.7%、42.5%,Qwen3-8B达46.0%。打乱问题与选项配对后准确率回落至随机水平,证明模型确实建立了问题与选项的关联。作者明确将其定位为廉价快速基线,与Med-PaLM 2的72.3%仍有明显差距,并主动披露验证集增益约为测试集1.7至2倍、多层读取效果无法单独归因等局限。
医疗选择题也能「快思考」?
医学考试中的多选题向来是检验模型知识广度的试金石。传统思路依赖大型语言模型进行一次完整的前向推理,成本高、延迟大。一篇来自arXiv的研究提出了一种System 1式的决策模型:冻结语言模型,仅训练两个小型投影头,把问题和选项映射到共享空间,最近者胜出——单次前向即可给出答案。
研究在MedMCQA数据集上从零复现了这套配方,并系统评估了它在需要医学知识的考试题上究竟能走多远。核心动机在于:这类题目中,正确选项与问题的向量相似度往往并不比错误选项更高,单纯依赖表征相似度的「快思考」是否够用?作者在三个冻结模型上做了验证。
System 1 与 System 2 的认知隐喻源自丹尼尔·卡尼曼的双系统理论:System 1 指快速、自动、直觉化的思维,System 2 则对应缓慢、审慎、需要工作记忆参与的分析性推理。在人工智能尤其是大语言模型语境下,这一对概念被借用为架构设计隐喻——System 1 通常指单次前向传播、低延迟、低成本的浅层决策路径;System 2 则指多次采样、链式推理、工具调用或搜索等昂贵但更可靠的推理机制。本文所讨论的「快思考」模型正对应前者:冻结主干、仅训练轻量投影头、一次编码即出答案。这种划分的意义在于,它提示系统设计者可以按任务难度分层部署算力,而不是对所有输入一律调用最重的推理流程。
方法拆解:只训练两个头和一个温度
模型架构极其轻量。冻结的编码器(分别使用Qwen3.5-0.8B、Granite-4.2-3B和Qwen3-8B)将问题和每个选项分别编码为向量。两个小型可训练投影头将两类向量投射到同一空间,再通过一个可学习的温度参数计算相似度,最接近的选项即为预测答案。
训练目标采用对比损失,结合批内负样本与难负样本,并对重复答案施加掩码处理。整个过程中,编码器参数完全冻结,可训练参数量被压缩到极小规模,这使得训练和推理成本都远低于微调整个模型。
易被忽略的细节是提示词设计。研究将每段文本包裹在「一词总结」提示中,并降低投影头的学习率,这两项改动带来了显著提升。
对比损失与批内负样本、难负样本是对比学习中的核心机制。对比损失(contrastive loss)的目标是拉近正样本对在嵌入空间中的距离、推远负样本对的距离。在多项选择设定下,正确选项与问题构成正对,其余选项自然成为负例。批内负样本(in-batch negatives)指同批次内其他样本的正例被复用为当前样本的负例,从而在不增加编码成本的前提下大幅扩充负例数量。难负样本(hard negatives)则指那些与问题相似度高但并非正确答案的选项,它们位于决策边界附近,对训练更具信息量。若只使用随机负例,模型容易学到过于简单的判别边界;引入难负样本可迫使投影头学习更精细的语义区分。本文结合两者并对重复答案施加掩码,是为了避免同一答案因重复出现而被误判为负例,从而污染训练信号。
实验结果:从三分之一到接近一半
在3,842道留出问题上(随机猜测准确率为25.0%),使用原始末位词元向量的两个小型编码器准确率分别为33.1%和33.0%,大致相当于每三道题答对一道。
引入一词总结提示并降低头学习率后,两个小型编码器的准确率提升至41.7%和42.5%,Qwen3-8B达到46.0% ±0.2(三个随机种子)。这一提升幅度说明,即便冻结主干,表征的组织方式对最终决策影响巨大。
为验证投影头确实利用了问题信息,研究将问题与选项打乱配对,准确率随即回落至随机水平。这构成一个干净的控制实验:模型并非在靠选项本身的先验频率取巧,而是真正建立了两侧文本的关联。
与Med-PaLM的差距:定位是廉价基线
作者明确承认,该系统并非竞争性方案。Flan-PaLM和Med-PaLM 2在MedMCQA上按不同协议分别报告57.6%和72.3%的准确率。相比之下,46.0%的最好成绩仍有明显距离,且评估协议并不一致,直接对比需谨慎。
这项工作的价值在于提供一个廉价、快速的基线:冻结主干意味着无需承担大模型微调的开销,单次前向意味着低延迟。对于资源受限的部署场景或需要快速筛选答案的流水线,这种System 1架构具备实用意义。
MedMCQA 与 Med-PaLM 系列是医学问答评测中的两个关键参照。MedMCQA 是源自印度医学入学考试的大规模多项选择题数据集,涵盖解剖学、药理学、病理学等广泛科目,每题通常提供四个选项,因此随机猜测准确率为 25%。该数据集被广泛用作检验模型医学知识覆盖度的基准。Med-PaLM 则是 Google 推出的面向医学领域的语言模型系列,其第一代基于 Flan-PaLM 进行医学指令微调,Med-PaLM 2 进一步引入专家反馈与更精细的对齐策略,在 MedQA、MedMCQA 等基准上报告了显著高于通用模型的成绩。需要注意的是,不同研究在 Few-shot 示例数、选项排列方式、是否使用思维链提示等协议上差异很大,因此跨论文的准确率数字不能直接横向比较,本文作者对此也做了明确提示。
作者自陈的局限
研究对证据边界保持了克制。验证集上的增益约为测试集增益的1.7到2倍,这一差距提示存在一定程度的过拟合或分布偏移,读者不应将验证集数字直接外推到真实考试场景。
另一项未能分离的变量是:读取多个编码器层所带来的效果,与其他改动(提示词、学习率调整)混在一起,无法单独归因。这意味着「多层读取是否关键」这一问题仍悬而未决,后续研究需要设计消融实验加以厘清。
过拟合与分布偏移是解释验证集与测试集增益差距的两个常见原因。过拟合指模型在验证集上反复调参后,其性能估计被乐观偏置,因为验证集信息间接参与了模型选择;分布偏移则指验证集与测试集在题目来源、科目构成或难度分布上存在系统性差异,导致验证集表现无法代表真实场景。本文中验证集增益约为测试集增益的 1.7 到 2 倍,这一比例提示两者可能同时存在:提示词与学习率等超参数是在验证集上选定的,因此验证集数字天然偏高;而留出测试集若在题目类型上与验证集不同,则会进一步拉大差距。审慎的做法是将验证集数字视为上界估计,并在独立同分布测试集上重新评估,或采用交叉验证减少选择偏差。
对医疗AI落地的启示
这项工作折射出一个务实的方向:在医疗问答这类高风险领域,并非所有环节都需要重量级推理。对于格式规整的多选题,轻量的System 1决策层可以作为快速初筛,把复杂推理留给更昂贵的System 2模块。
同时,46.0%这一数字也划出了清晰的能力边界——冻结表征加浅层投影,尚不足以替代具备医学知识的完整推理系统。研究者对自身结论的审慎态度,包括主动披露验证与测试增益差距、承认变量混杂,恰恰是这类基线研究最值得借鉴的部分。
未来值得关注的方向包括:多层特征融合能否缩小与Med-PaLM的差距,以及难负样本挖掘策略在医学领域术语密集的选项上是否还有优化空间。
相关推荐

Gemini 4 Hydrogen 对比测试:仅耗1%周配额,表现不输Sonnet
实测Gemini 4 Hydrogen与Sonnet完成同一CRUD任务:Hydrogen仅耗1%周配额,表现相当且UI细节更优,而Anthropic模型耗7%。开发者建议日常任务不必迷信高价模型。

Gemini 4 Neon发布:多项基准超越Opus 5.5,谷歌重回第一梯队
谷歌DeepMind发布Gemini 4 Neon,Artificial Analysis智能指数61分排名第三,编程指数登顶第一,多项基准超越Opus 5.5,定价每百万token输入3美元输出15美元,已在Gemini API和AI Studio开放。

Gemini 4 Neon评测:跑分直逼Carbon,API性价比解析
Google Gemini 4 Neon 全面评测:跑分直逼 Carbon,API 定价为 Hydrogen 两倍,Antigravity 额度消耗仅一倍而 Carbon 为三倍,实测可替代 90% Carbon 场景。附渠道限制、封号风险与组合策略分析。